画像生成
2026年9月6日
今日の要点
AI生成の料理やメニュー画像が「不味そう」「不自然」に見える科学的理由が話題です。一方、李飛飛氏のWorld Labsは3D世界モデル「Atlas」を発表し、画像生成の次の段階を示しました。画像の違和感は理解されつつも、生成技術は現実世界の再現へと明確に前進しています。
主要ニュース
- 1
AI生成の料理画像が不味く見える理由
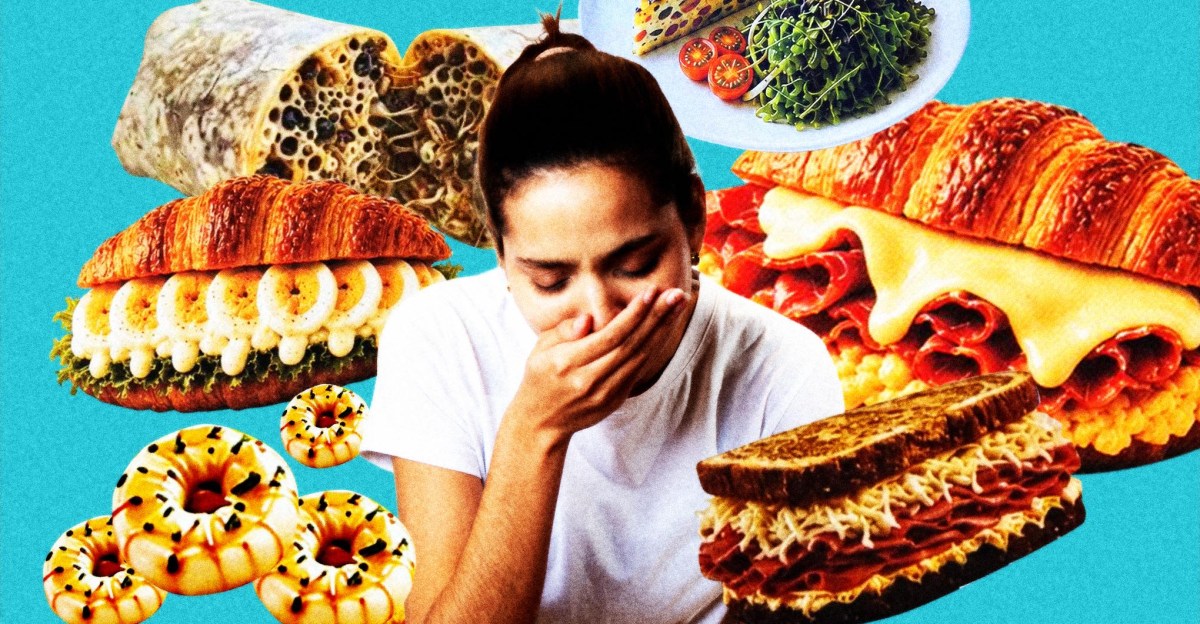
レストランやカフェ、ブランドがAIで料理画像を生成するケースが増えているが、結果は「スロップ」と呼ばれる出来になることも——例えばドーナツ型のエビ、ミミズのような麺、コンクリートを思わせるアイスクリームなどだ。 拡散モデル(ノイズを段階的に除去して画像を生成する)は、まず大まかな構造を復元し、その後で細部を追加する。この過程で初期段階に基本形状が損なわれる可能性がある。また、こうしたモデルは「世界についての正しい知識を持たずに見た目を再現する」ため、サンドイッチやブリトーが実際に何なのかを理解していない。国内で料理画像を扱う飲食店やブランドは、AI生成画像の品質低下に直面する可能性がある。
AIの弱点は「細く、連続し、末端を持つ構造」—例えば麺や巻きひげ状のもの—にあり、「スパゲッティ状のアーティファクト」を生む原因となる。さらに、AI生成コンテンツでの学習を重ねると「モデル崩壊」が起こり、視覚的な劣化や画一化が進む恐れがある。
- 2
AI生成メニューが不自然な理由、科学が解明
レストランのAI生成メニューは、完璧すぎるほど対称的で滑らかな食品を映し出し、客に違和感を与えることが多い。これは、AIモデルが狭い「美しい」美学で訓練されていることに起因する。 デュースブルク・エッセン大学の研究者らは、こうした画像が「不気味の谷」効果を生み、ほぼ実物に近い食品が明らかに偽物の画像よりも不快感を与えることを発見した。均質化が起きるのは、モデルが「心地よさ」と「不快感の回避」を最適化し、「角を削る」ためだ。日本の飲食店が、違和感のあるAI生成メニュー画像を客に不快感を与えるものとして再考する可能性がある。
レストランは客の反発を受け、AIメニューの使用を再考するかもしれない。しかし、この問題は食品にとどまらず、視覚的証拠への信頼にも影響する。Reality DefenderのCTOアレックス・ライル氏は「世界は根本的に変わった。良い意味でも悪い意味でも」と指摘する。
- 3
AI画像に「不気味」な理由、PR専門家が解説
ITmediaの記事が、消費者がAI生成画像を「不気味」と感じる理由を解説。広報の専門家が分析を提供している。 企業やコミュニケーション担当者にとって、この消費者の違和感を理解することは、マーケティングや広報でのAI画像の受け取られ方に影響し、ブランド評価にも関わるため重要だ。国内の広報・マーケ担当者は、AI画像への消費者の違和感を考慮する必要が出てくる可能性がある。
記事は2ページ構成の1ページ目として公開されており、解説は後半に続く。
- 4
李飛飛氏のWorld Labs、3D世界モデル「Atlas」発表
スタンフォード大教授の李飛飛氏が設立したWorld Labsは、テキスト・画像・動画から3D環境を生成・再構築・シミュレーションできるマルチモーダル世界モデル「Atlas」を発表した。 AIを2Dコンテンツから完全な3Dシミュレーションへと押し上げるもので、ロボティクスや没入型アプリケーションにとって重要になり得る。このモデルは、メディアを生成するだけでなく、機械が物理的な空間を理解し相互作用するのを支援するよう設計されている。国内のロボティクス関連企業は、3D環境の理解・生成技術の進展による影響を受ける可能性がある。
李飛飛氏はサンフランシスコで開催されたHumanX Conference 2026でAtlasを紹介し、AIとロボティクスのための空間知能を前進させる役割を強調した。
- 5
Jasper Research、料理本を公開
Jasper Researchが、テキスト画像生成モデルをゼロから構築する方法を解説する料理本を公開し、全推論プロセスと途中結果を共有した。 この料理本は、テキスト画像生成モデルの深掘りや、フロンティアラボの構築手法を学ぶのに理想的とされ、高度なプロセスを幅広い層に身近なものにしている。国内のAI開発者は、大規模な学習資源の一部を自作で再現できる可能性がある。
リリースには1億枚の画像データセットと、小型モデルを含むコードベースも含まれており、読者は自分でゼロからテキスト画像生成モデルを訓練できる。
- 6
AWSダッシュボード障害検知を72時間から1時間に短縮
AWSチームがAI搭載のコンテンツ検証システムを構築し、AWS Insightsアプリケーション(Amazon Quickに搭載)の数百のダッシュボードをスキャンして、欠落や誤った要素を検出する。Anthropic ClaudeモデルをAmazon Bedrock上で使用し、スクリーンショットを視覚的に分析して、問題が見つかるとSlackで所有者に警告する。 従来のモニタリングでは、ユーザーが見る画面にだけ現れるサイレント障害(空白のチャートや誤った数値など)を見逃すことがある。30日間で、システムは802件のコンテンツ障害を検出し、ユーザー報告があったのは1%未満だった。このソリューションにより、平均検出時間を最大72時間から1時間未満に短縮した。国内のAWS利用企業では、自社ダッシュボードの不具合検出が同様に迅速化される可能性がある。
システムは2つの並行検証方法を使用する。1つは視覚的整合性、もう1つは数値的一貫性である。視覚的障害が確認されると、影響を受けるセクション名、スクリーンショット、AI信頼スコア、モニタリングダッシュボードへのリンクを含むSlack通知が所有者に送信される。
今後の注目点
次回は、画像生成の信頼性を左右する「細部の破綻」と「学習データの循環」への対策、そして空間知能や公開データセットによる開発の民主化が、生成結果の品質と社会実装の行方を左右する動向に注目です。
情報ソース
- Why AI food looks like that
- The sameness problem behind those unappetizing AI-generated menus
- 生成AI画像はなぜ“キショい”のか 消費者が抱く違和感の正体 広報のプロが解説(1/2 ページ)
- Fei-Fei Li's World Labs unveils Atlas world model for 3D AI and robotics
- Detailed explanation of how to create a text-to-image model from scratch. [R]
- How an AWS team detects dashboard content failures at scale using Amazon Bedrock
- World Labs unveils Atlas, a single AI model that generates, reconstructs, and simulates 3D worlds from just a few photos
- フェイフェイ・リー氏のWorld Labs、空間知能オムニモデル「Atlas」発表 少数の画像から3D空間やバレットタイム映像を生成
- Fei-Fei Li’s World Labs debuts Atlas, a world model showcase for advanced spatial intelligence
- Google、AI画像生成・編集ツール「Google Pics」提供開始 特定オブジェクトの編集や文字翻訳も可能
- Claude Fable 5.1 made me a really nice animated pelican
- Google Pics is like Canva, but with even more AI
- Google’s answer to Canva is an AI tool where you prompt instead of design
- 生成AI画像はなぜ“キショい”のか 消費者が抱く違和感の正体 広報のプロが解説
- The $3.4m Disney auction is a reminder of what AI concept art takes from us
- From 5-Digit Recognition to Water Meter Reading with ESP32-P4
このニュースを友達にシェア
気になりそうな人に、今日のまとめをそのまま送れます。
AITodayで毎日のAIニュースを無料で受け取る
今日のAIを、今日の仕事に。Email / LINE / Slack 配信。
無料で登録する