画像生成
2026年8月21日
今日の要点
AI画像生成技術の開発企業Higgsfieldが4億ドルの資金調達で企業価値54億ドルに達する一方で、MIT研究により生成画像の学習元追跡が困難であることが判明し、著作権保護の課題が浮き彫りになっています。一方でマーケティング現場ではコカ・コーラのAI広告批判のように人間制作の作品が好まれる傾向が示されており、AI生成画像は技術的・社会的な制限に直面しています。
主要ニュース
- 1
MIT研究:AI生成画像は学習元を追跡不可能
MITのコンピュータサイエンス・人工知能研究所の研究者らが、大規模データセットで学習した生成AIモデルは、学習データ内の個別画像に確実に遡及できないことを発見した。彼らはこの現象を「帰属減衰」と呼んでいる。モデルの学習データが多いほど、特定のアーティストの全作品を学習セットから削除したとしても、生成画像を特定の出所にリンクさせることがより困難になる。 この発見は著作権執行を複雑にしている。MidJourney、OpenAI、Microsoftを含むAI企業は、しばしば著者の許可なしに、書籍、記事、写真その他の作品を使用してモデルを学習させており、Disney、NBCUniversal、DreamWorks、The New York Timesから訴訟が提起されている。この研究の筆頭著者であるZheng Dai(元MIT研究者)は、帰属リンクを確立できないことが知的財産法とフェアユース政策の再考を強いるかもしれないと指摘している。「帰属リンクはいわば消滅する」とし、法廷での侵害立証をより困難にするという。
法的な含意である。現在進行中の著作権事件は、帰属減衰が大規模生成モデルの基本的な特性であることを裁判所が認めるかどうかにかかっており、AIの学習慣行に対する知的財産請求がどのように評価されるかを大きく変える可能性がある。
- 2
AI生成画像、学習データへの追跡が困難—研究で判明
AI生成画像を検証した研究によると、多くの画像について、研究者が詳細な分析を試みても、元の学習データソースへの確実な追跡ができないことが明らかになった。 この発見はAI画像生成における帰属と責任の問題を提起する。生成画像を特定の学習ソースにリンクさせられなければ、著作権侵害の特定、元の制作者の同意確認、AIシステムが生成するコンテンツの責任の明確化が難しくなる。AI生成画像の学習データ追跡の困難さにより、国内でAI画像生成サービスを利用する企業は、著作権侵害の責任が曖昧になるリスクに直面する可能性があります。
画像生成を使用するAI開発企業とプラットフォームへの影響。法的・倫理的圧力により、追跡可能性の仕組みの改善や、生成コンテンツと学習元の結びつきを確立するための新たなセーフガードの導入を迫られる可能性がある。
- 3
Higgsfield、4億ドル調達で評価額54億ドル
動画・画像・音声生成のAIプラットフォーム Higgsfield が、DST Global 主導のシリーズB資金調達で4億ドル を獲得し、1月以来の評価額を4倍に高める54億ドル に到達した。 同社は238カ国・地域で3,000万人以上のユーザーを抱え、Fortune 500の360社を含む企業需要の強さを示している。エージェント型AIツール(人間の継続的な指示なしにワークフローを自動実行するツール)が主要なドライバーになっており、Higgsfield が5月に Supercomputer をリリースした後の3カ月でプラットフォームのツール使用が42倍に跳ね上がった。
Higgsfield の自律型エージェント機能とキャラクター・シーン生成の一貫性が、企業のコンテンツ制作スケーリング戦略を塗り替える可能性がある。Supercomputer リリース後、同社は月間2,000万件以上のコンテンツ生成を報告している。
- 4
Twitch配信者、Amazon AI学習をオプトアウト
Twitchがセキュリティとプライバシー設定にトグルを追加し、配信者は自分のコンテンツ(ライブ配信、VOD、クリップ、チャット、チャンネルのテキストと画像)をAmazonの生成AI モデルの学習に使用させないようにできるようになった。このトグルは発見時点でデフォルトで「オン」に設定されていた。 自分のコンテンツがAmazonのテキスト、音声、画像、動画生成モデルの学習に使われることに不安を感じている配信者は、その使用を防ぐことができるようになった。キャプションやセーフティツールなど、他のAI対応Twitch機能はオプトアウトの影響を受けない。このような動きにより、配信者は自分のコンテンツの特定の用途をコントロールできるようになるが、オプトアウトしてもAmazonとTwitchがTwitchのプライバシー通知に記載されている他の目的でコンテンツを使用することは阻止できない。
このトグルはTwitchの設定のセキュリティとプライバシータブで利用可能になった。重要な点として、配信者が他のユーザーのストリーム内のチャットに参加する場合、そのチャットを学習に使用できるかどうかはチャンネルオーナーのオプトアウト設定によって決定される。個々の配信者は他のチャンネルで参加したチャットを一方的に保護することはできない。
- 5
コカ・コーラのAI広告批判が示す、人間が制作した作品がマーケティングで優位に立つ可能性
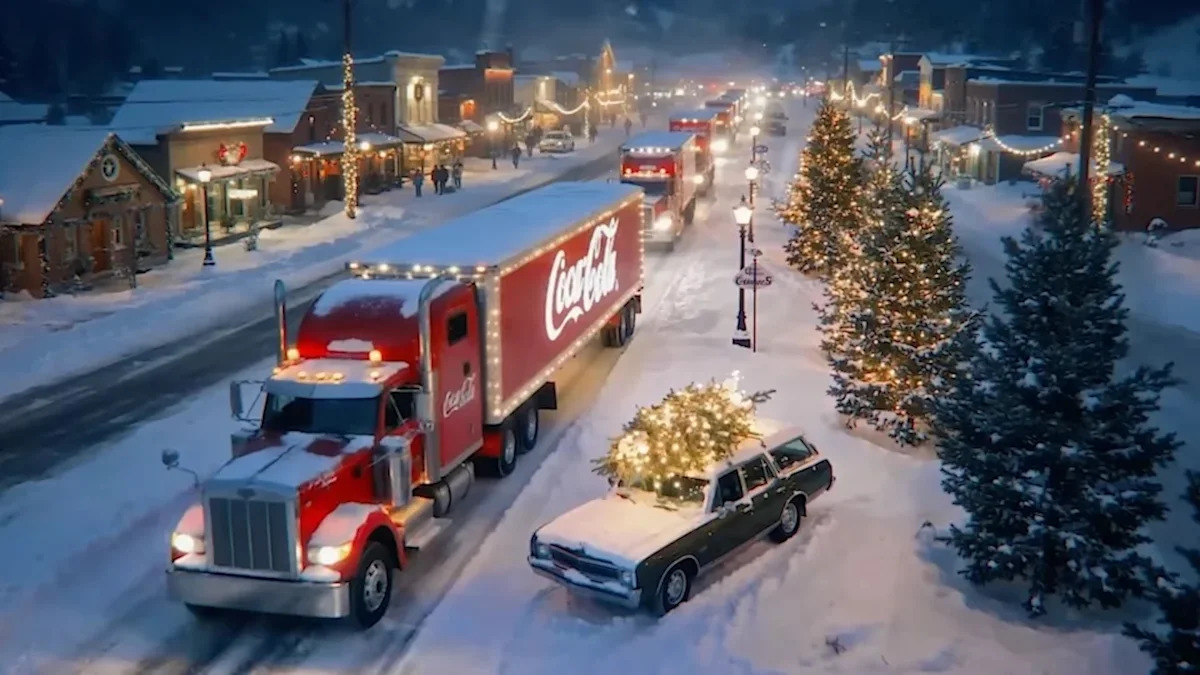
コカ・コーラは2024年後半、1995年のキャンペーンを模した完全なAI生成の年末広告をリリースして消費者の批判を浴びた。同様にValentinoも2025年後半、Instagramで全くのAI製ハンドバッグキャンペーンを展開し、「安っぽい」「怠け者だ」とのコメントが寄せられた。この流れが人間による制作を対抗トレンドとしてのマーケティング手法として注目させている。 調査によると北米の消費者の43%が、品質が低い、または「不気味な」AI広告はブランドに対する意見を害すると答えており、広告研究ジャーナルの研究では、ラグジュアリーブランドがAI生成画像を開示した場合、消費者の反応はより否定的になることが判明している。なぜなら、その作品が労力をかけていないように見え、ブランドの信頼性が損なわれるからだ。信頼と真正性が企業のプレミアム価格設定の正当性の中心であるため、AI生成コンテンツは企業が売ろうとしているブランドイメージを損なうリスクがある。
ピュー・リサーチセンターは、アメリカ人の53%がAIは独立した創造的思考をもつ能力を侵食すると考えており、アメリカ人の半数がAIの台頭は興奮よりも懸念をもたらすと報告している。日常生活の自動化に対する消費者の懐疑心が今後もブランド戦略を形作る可能性を示唆している。
- 6
Adobe Firefly、AI音声ツールを投入し Google の Gemini Omni Flash を追加
Adobe は Firefly プラットフォーム全体で、Generate Music(動画向けロイヤリティフリー音楽)、Generate Speech(スクリプトからボイスオーバーへの変換)、Generate Sound Effects(シーン音声)の3つのAI音声ツールをリリースし、すべて商用利用が可認されている。Firefly AI Assistant は無料で毎日の生成を提供するようになり、Adobe は動画、音声、画像、テキストを受け入れることができる Google の Gemini Omni Flash モデルを統合した。既存の Kling AI、Luma AI、Runway との連携も続く。 音声ツールは Firefly の創作スイートをテキストと画像生成の先へ広げ、クリエイターが単一プラットフォーム内で動画サウンドトラックとボイスオーバーを製作でき、ライセンス上の懸念がなくなる。Gemini Omni Flash のマルチモーダル入力(動画、音声、画像、テキスト)により、Firefly が対応できる創作タスクの範囲が広がり、コンテンツプロデューサーのワークフロー効率化につながる可能性がある。
Adobe は「Create Storyboard」と「Create Brand Kit」が最も利用されている Firefly 機能だと報告しており、統合型創作ツールへの需要が示唆されている。音声ツールの採用状況は、ユーザーがこれらの機能を同程度の割合で採用するかどうかを示す指標となる。
今後の注目点
今後注視すべき点は、進行中の著作権訴訟が大規模生成モデルの学習慣行をどう評価するかで、AI企業への法的・倫理的圧力がトレーサビリティの強化やセーフガード導入につながる可能性があることです。一方、Higgsfieldの自律型エージェント機能やAdobe Fireflyのような統合型創作ツールの成長、そして消費者調査に示される懐疑心が、今後のコンテンツ制作スケーリングと企業のブランド戦略を大きく形作ることになるでしょう。
情報ソース
- After Coca-Cola's AI commercial backlash, human-made ads may carry more appeal than AI-generated content
- Adobe Firefly adds AI audio tools and Google's Gemini Omni Flash
- Gen AI outputs are unattributable, study finds
- When AI art has no author: Study finds generated images often can’t be traced to training data
- I built pagedMark to remove AI provenance from images and video you generated yourself
- Trained an diffusion model that runs on 264KB of RAM [P]
- ByteDance and Hollywood reach copyright pact for AI video and image tools
- Whisker’s AI-powered litter robot thinks my cats swapped bodies
- Higgsfield raises $400M at $5.4 billion valuation to scale video and image generation platform
- AI-generated wildlife images are endangering animals and people, experts warn
- Valentino and Coca-Cola faced fierce backlash over AI-generated ads — now human-made is becoming the new luxury
- Building text to ASCII diffusion model , need advice and guidance [P]
- Reproducible canvas-aligned low-level patterns in somerandomllm-generated images and their possible relation to iterative editing artifacts [D]
- Canva was the rare startup that grew fast and made money—then AI costs slashed its growth forecast by a third
- Twitch streamers can now opt out from training Amazon’s AI
- LTX-2.5 can generate a 10-second AI video from an image in just 6.8 seconds on Nvidia superchips — and it's open weights
このニュースを友達にシェア
気になりそうな人に、今日のまとめをそのまま送れます。
AITodayで毎日のAIニュースを無料で受け取る
今日のAIを、今日の仕事に。Email / LINE / Slack 配信。
無料で登録する