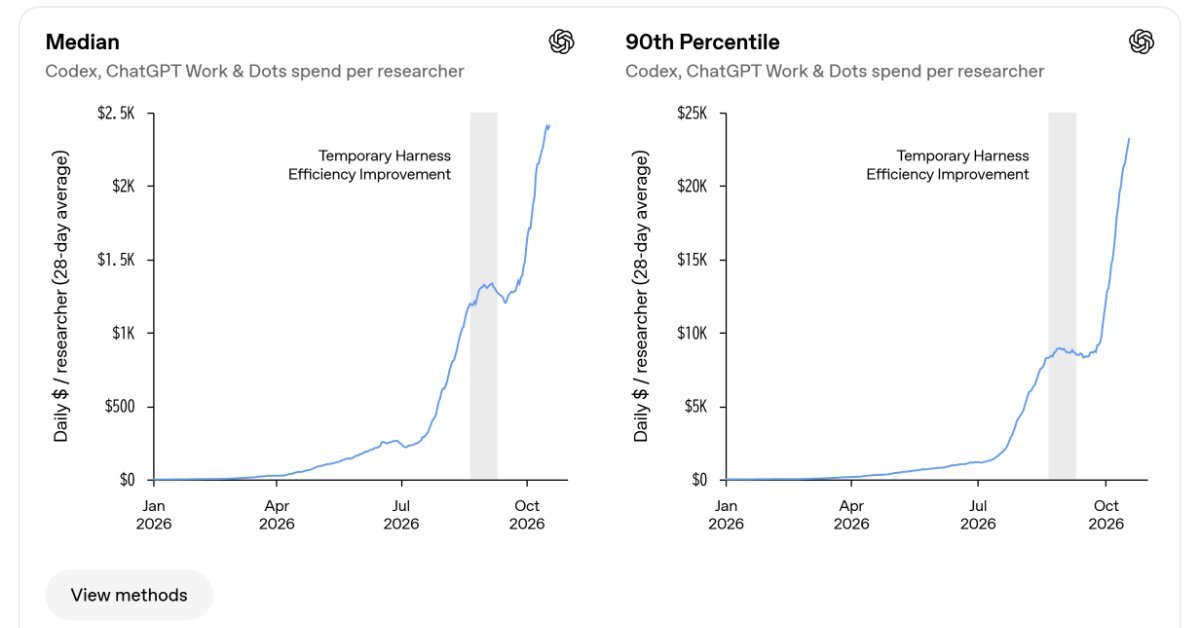
何が起きたか
OpenAIによると、コーディングエージェントが2〜4時間の研究タスクを人手なしで完了する割合は46%に達し、3月の23%から上昇。4〜8時間のタスクは13%から35%に伸びた。
なぜ重要か
日常的な研究業務のかなりの部分をエージェントが担える可能性を示すが、OpenAI自身はタスクの種類によって進歩にばらつきがあると強調している。
誰に効くか最も明確な恩恵を受けているのはOpenAI自身の研究スタッフで、10月の1日あたりのエージェント利用額の中央値は$2,400と評価され、3分の2以上が1日のピーク時に平均4体以上のエージェントを使っている。他のAIラボや研究チームは、研究開発の現場でコーディングエージェントがどこまで進めるかを示す兆候として、これらの社内データを注視するかもしれない。
こういう要約が、毎朝あなたのメールに届きます。
「Research acceleration: The jagged frontier」と題され11月18日に公開されたOpenAIの投稿は、8月1日から10月18日までの測定に基づいて結論を導いている。モデル訓練実行の監視で79%の成功率、推論・サービングスタックのコード作成で25%という差は、同社がこのフロンティアを「ギザギザ」と表現する理由を示している。エージェントは研究業務の一部の領域では信頼できるが、他の領域でははるかに信頼性が低い。4〜8時間のタスク完了率も13%から35%に改善しており、短いタスクより水準は低いものの、エージェントがより長い時間軸の業務へ広がりつつあることを示唆する。
能力の向上と並行して、社内での導入も深まっているようだ。研究者の1日あたりのエージェント利用額の中央値は10月に$2,400と評価され、9月から62%急増、90パーセンタイルは$23,000に達した。同社によると、研究者の3分の2以上が1日のピーク時に平均4体以上のエージェントを使い、10%以上が平均16体以上を使った。研究スタッフ101人への調査では、GPT-5.2より優れたコーディングエージェントへのアクセスを3か月失うという仮定の状況が示され、取り戻すために対価として支払う中央値はチームの計算資源の30%またはチーム人数の40%だった。別途、Safety and Alignmentは、あらゆる研究領域の中で文書化された研究者の週作業量の絶対増加が最大で、1月から9月にかけて77%増えた。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
11月19日のarXiv論文で、ICLRの批判重複率が2026年の12.0%から2027年は21.3%に上昇し、LLM使用と判定されたレビューは非判定より4.5ポイント高かった

Technion、University of Haifa、Google Researchの研究者がAltRA-Testを公開
フィードは2026年11月17日、AI調査、質問設計、ページ書き換え、構造化データやllms.txtの技術実装、流入と問い合わせの計測までを担う「マルゴトLLMO」の提供を開始した
Co-Labo AIが2026年11月20日、製造業の管理職・経営層向けにオントロジー解説全3回の初回を公開した

AWS AIプラクティショナー試験のタスク1.2対策として、入力が画像・動画ならCV、テキストならNLP、数値の推移なら時系列予測という3つの見分け軸と、キーワード別の早見表が公開された
物理科学・生命科学・工学の52の実験課題で、Claude Fable 5.2が13エージェント中首位の45.0、Claude Opus 5.5が40.2、GPT-6.1-solが31.7だった

