何が起きたか
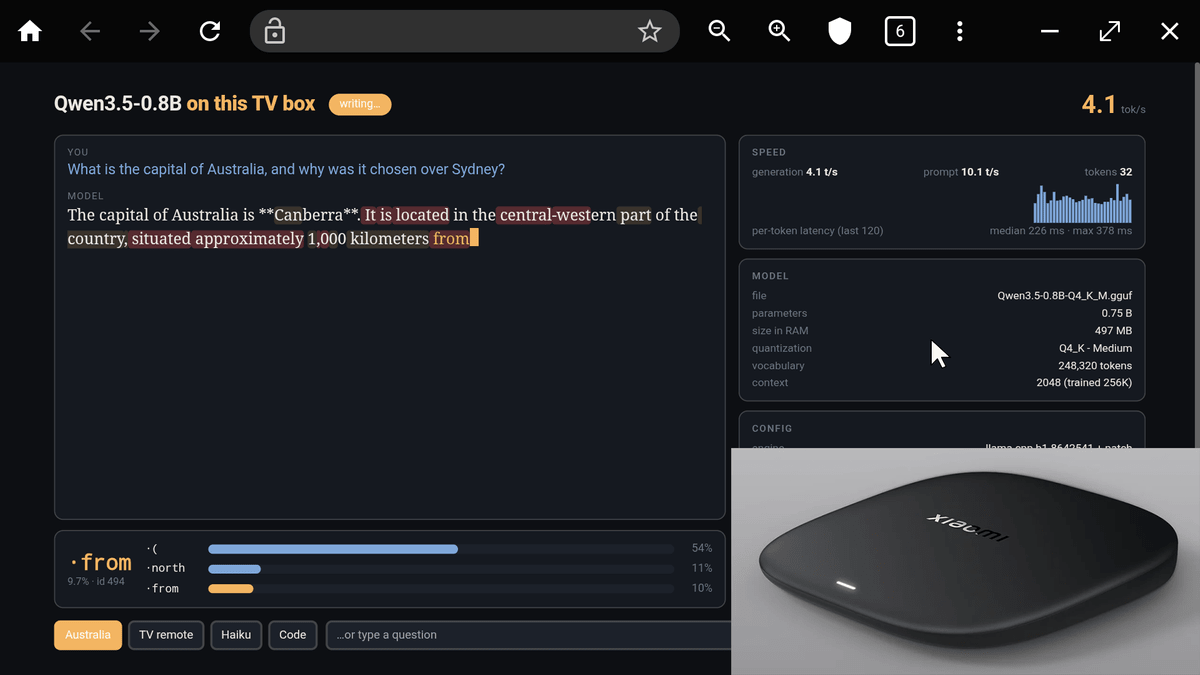
llama.cppを改修したオープンソース「smolmaxxing」がGitHubで無料公開され、メモリ1.9GBのXiaomi TV Box S(第3世代)でLing-mini-2.0(160億パラメータ)が毎秒5.1トークンで動くことを確認した。
なぜ重要か
よく使うデータをメモリに置き残りをストレージから読み込むことで、メモリの乏しい機器でも大規模モデルをローカル実行できる。
誰に効くか古いタブレットやTVボックスなどメモリの少ない機器でAIモデルをオフライン実行したい開発者や愛好家に無料の選択肢が加わる。ただし初代iPad Airで動かすにはiOSの脱獄が必要だ。
こういう要約が、毎朝あなたのメールに届きます。
ローカルAI、つまりクラウドではなく端末上で直接モデルを動かす手法には、ネット接続なしで動くという明快な利点がある。難点はメモリだ。高性能なモデルほど多くのメモリを要求するため、古いスマートフォンやタブレットは対象外になる。
smolmaxxingは、ローカルAIで広く使われるソフトウェアllama.cppを土台に、小型端末向けの調整を加えるアプローチを取る。Hacker Newsの投稿によると、開発者の実験は約160回にわたり、Xiaomi TV Box S上で20億パラメータのQwen3.5-2Bと160億パラメータのLing-mini-2.0を組み合わせた。結果はモデルの規模だけでなくアーキテクチャも重要であることを示す。90億パラメータのQwen3.5-9Bは同じ端末で毎秒0.27トークンしか出ず、開発者は速度と品質のバランスに優れるのはQwen3.5-2Bだとしている。
プロジェクトはGitHubで無料公開され、モデルはHugging Faceで提供される。開発者はスマートフォンやルーターなど更多の端末への対応拡大を目指すとしており、実現すればAIをローカルで動かせるハードウェアの幅が広がる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
FlashLabsがOrcaRouterゲートウェイのTrace Exportを強化し、SDKやコード変更なしでAIリクエストのトレースをGrafana、Datadog、Langfuse、LangSmithへリアルタイム…

KivaのSamurai Appに、ヤマト運輸「ビジネスメンバーズ」の顧客コードへログインし運賃と請求金額を取得、複数コード・複数月の運賃CSVを一括ダウンロードできるAPI連携を追加
Notion LabsのCISOデイビッド・ツァオ氏は、11月2日のFireworks AIへの不正アクセスでNotion AI Insightsのチャット記録が流出した可能性を受け、11月12日に影響を受けた日本顧客へ…
川崎重工業は11月16日、神戸須磨シーワールドでAIカメラによる実証実験を行うと発表した
SwitchBotはスマートリモコン「Hub 4」の予約販売を11月18日に19,980円で開始した
CodeRabbitはOpenAI Daybreak Defense Networkに参加した