何が起きたか
Appleは本日MLXをリリースした。816BパラメータのMuse Spark Openを4台のMac Studioで毎秒36トークン超で実行でき、平均的な人間の読解速度を大きく上回る。
なぜ重要か
Appleによれば、AI研究者はクラウドサービスに頼らず、プライベートな環境でフロンティア級モデルをローカル実行できるようになる。
注目点
Muse Spark Openのデコード速度は、テンソル並列化を用いた4台のM5 Ultra搭載機で毎秒36.73トークン。
誰に効くかフロンティアモデルをプライベートな環境でローカルに試したいAI研究者や開発者は、Appleによれば自分のハードウェアでMuse Spark Openを実行できるようになる。
こういう要約が、毎朝あなたのメールに届きます。
AppleのMLXは、Appleシリコンのユニファイドメモリ構造を活用するオープンソースの配列フレームワークで、研究者が自分のハードウェアで推論やファインチューニング手法を実行できるようにする。本記事でAppleは、本日リリースされた最新版のMLXが、パラメータ数がほぼ1兆に達するフロンティア級モデルMuse Spark Openを4台のMac Studioのクラスタ上で実行し、毎秒36トークン超を生成する様子を示している。
記事ではMac Studio上で3つのフロンティア級モデルをベンチマークしている。Muse Spark Open(816B)、Mistral Medium 3.5(128B)、Qwen 3.8(27B)だ。Muse Spark Openは専門家混合モデルで、一部の専門家のみを有効に保ち推論時の計算量を削減する。評価はNVFP4精度で行われる。より小さいQwenとMistralのモデルは512GBのRAMを搭載した単一のMac Studioに余裕を持って収まるが、Muse Spark Openはネイティブ精度ではモデルパラメータだけで1.6TB超のRAMを必要とするため、複数のMac Studioにまたがる並列化が必要になる。
Appleは大規模モデルを分割する2つの手法を説明している。深さ方向に分割するパイプライン並列化と、幅方向に分割するテンソル並列化だ。これらはマシン間の高速通信に依存しており、macOS 26.2ではThunderbolt 5経由の低遅延RDMAドライバが導入され、MLXはこれを基盤としてjacclと呼ばれる新しい通信集団通信を提供する。Appleはまた、Mac StudioがLLM推論においてエネルギー効率が良く、ピーク消費電力がM3 Ultraで約200W、M5 Ultraで約300Wだと指摘している。これは一般的なトースターの消費電力の一部にすぎない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
MetaがMuse Spark Openの重みを公開
EC自動化工房がZenn記事で商品マスタ生成前クレンジング手順を示した

Claude Codeへの一言の依頼3回と完了条件付きの依頼3回では機能的に同一のMyntPackコードが生成されたが、後者では各回テストが3〜5本追加され、3回とも最後にlintを1回実行した
BlueskyのAttieは、今年当初にカスタムフィードを作るために立ち上げられたが、今ではプロンプトからゲームや投票、ダッシュボードといった「小さな」ソーシャルアプリを生成する
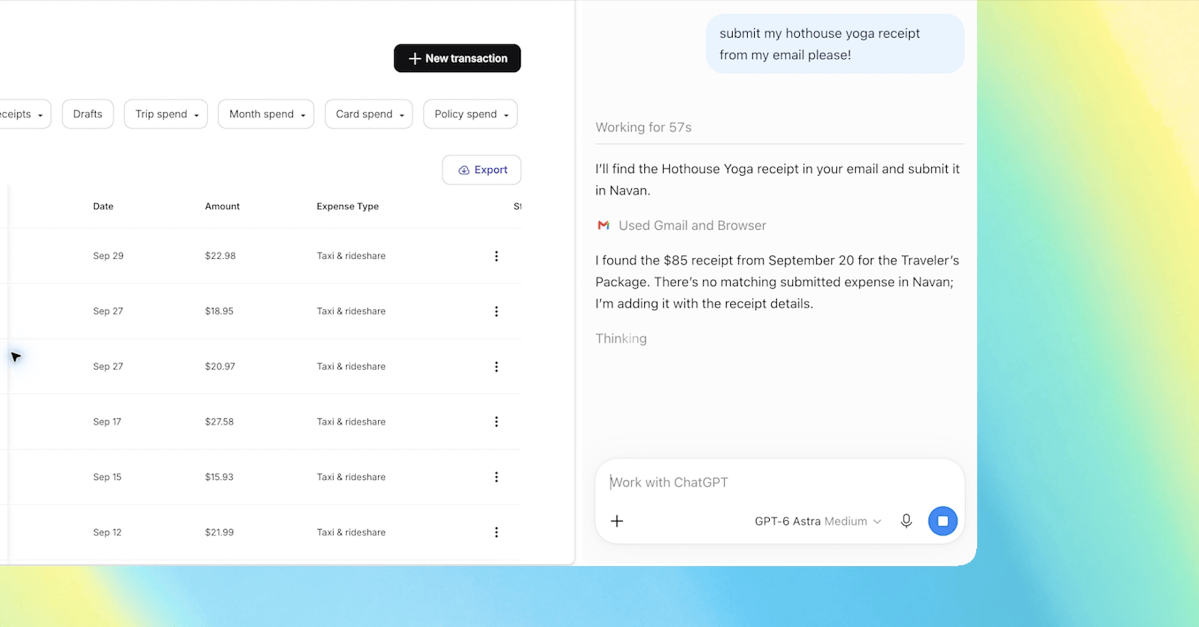
OpenAIは、ChatGPTのChrome拡張機能でChromeをタグ付けすると開いているタブを閲覧でき、ChatGPT Workはタブを操作できると発表した
OpenAIはRosalind Academic Planを発表