何が起きたか
NTTは、少数の社内マニュアルからLLMがFAQ・表・対話形式の学習教材を生成する手法を発表。tsuzumi 2で83.1%と、従来手法を約10ポイント上回った。
なぜ重要か
同じ少量の原資料から多様な教材を作るため、従来のチューニングに必要な大規模データなしで専門知識を定着できるとNTTは説明。Llama 3でも確認済みという。
注目点
結果は11月18〜25日開催のNTT R&D FORUM 2026で公開される。
誰に効くか医療・金融・製造など、独自ルールや専門用語が厳しく、社内マニュアルを限られた量しか持たない企業のチームでも、数十ギガバイトの学習データを用意せずにモデルを専門化できる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
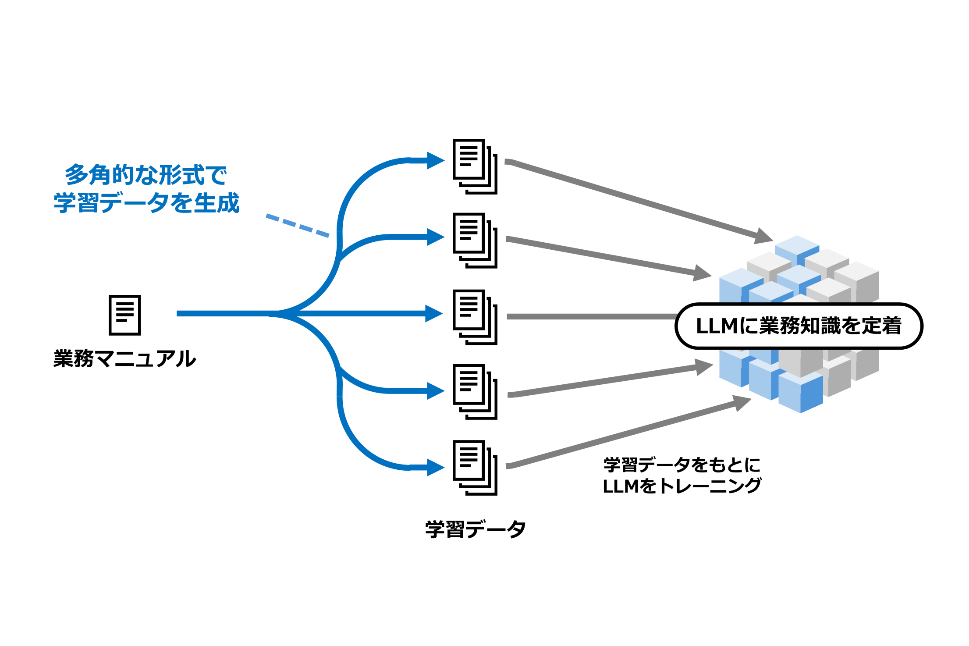
NTTは課題をデータ量の問題として捉えている。企業固有の知識を定着させる従来のチューニングは数十ギガバイトのデータを要するとされ、一方で個々の企業の業務文書は最大約100ページのPDF約1,000冊分にとどまり、標準的な学習には到底足りない。同じ資料を単純に繰り返すと、特定の表現や条文番号に過適合し、言い回しの違う質問に答えられなくなる。オープンウェブから類似資料を集めるとノイズが混入しやすいという。
この手法は人が学ぶ仕方を取り入れている。同じ文章を読み返す代わりに、モデル自身が教材作成者として、業務での知識の使われ方を想定したFAQ・表・対話形式のデータを生成する。NTTによれば、この生成エンジンを動かすのはtsuzumi自身で、小さな種データを数十億〜数百億トークンの学習データに拡張する。ベンチマークでは、FinePhraseなど従来の言い換えベース手法が最大73.3%だったのに対し、新手法は83.1%を記録。専門知識を注入しても汎用領域の能力は低下しなかったとNTTは報告する。
NTTはこの手法を検索拡張生成(RAG)の代替ではなく、併用する位置づけとしている。絶対的な精度を優先する場面ではRAGが推奨される一方、コールセンター音声のリアルタイム解析のように外部検索が遅延やGPUコストを増やす高速処理では、モデルへの知識定着が適するという。NTTはグループのソリューションに組み込む計画で、自社データセンターでチューニングを実行しカスタマイズ済みモデルを返すマネージドサービスも検討中。NTT R&D FORUM 2026では、日々の文書からモデルが自律的に知識グラフを構築・更新して再学習する「自己進化型tsuzumi」構想も披露する。NTTはこれを、日本の企業データ環境に適応した再帰的自己改善への一歩と位置づける。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
匠技研工業は、取締役CBO原崇文氏が12月9〜10日に東京国際フォーラムで開催される「イプロスAI-産業World 2026」で「図面を渡すとAIが引合見積を作る」と題したセッションに登壇すると発表した
約8年のエンジニア経験(うちAI開発約3年)を持つ筆者は、競馬予測モデルは1つのツールに絞るよりCursor・Claude Code・OpenAI Codexで役割を分けるのが最適だと結論付けた
Meta HeroesがHERO AIVOを発表
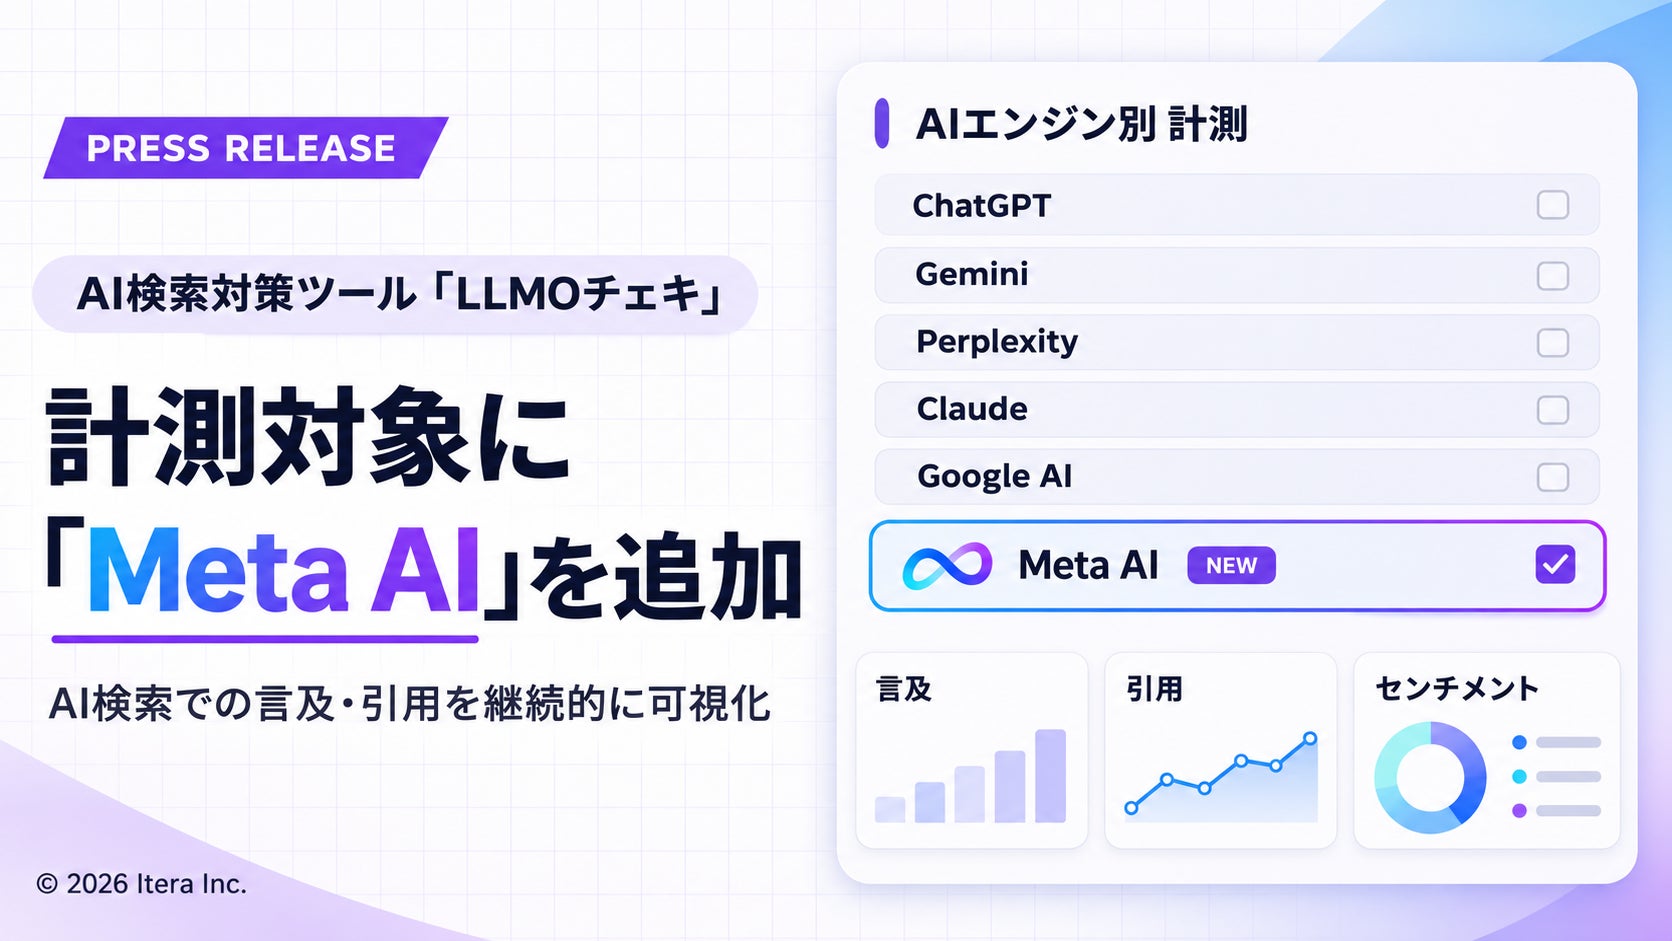
Iteraは2026年11月11日、AI回答でのブランド露出を追跡するツール「LLMOチェキ」にMeta AIを追加した
Notion Labsは11月9日、Fireworks.aiへの不正アクセスでNotion AIのInsights機能のチャット記録が漏えいの可能性があると発表
日本時間11月11日から、MetaのパーソナルAIエージェントMuseに専用の@muse.aiアドレスを割り当て可能に