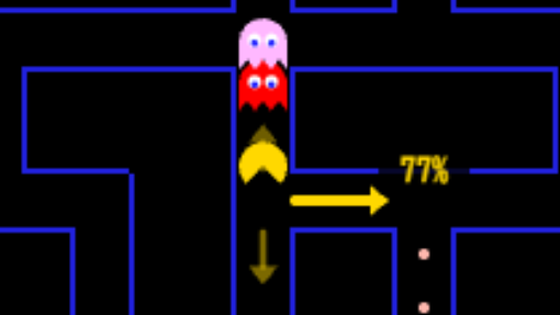
Opperは、JevやGPT-6 Luna Decisionsを含む6つのAIモデルをパックマンで各100回プレイさせ、スコア等で順位付けするベンチマーク「jevman」を公開した。
こういう要約が、毎朝あなたのメールに届きます。
米国企業TypeSafe AIが開発したJevは、チャットボットを支える大規模言語モデルとは異なる系統に属する。文章を書く代わりに、確率的意思決定モデルは与えられた情報を受け取り、あらかじめ設定された選択肢——例えば顧客の問い合わせが返品か、技術的問題か、その他か——それぞれの確率を返す。説明文を生成する必要がないため、このタイプのモデルは素早い判断が求められる場面に適している。
ベンチマークのルールはその重視点を反映している。残機が3つすべて失われるか5分が経過するとゲーム終了となり、AIは迷路の配置、ドットの位置、ゴーストの位置をJSONで受け取ってから上下左右の中から選ぶ。モデルが2秒以内に答えられない場合、単純な代替アルゴリズムが方向を選び、その置き換えはカウントされる——つまりモデルのスコアは判断力だけでなく応答性も反映する。
ゲームは従来のパックマンと同じルールに従うゴーストと対戦し、正解にたどり着くまで考えるのに時間がかかるモデルは上位に入れない可能性がある。OpperはKev、Laya、Clef、GPT-6 Luna Decisionsを含む複数のモデルを同じゲーム環境内で比較できるようにもしており、公式サイトではAIのプレイを観戦したり、自分でパックマンを操作してモデルと対戦したりできる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
AnthropicはClaudeモデル、オンサイトエンジニア、脅威リサーチを提供するAnthropic Cyber Missionを始動
OpenAIのDecisions APIでgpt-6-lunaを使い「おもちゃが見えるか」「左か中央か右か」に答えるパイプラインを構築しSO-101アームを動かした
Claude Codeを4時間おきに無人起動し、各作業場のgit statusで未commitの変更を持ち主別に分け、完成ならcommit、壊れていればgit restoreで戻す

SKILL.mdは6月17日から2,116バイト(1.2.0)のまま更新されず、20:05のTelegramリクエストで20:08までに1.3.0、4,513バイトが生成された
OpenAIはロシアの「Dark Clark」作戦関与アカウントを無効化と発表
Sakana AIは10月9日、日本仕様のLLM「Sakana Namazu」が、医療AI企業Irisの医師向けエビデンス検索ツール「Evidence Finder」に採用されたと発表した