何が起きたか
Liquid AIはLFM3-1.7B-Baseを基にした6つの2B級オープンウェイトモデル群LFM3を公開。テキスト、視覚、音声、オムニ、意思決定タスクに対応。
なぜ重要か
各モデルは単一GPUでファインチューニングでき、企業は自社データで適応させて端末やプライベート基盤で動かせる。汎用の大規模モデルは特定用途の専門家とは限らないと発表は指摘する。
誰に効くか端末上やプライベートなAIを構築するチーム、すなわちロボティクス開発者やサポート・文書処理チーム、音声インターフェースの開発者は、単一GPUでファインチューニングでき、アプリが動く場所に導入できる小規模モデル群を手に入れる。
こういう要約が、毎朝あなたのメールに届きます。
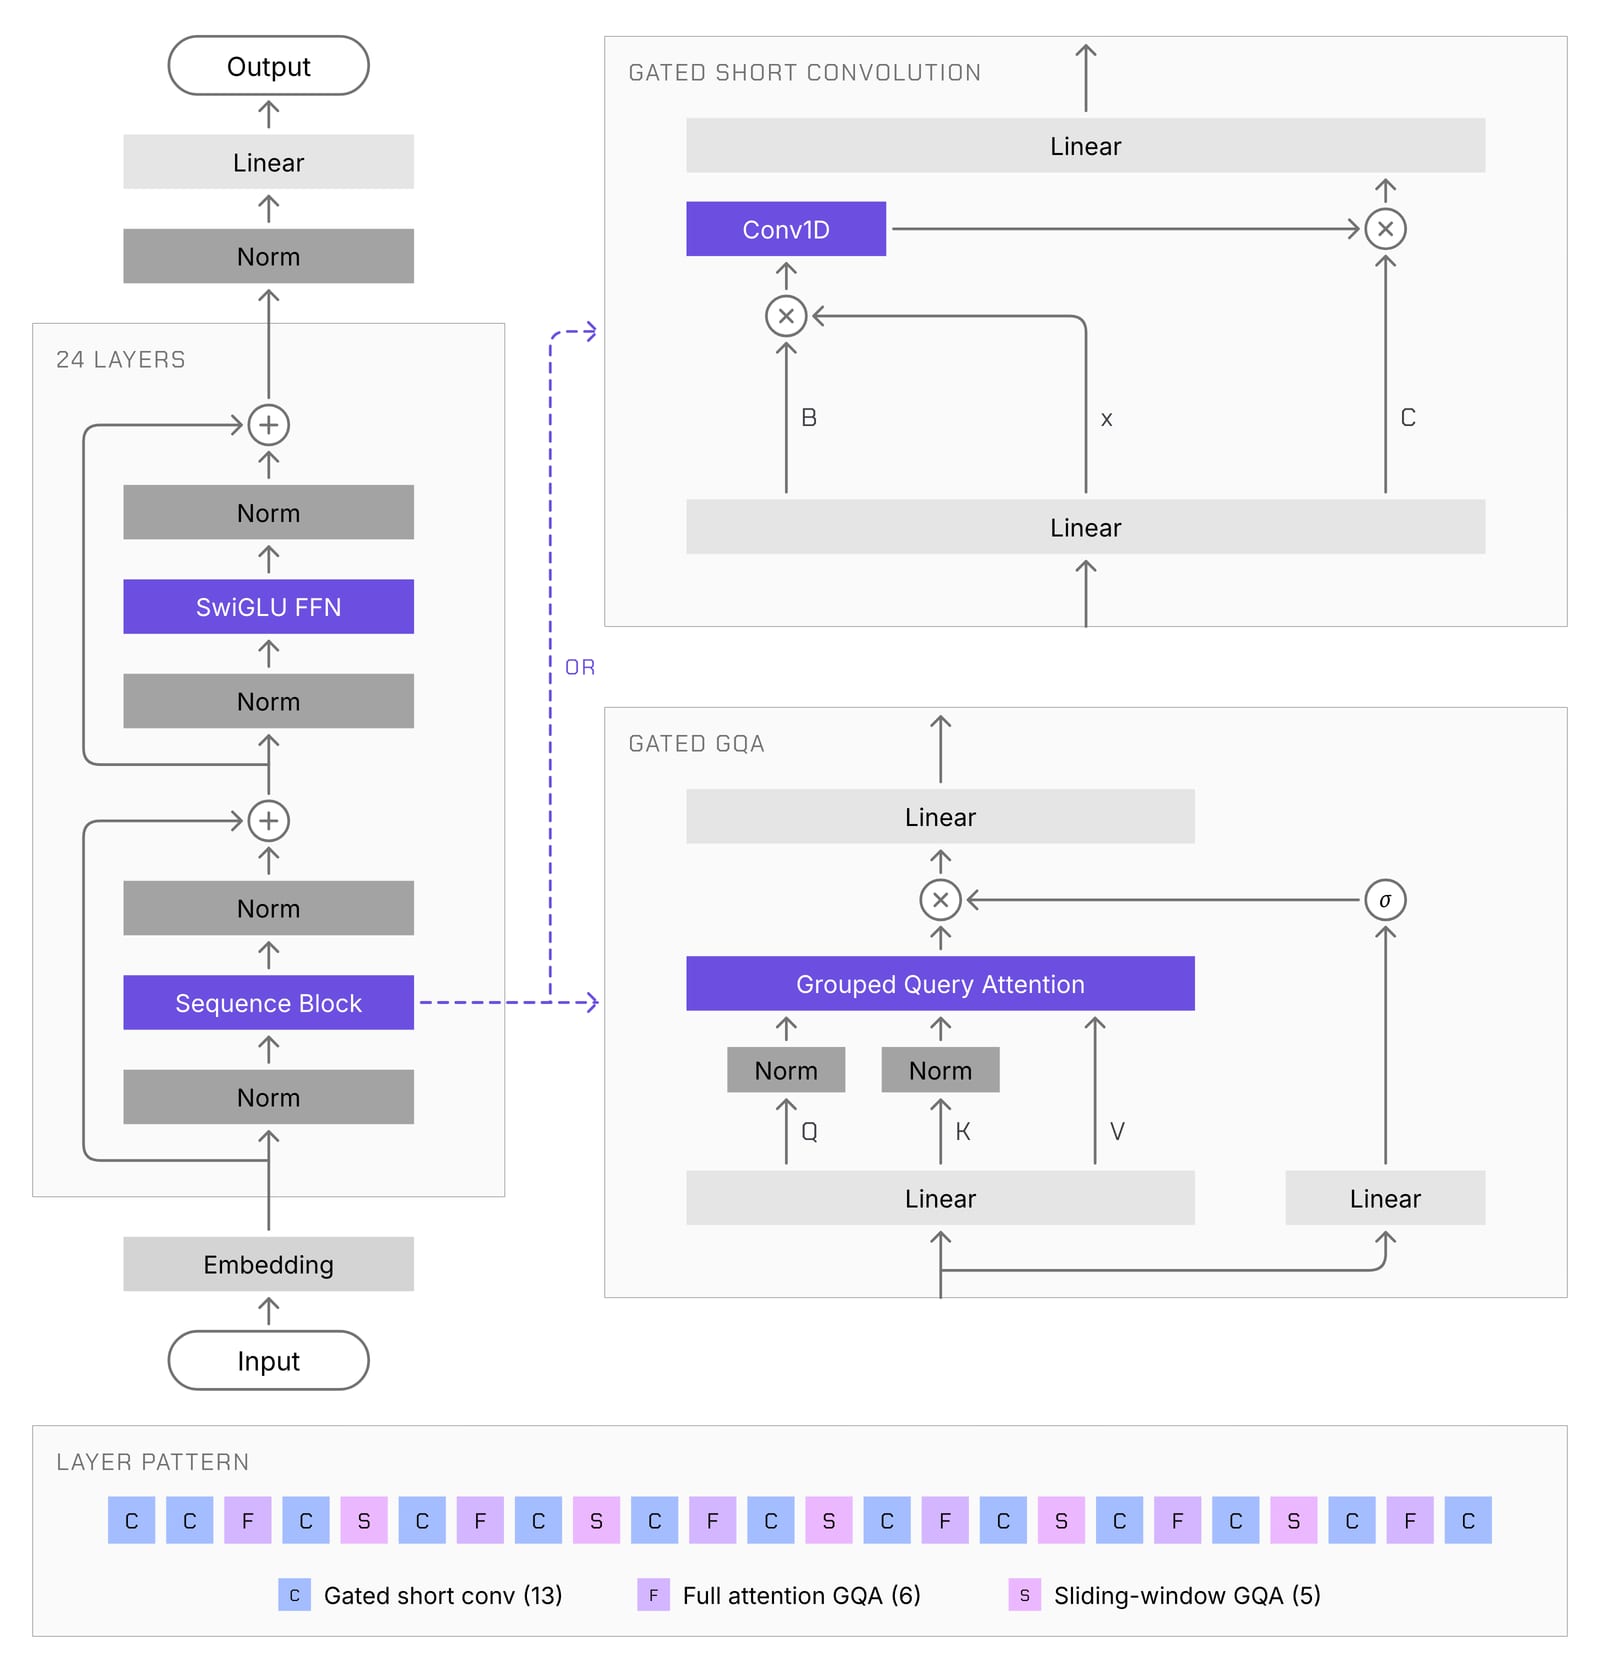
LFM3は、短畳み込みとアテンションのハイブリッドが品質を犠牲にせず端末上で高速に動くことを示した先行のLFM2ファミリーの後継にあたる。LFM3ではこのアーキテクチャを、スマートフォンやRaspberry Pi 5からノートPC、クラウドCPU、GPU、Qualcomm Hexagon NPUまで14のデバイス・バックエンド構成を対象とするハードウェア・イン・ザ・ループ探索で再設計した。その成果が基盤モデルLFM3-1.7B-Baseであり、6モデルはすべてここから分岐する。
一貫した狙いは効率化だ。LFM3-1.7Bはパラメータ数を35%削減しながらLFM2.5-2.6Bを上回るとされ、特にエージェントタスクで差が大きい。WebArena-Verifiedでは3.02に対し38.42だ。視覚モデルは62の視覚ベンチマーク平均をLFM2.5-VL-3Bの57.6から71.4へ引き上げ、音声モデルはUTMOSv2の音声品質を3.22から3.83に改善した。マルチモーダルモデルは2つの新しい自社製エンコーダに支えられており、その一つLiquidCodecは生成トークンを音声に変換する音声トークナイザで、Apple M4 Maxの単一CPUスレッドで実時間の約87倍の速さで処理する。
発表はベンチマークにとどまらず導入にも触れる。Liquid AIはLFM3-VL-2Bを調整・ナビゲーション・操作の3つのロボティクスモデルに適応させた。操作モデルはLIBEROの4スイートで平均成功率96.2%を達成し、Jetson AGX OrinとTensorRT FP16上で50 ms未満で行動チャンクを生成する。短時間のファインチューニングで小規模モデルを特定タスクの信頼できる専門家に変え、端末からプライベート基盤、クラウドまで導入できるというのが訴えだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Google DeepMindは視覚言語行動モデル「Gemini Robotics 2.5」を発表した
Folkbenchは、静的キャッシュが効きにくい時事プローブと、一致率・入力トークン・思考トークン・指紋・キャッシュ状態を記録するモデル指紋プローブを組み合わせ、公式直結キーと比較する手法を発表した
Zennの執筆者が、Anthropic Messages・OpenAI Chat Completions・OpenAI Responsesの各APIを相互変換するローカルゲートウェイopencodex 2.100.2を…
サブエージェント間で34ファイルを置き換える試行で、delegating-work Skillを与えられたエージェントは24項目中18項目を満たし、なしでは3項目だった
Microsoftは11月17日から20日までサンフランシスコでIgniteを開催し、CEOのSatya Nadella氏が基調講演を行う
Robbyantは触覚モデルLingBot-Touchを公開した