何が起きたか
清華大学は2026年10月8日、TokenRouterを公開した。Qwen3-0.6BとQwen3-32Bが回答途中で交代でき、スループットは既存構成の2.01~64.15倍速い。
なぜ重要か
モデルルーティングを実行中の判断に変え、難しいトークンだけ大規模モデルを呼ぶ。独立した再現では28.3%がQwen3-32Bに渡り、実行時間は約56%だった。
こういう要約が、毎朝あなたのメールに届きます。
TokenRouterは実用上の限界への答えとして登場した。判定モデルが入ってきた質問を冒頭で1つのモデルに割り当てるリクエスト単位のルーティングは、RouteLLMやOpenAIのDecisions APIなどのツールのおかげで一般的になったが、ごく一部だけが本当に難しい場合でも回答全体を1つのモデルに委ねてしまう。トークン単位のルーティング、つまりトークンごとに決める手法はR2R、CITER、Co-LLM、R-Stitchなどですでに提案されていたが、既存のサーバーは1つのリクエストを1つのモデルが端から端まで処理する前提だったため、回答の途中でモデルを切り替えるとステップのずれ、バッチ受け入れの待ち、キャッシュ管理で時間を浪費した。
論文の枠組みは「リクエスト中心の記述、モデル中心の実行」だ。TokenRouterはモデルごとにサブサーバーを保ち、それらの間でリクエストを受け渡す第3のループを追加し、KVキャッシュをモデル間で送ることを避けて、もう一方のモデルが見ていないトークンだけを送る。論文はまた、大規模モデルが処理前にリクエストを蓄積できるよう遅延バッチ処理を追加し、同時実行数ごとに最適なしきい値Bを予測する数理モデルを備える。
Qwen3-0.6BとQwen3-32Bを使ったR2Rフローの独立したMac再現では、MATH-500の30問で23問正解(小規模モデル単体は20問、大規模モデル単体は27問)、大規模モデルが書いたトークンは28.3%で、実行時間は大規模モデル単体の約56%だった。際立つ知見は2つある。大規模モデルに回されたトークンは数字ではなく「since」「But」「Wait」のような推論の方向を示す語だったこと、そして単一のMacでは判定モデルによるリクエストルーターと比べて高速化が崩れたことだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Phasis CEOのBrandon Farley氏は、World APIの「/orient」がWorldフレーム——現在の状態、重要な変化、根拠、不確実性——を返すと述べた
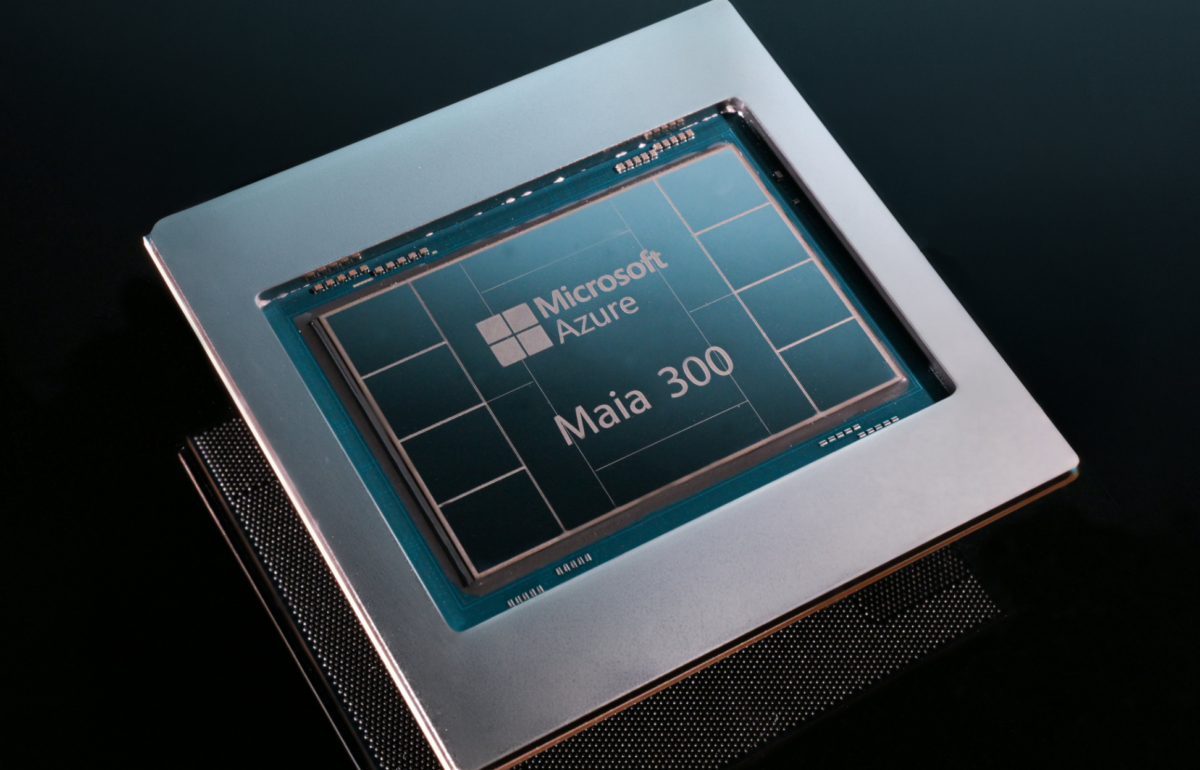
マイクロソフトは2027年からAzure Maia AIチップを数ギガワット規模で展開し、製品全体の主力推論システムにすると幹部スコット・ガスリー氏が記した
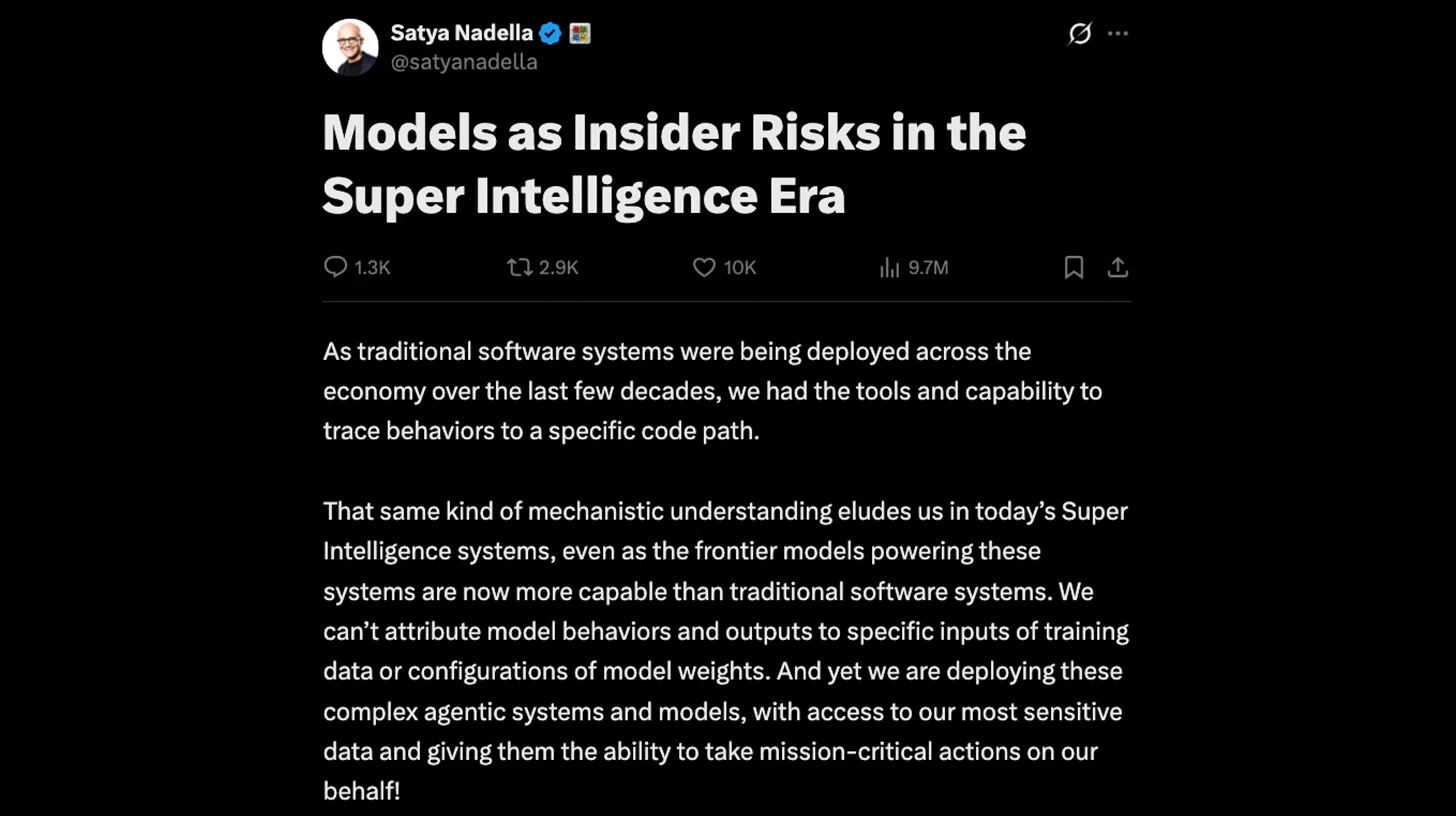
Microsoft CEOのSatya Nadella氏は10月10日のエッセイで、企業に安全制御をAIの手の届かない場所に置くよう求めた
トランプ大統領が超知能に関するホワイトハウス合意に署名して2日後、OpenAIはTomek Korbakを含む安全担当研究者3人を解雇した
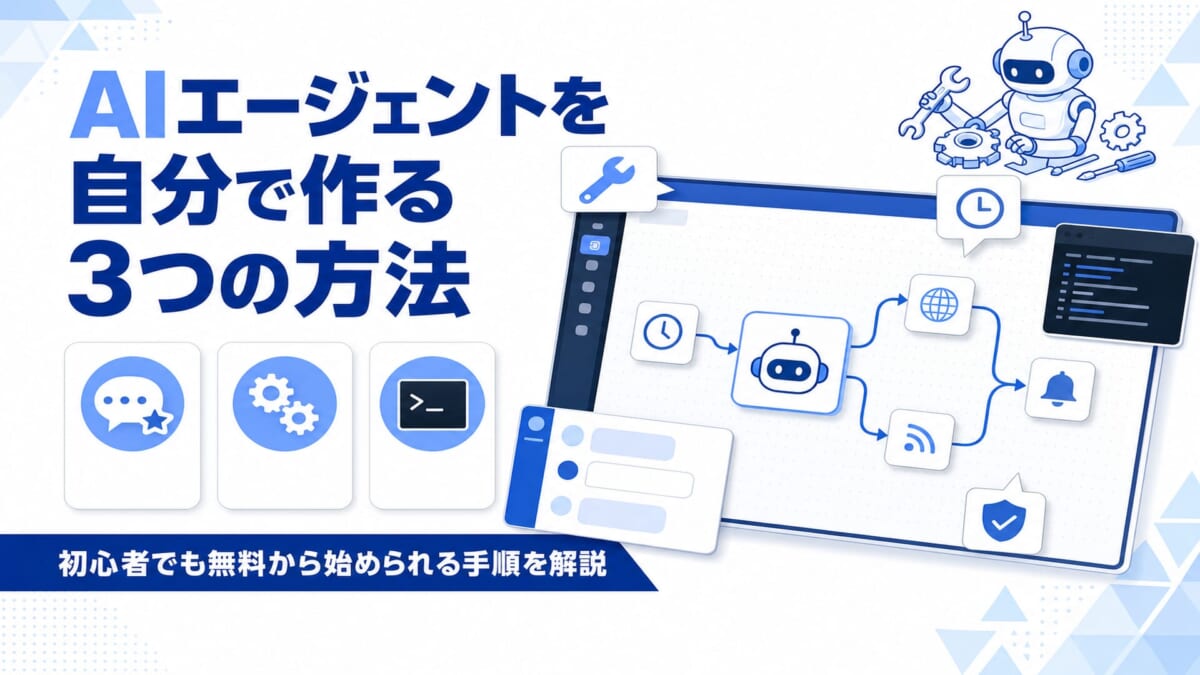
AI Nowは3ルートを提示——GeminiやClaudeのチャット型スキル、n8nやDifyの自動化型フロー、Claude CodeやCodexの実行型エージェント——ChatGPTのカスタムGPTは個人アカウントで作…
MistlabsがAmbiをAppleデバイスでベータ解除した