何が起きたか
Apple研究者が、AIのビジョン言語モデルが画像セットから共有される視覚概念を学習し、それを新たなインプットに応用できるかを評価するタスク「Visual Concept Inference from Sets(VICIS)」を発表した。研究者は、現在の最先端モデルがこのタスクで低い性能を示し、視覚的文脈を無視したり、バイアスのある出力を生成したりする傾向にあることを発見した。
なぜ重要か
ビジョン言語モデルは広く使用されているが、画像のみから推論する能力に乏しく、画像を通じて示された概念の変動を生成するようなタスクに必要とされている。本研究は、これらのモデルがテキストではなく視覚的文脈からどのように学習するかについて具体的な課題を明らかにしており、画像理解および生成のためのより高性能なAIシステムの開発に情報をもたらす可能性がある。
注目点
研究者は、このギャップに対処するための学習フレームワークとアーキテクチャを提案している。彼らのモデルは合成データおよび大規模なImageNet/WordNetデータセットでテストされ、出力の精度と多様性が向上し、スケッチなどの未見の概念およびモダリティへの一般化性能を示した。
こういう要約が、毎朝あなたのメールに届きます。
ビジョン言語モデルは複雑なテキスト指示に従うことができるため、現代のAIアプリケーションの中心となっている。しかし、テキストベースの推論におけるこの強さは、純粋に視覚的な例から推論する能力という根本的な弱さを隠している。VICISタスクはこのギャップに直接対処している。言語的な説明に依存するのではなく、モデルは複数の画像例にわたる視覚的パターンを観察し、統一的な概念を抽出してから、それを一貫して新しい画像生成に応用する必要がある。
現在の最先端モデルのVICISでの低い性能は、例からの視覚概念学習がスケーリングや指示追従能力の創発的特性ではないことを明らかにしている。モデルは視覚的な例をテキストのバイアスに優先させる形で軽視するか、提供された文脈との一貫性を欠いた出力を生成している。これは、今日のビジョン言語モデルのアーキテクチャと学習ダイナミクスが、このタイプの視覚推論に適切でないことを示唆しており、研究者は新しい学習フレームワークとアーキテクチャ設計を通じてこの課題に対処している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
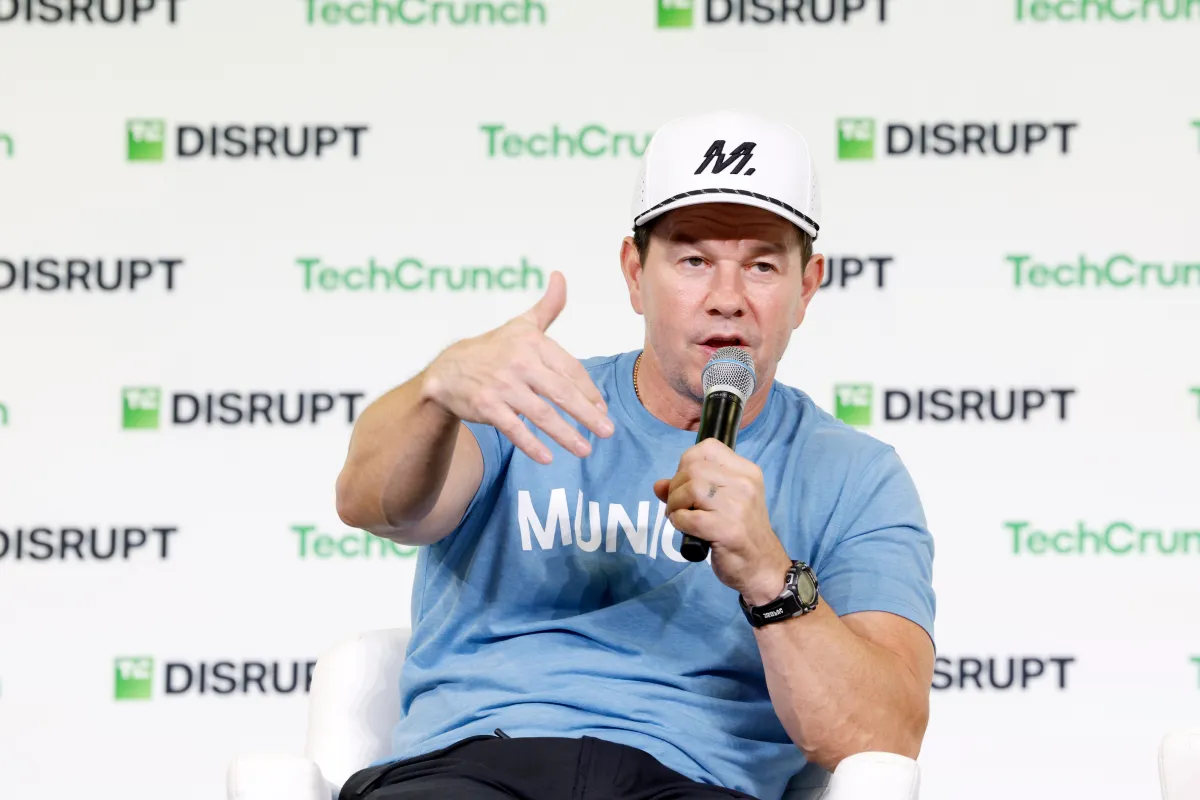
TechCrunch Disruptでマーク・ウォールバーグは、製作中のピート・ローズ伝記映画の球場の設定をAIで強化する可能性があると述べ、自身の遺産を継ぐAIの似姿にも前向きな姿勢を示した
政府が2026年8月25日に公表した「プリンシプル・コード」は、AI開発者と提供者にモデルと学習データの開示、利用者からの照会対応を求める

AI生成モデルのネットワークがコメディアンのネタを使い、OnlyFansやFanvueのアカウントへ閲覧者を誘導している
TOPPANホールディングスと慶應義塾大学は2月1日から7月31日まで量子コンピュータと生成AIの実証実験を実施し、10qubitで16×16ピクセルのコア画像を生成、AI処理後に256×256ピクセルのカラー画像を出力…

Black Forest Labsが2026年10月15日、FLUX 3 Image Kleinをオープンウェイトとして公開した

KreaがKrea 3のベータ版を公開