何が起きたか
GeneLabが314.6Mパラメータで学習した日本語専用の判断モデルsokudanを公開。bench_jaで部署振り分け0.880、解約予測AUROC 0.844。
なぜ重要か
日本語ビジネス文書を扱うチームが、データを社内に置いたまま分類をローカル実行でき、多言語ベースラインも上回れることを示唆すると、ベンチマークは示している。
注目点
0.880という看板の数値は、各選択肢ラベルに付けた一行説明に依存しており、それを除くと精度は0.537に落ちる。実際の日本語トラフィックでも同じ差が出るか、GitHubのissueを注視したい。
誰に効くか分類やラベル付けのために既にLLM APIを呼んでいる日本語話者のPython開発者が主な対象で、代わりにローカル実行のモデルに切り替えられる。第二の層は、社外に出せないデータを抱えるチームだ。重みが公開されているからである。
こういう要約が、毎朝あなたのメールに届きます。
sokudanは突然現れたわけではない。作者はまず、オープンな多言語判断モデルであるlaya-multilingualを日本語ビジネス文300件で測定し、部署振り分けは機能する一方、解約の兆候に関するイエス・ノーの問いはAUROC 0.523とほぼ偶然の水準にとどまると分かった。sokudanの最初のバージョンは、その穴を埋めるために2日間のスプリントで作られた。他に選択肢がないわけではない。TypeSafe AIは2026年9月15日にJevを、Liquid AIは2026年9月29日にd1を公開したが、どちらも重み非公開のAPIとして提供され、日本語の精度は公表されていない。記事の表にはJev、d1、Laya、Nokia Applied ResearchのAnyJev、sokudanが並び、オープンウェイトかつ日本語特化の両方を満たすのはsokudanだけだった。
ベンチマーク自体は、日本語ビジネス文300件のセットで、それぞれ4択の部署、3段階の緊急度、イエス・ノーの解約フラグがラベル付けされている。sokudanは選択課題で0.880、スコア課題でRPS 0.075、イエス・ノー課題で精度0.780とAUROC 0.844を記録した。作者は、TypeSafe AIの利用規約が同社サービスや出力を類似製品の開発に使うことを禁じているため開発中にJevを一度も呼び出しておらず、表にJevとd1がないことを率直に記している。記事はまた、sokudanの学習データが合成データ(単一のLLMが生成した21分野・4,833文書)であり、bench_jaも合成データだと指摘する。
実務上の争点は、実際の導入で選択肢ラベルがどれだけ効くかにかかっている。精度の最大の振れ幅はモデル構造や学習データではなく、選択肢ごとの一行説明から生じた。短いラベルだけでは精度は0.880から0.537へ落ちた。これはsokudanを採用するチームが、モデルをすぐ使えるものとして扱うのではなく、明確な選択肢の説明を書くことに投資する必要があることを示唆する。作者はまた、採用、与信、懲戒、医療、法務の判断への使用を警告し、英語の入力は多数決並みの性能になると注記している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
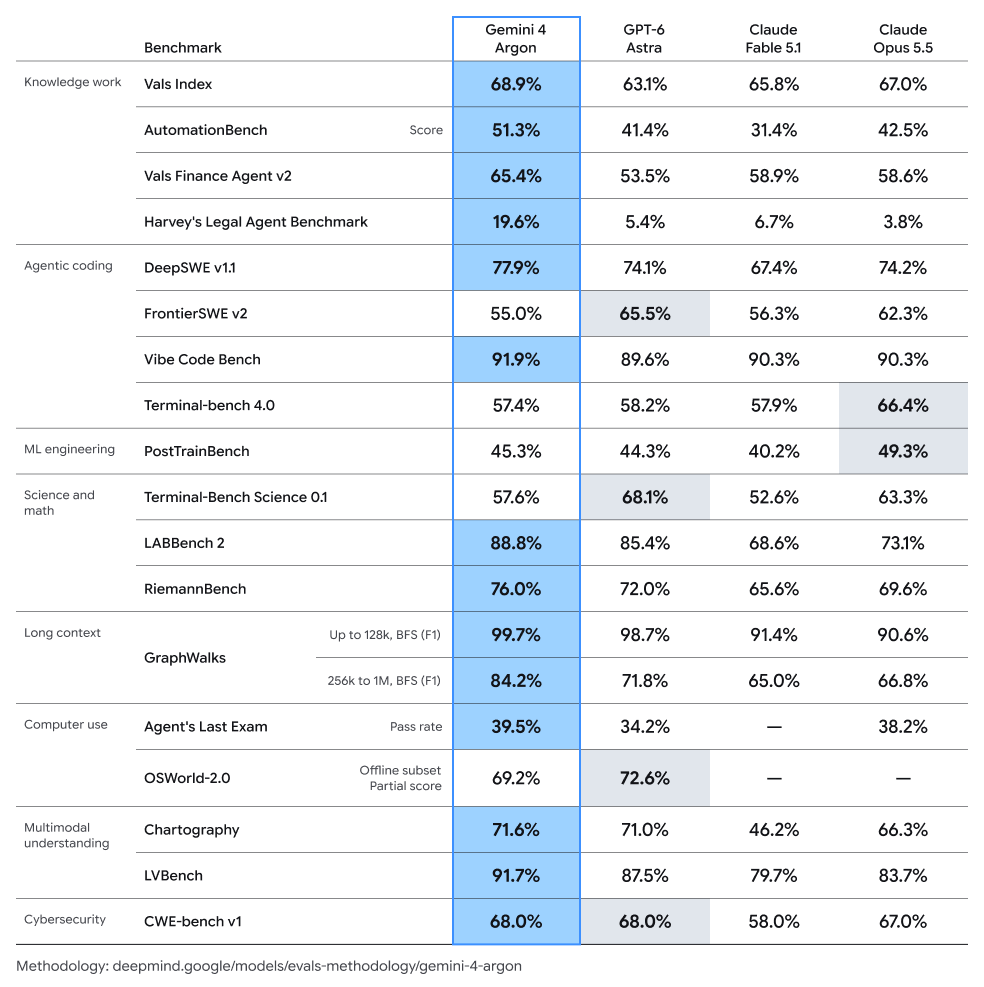
Google DeepMindがコーディングや企業向けナレッジワーク、サイバー防御向けにGemini 4 Argonを投入
VRAM 32GB環境で4ビット量子化のQwen3.8 27Bを試し、Q4_K_Sに切り替えるとVRAM使用量26GBで推論が高速化、記事要約をトラブルなく完了した
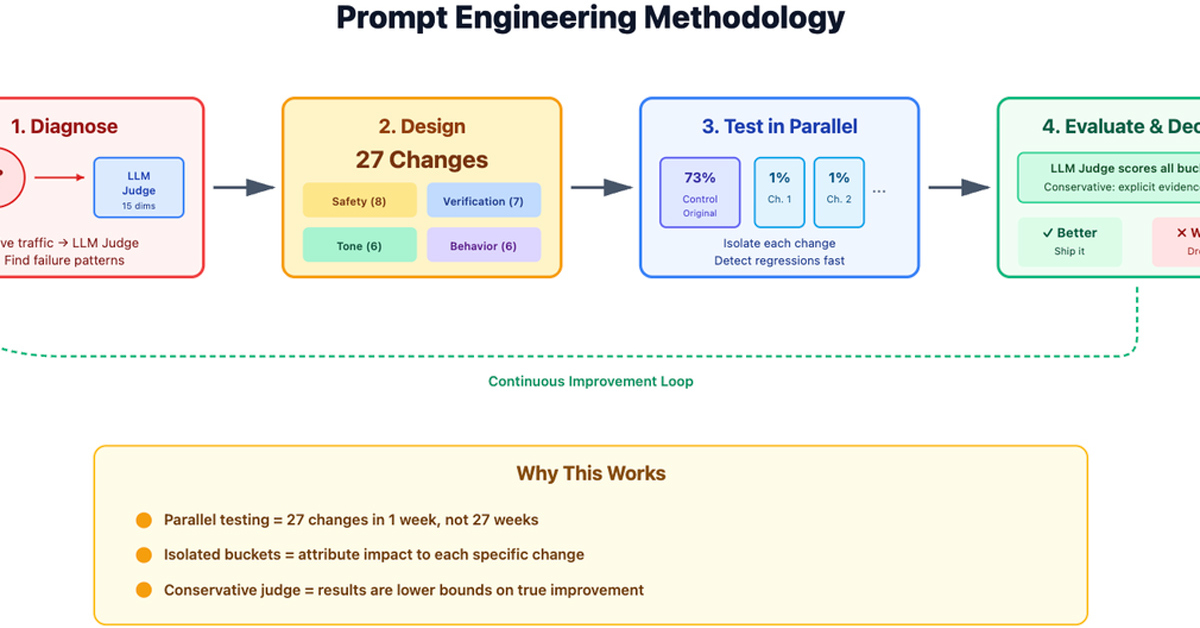
AWSは2026年8月25日、AIコーディングエージェント「Kiro」のシステムプロンプト評価の仕組みを明らかにした
Ollama 0.35は意思決定モデル対応リリースの第1弾で、Nimble、Tev1、Tev1:0.8bをローカルで実行できる
SpaceXAIのGrokipediaがv0.3アップデートを公開
Google DeepMindのKoray Kavukcuoglu氏が9月30日にGemini 4 Argonを発表