何が起きたか
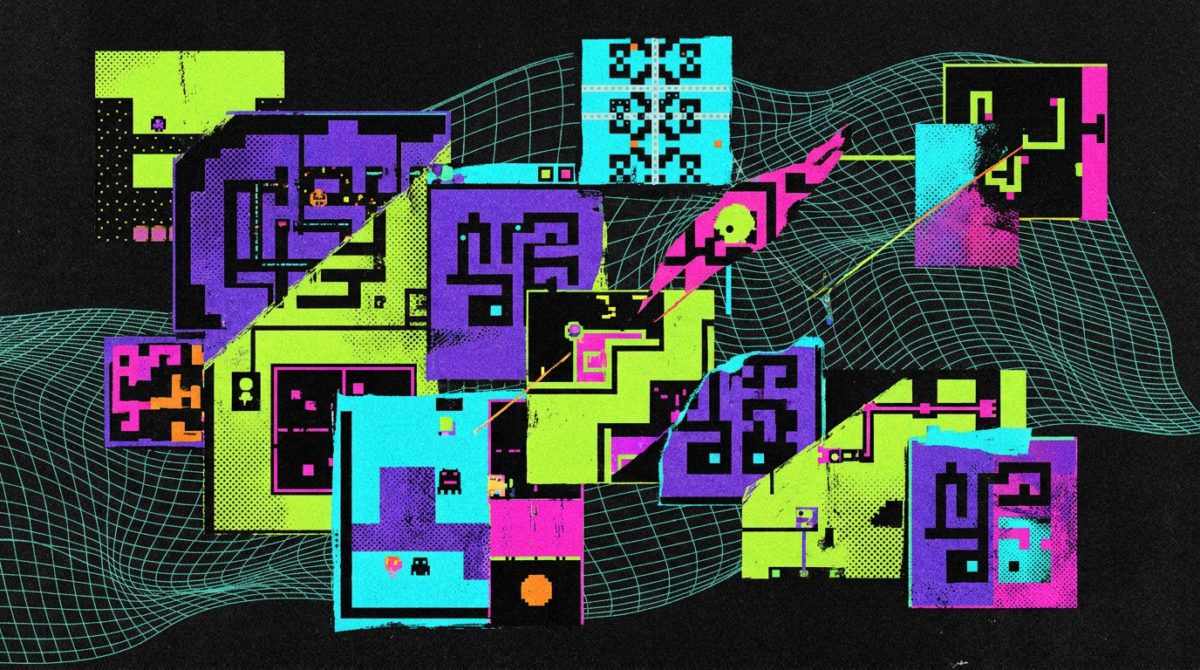
Anthropic の Claude Opus 5 が ARC-AGI-3 で30.2%を達成した。このベンチマークは AI モデルが訓練中に見たことのない新しいタスクをどの程度解けるかを測定する。従来の記録は OpenAI の GPT-5.6 Sol (Max) による7.8%だった。Opus 5 はそれまで未解決だった5つの環境を解き、そのうち4つは人間レベル以上の性能を示した。また Anthropic 自身の Fable クラスモデル(約20%)をも上回った。
なぜ重要か
ARC Prize の開発者は、この成果を未知の環境における自律的な探索・計画・実行を可能にする論理推論の強化に帰している。Opus 5 は研究者が過去に見たことのない推論行動を示し、タスクを代数表記に変換し、独立して反射方程式を定式化した。ただし、対話型パズルゲーム用の非公開ベンチマーク Witness での独立テストでは、実世界での効果はより限定的であることが示唆されている。Opus 5 は Witness で43.4を獲得し、競合モデルと統計的に同等で、ARC-AGI-3 での伸びに比べ Opus 4.8 からの改善幅がはるかに小さい。
注目点
ARC-AGI-3 の25個の公開デモ環境のうち6つが解決された。完全な結果、リプレイ、ベンチマークコードはすべて公開されている。より古い ARC-AGI-2 ベンチマークでは Opus 5 は90.4%、ARC-AGI-1 では97.5%に達する。研究者によると、Claude Code などの外部ツール内で使用された場合、Opus 5 はさらに高スコアを得る可能性が高いが、公式スコアは言語モデル単独の性能を反映している。
こういう要約が、毎朝あなたのメールに届きます。
Claude Opus 5 の ARC-AGI-3 でのパフォーマンスは劇的な飛躍を表している。7.8%から30.2%へのジャンプだ。しかし、その改善の本質については議論がある。ARC Prize は、未知の環境における自律的な探索と計画をより強く可能にする論理推論能力の強化に焦点を当てている。タスクを代数表記に変換し、独立して反射方程式を定式化するモデルの能力は、推論の観点から見て本当に新しい行動を示している。しかし、Anthropic はトレーニング方法を開示していないため、このゲインが根本的な推論改善を反映しているのか、それとも ARC-AGI-3 のパズル固有のメカニクスに対する焦点的な最適化を反映しているのかという疑問は残る。
これらの解釈の間の緊張は、ベンチマーク間での結果比較を通じてはっきりしてくる。別の対話型パズルベンチマークである Witness での独立テストでは、Opus 5 は43.4を獲得している。これは Kimi K3 や Fable 5 などの競合モデルと統計的に同等であり、ARC-AGI-3 での大幅なジャンプと比べて Opus 4.8 からの改善幅は限定的だ。Witness の開発者である Guanghan Ning は、このパターンがジャンル固有データでのトレーニングに適合していることを示唆しているが、Opus 5 は Witness に対して一般化しており、ただし ARC-AGI-3 ほど劇的ではないことを明確にしている。ARC-AGI-3 の開発者の一人である Greg Kamradt は、Witness は新規性への適応を完全にテストしていない可能性があり、単一の弱い結果が、より広い推論の改善の可能性を排除しないと反論している。
解決策は AI ベンチマーキングの進化の方法にあるかもしれない。Ning はコーディングベンチマークとの類似性を指摘している。モデルが改善するにつれて、HumanEval のような飽和状態のベンチマークから頻繁に更新される競技へと移行した。ARC-AGI-3 が対話型推論研究の主要なターゲットとして浮上し始めた今、集中的なトレーニング努力をまず引き付けるであろう。その後、より多くのエッジケースと汎化パターンをカバーすることで、モデルはこれらのスキルをより広い推論タスクに転送するのを助けることができる。真の新規性処理をテストする独立したベンチマークが成熟するまで、Opus 5 の ARC-AGI-3 でのリードが根本的な進歩を反映しているのか、焦点的な最適化を反映しているのかという問題は、未解決のままであろう。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
AI指導者らが開発減速を議論した1年を経て、あらゆる立場の有権者が意思を示し、米国内のデータセンター建設をいっそう困難にし、背後にいるAI富豪らに挑戦状を突きつけた
外務省の要請を受け、来年度予算の裏付けを得た国際交流基金が、有名なアニメ・マンガのキャラクターと日本語会話を練習できるアプリを開発し、2028年度までの完成を目指す
アンソロピックから多額の資金提供を受けるPublic First Actionと関連スーパーPACは、2027年の目標を記したメモをSemaforと共有した
古河電工はHVLP4グレードの銅箔「F0X-WS箔」を日光・栃木と台湾の拠点で段階的に増産し、2029年度末までにグループの供給能力を今年度末比で約2倍に拡大する
SHLの6〜7月調査で、米国の回答者の19.1%がAIに職を代替された後、復帰を求められたと答えた
1,000件のリクエストを模したキューで、最初のトークンまでの中央値が452秒(7.5分)から14秒に短縮され、48トークンの単一回答も567 msから39 msになった