何が起きたか
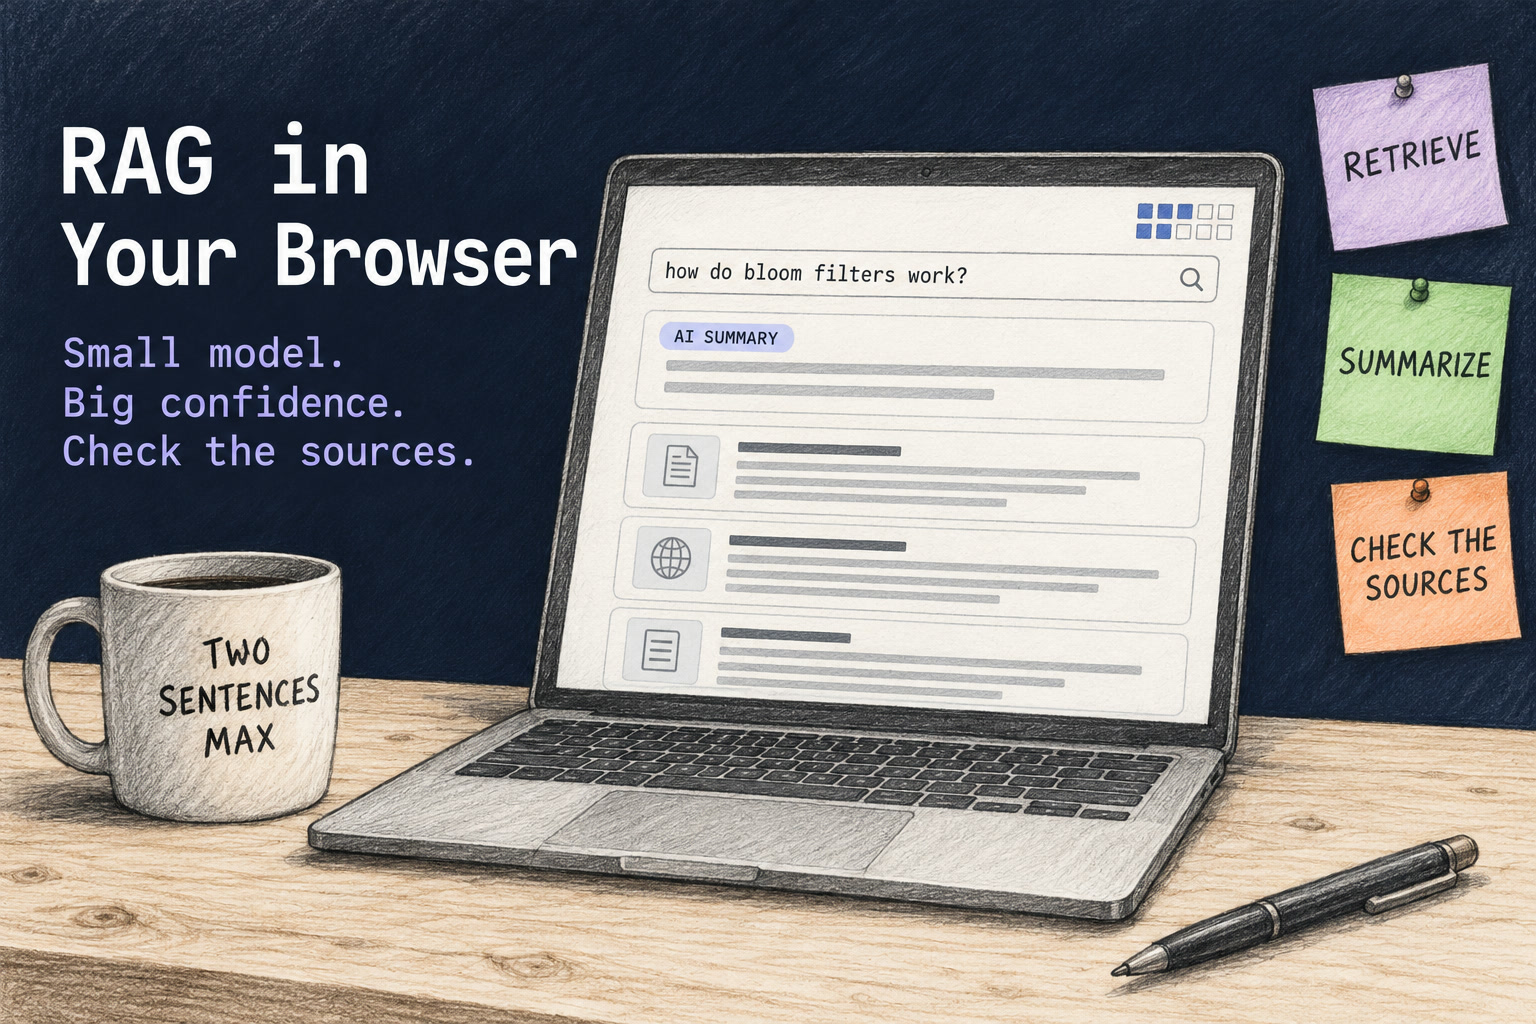
開発者が自ブログにブラウザ完結型のRAG検索「ask my blog」を実装し、検索が選んだ4つのパッセージを小型モデルが2文で要約する仕組みを、30問の質問と15問の未収録質問で検証した。
なぜ重要か
350 MB未満のモデルは忠実な回答が最大3/30問で、未収録の質問の多くに回答を捏造した。Qwen3-0.6Bは15/30、Gemma 4 E2Bは28/30、Haiku 5.5は27/30だ。
こういう要約が、毎朝あなたのメールに届きます。
この検証の出発点は、静的埋め込み検索による「R」の部分をブラウザ内で完結させたことにある。4 MBのルックアップテーブルから関連パッセージを引き、そこに小型モデルを重ねれば、回答までブラウザで生成できるという発想だ。
検証では30問の回答可能な質問と15問の未収録質問を用意し、全モデルに同じ4パッセージと同じプロンプトを与え、Opus 5.5が回答をパッセージに照らして採点した。その結果、350 MB以下のモデルは回答可能な30問中0~3問しか忠実でなく、未収録の質問14~15問に対して回答を捏造した。Qwen3-0.6Bは579 MBで15/30とほぼ半々、Gemma 4 E2Bは3.1 GBで28/30、API経由のHaiku 5.5は27/30だった。
興味深いのは、モデルが大きくなると未収録の質問を「パッセージには情報がない」と拒否できる点だ。Gemma 4 E2Bは15問すべてを拒否し、Haiku 5.5も1問しか捏造しなかった。小型モデルはこの拒否ができず、関連する投稿に引っ張られて誤答する。関連度ゲートも、明らかに的外れな質問は弾けるが、近い話題の質問はスコアが高く、しきい値を上げると本来答えられる質問13問も落としてしまう。
回答の長さを2文から4文、6文に増やす実験では、Qwen3-0.6Bの忠実さが15→9→5と急落し、Gemma 4 E2Bも28→26→24と下がった。文が増えるほど捏造の余地が広がることを示す。筆者はこの用途に特化したファインチューニングを次の課題に挙げている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
Anthropic共同創業者Jack Clark氏は10月13日、東大で、自らの後継を訓練できるAIが2027年までに登場する確率は50%超だと述べた
Anthropic Japanの1周年記念記者説明会で14日、共同創業者のJack Clark氏が、日本企業への相次ぐサイバー攻撃にAIが使われた可能性があると述べた
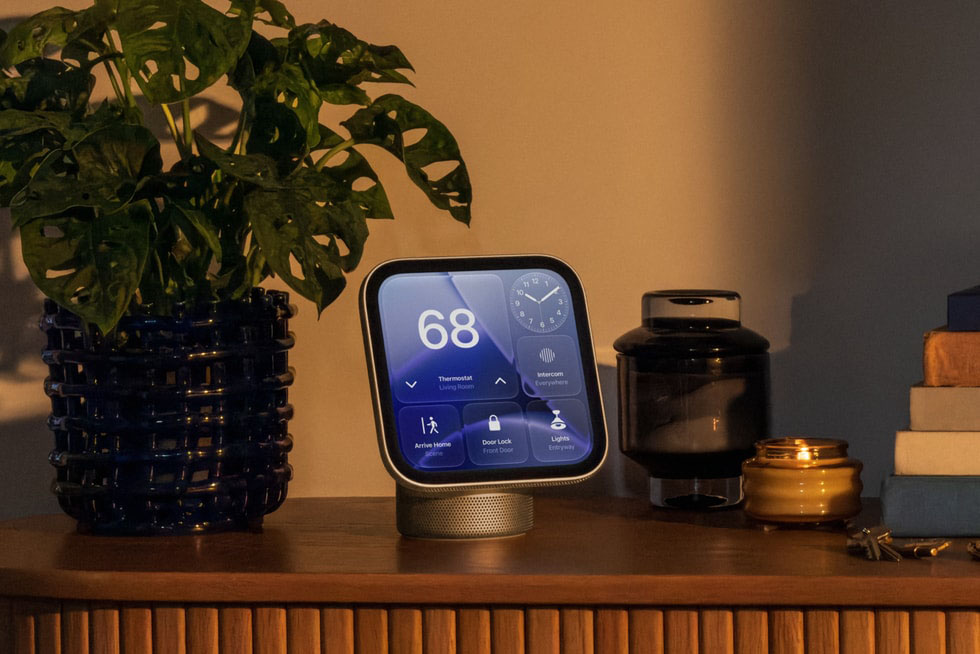
Appleは新しいSiri AIとApple Intelligenceを搭載した新デバイス「Apple HomeView」を発表
Tech Against TerrorismのCounter-Terrorism AI Benchmarkは134のAIモデルを200以上のテロ様式プロンプトでテストし、81が失敗した
EUのChatGPT Enterpriseアカウントでは、CodexとChatGPT Workが出力トークンの半数超を占め、中小企業の週間ユーザーは2026年5月以降8倍超に増えた
NEURA RoboticsがNeuron AIを発表