何が起きたか
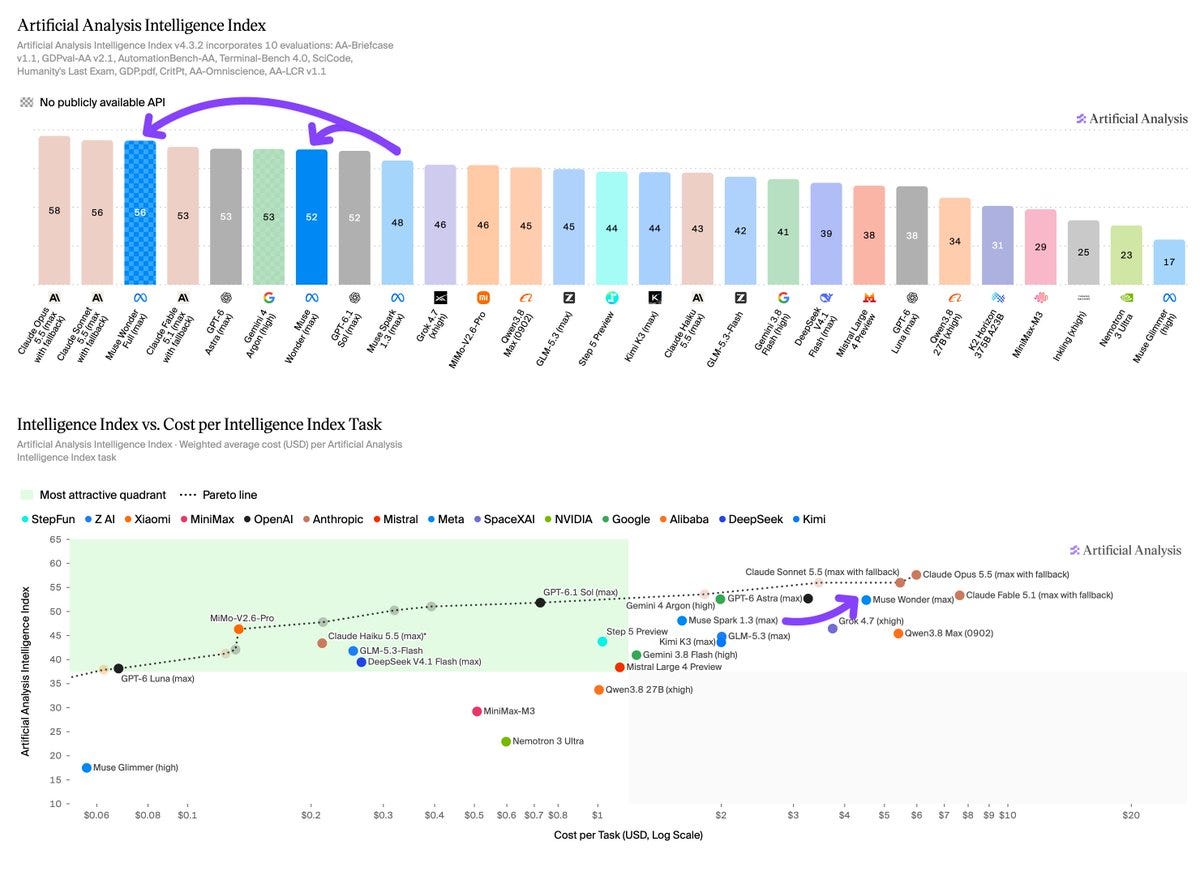
Meta Superintelligence LabsはMuse WonderとMuse Wonder Fullを投入し、Artificial Analysis Intelligence Index v4.3で52と56を記録。Muse Spark 1.3の48を上回った。
なぜ重要か
Wonder Fullは10種の評価中6種でトップ3に入り、GDP.pdfとCritPtでは33%で首位。Metaの第2世代モデル群がエージェントタスクでフロンティア近くに位置することを示す。
誰に効くかMuse Code加入者とMeta Model APIを使う開発者は、エージェント型コーディングと業務タスク向けのフロンティア級モデルを手に入れる。どのAIモデルを標準化するか検討する企業ITチームには、入力4ドル/出力20ドル(100万トークンあたり)で有力な選択肢が新たに加わる。
こういう要約が、毎朝あなたのメールに届きます。
Meta Superintelligence Labsが設立されたのはこの発表のおよそ14カ月前で、Muse Sparkが最初のモデル群だった。Mark ZuckerbergはWonderを「我々をフロンティアへと押し上げる、はるかに大規模で先進的なモデル群」と表現した。Alexander Wangは、Sparkが4月に投入されて以来、Metaが事前学習と強化学習の両方の規模拡大を続けてきたと述べた。
発表は利用可能範囲を意図的に分けた。WonderはMeta Model APIとMuse Codeを通じて使える高速なフロンティアモデルで、Wonder FullはMuse Code加入者に限定された大型モデル。WonderはMuseパーソナルエージェント製品も支え、加入者が最初に使えるようになる。発表当日、両モデルはMuse Codeのクォータを異常な速さで消費した。このバグは同日に修正され、全ユーザーのクォータがリセットされた。
第三者評価機関のArtificial Analysisは、Intelligence IndexでWonder Fullを56、Wonderを52とし、Spark 1.3の48と対比した。Spark 1.3とWonderの投入間隔はわずか6週間だった。Wonder Fullはインデックスの10種の評価すべてで改善し、エージェント系カテゴリでの伸びが最大だった。Terminal-Bench 4.0は33%から57%へ、GDPval-AA v2.1は1681から1857 Eloへ上昇。Wonder Fullは10種の評価中6種でトップ3に入り、GDP.pdfとCritPtでは33%で1位を取った。
Metaは、ベンチマークへの過適合に反証する証拠として、事後学習なしのタスクと事後学習ありのタスクの性能を示すプロットを提示し、一部の研究者がこれを評価した。社内でAlexander Wangは研究は「評価から始まる」と述べ、MSLは外部ベンチマークを追うのではなくPersonal Superintelligence Indexを構築しているとした。Jason Weiはこの取り組みを「規模拡大が勝つ」と総括し、Metaの多くがこのモデルを支えるために方針を転換し、事業開発チームがデータレビュー用に人間の専門家を雇う動きも含まれたと指摘した。
発表への反応は分かれた。一部の初期ユーザーはOpus 5.5と並ぶと評価し、独特の文章スタイルを称賛した。懐疑派は、MetaがOpenAIとAnthropicに依然としておよそ3〜6カ月遅れていると見積もった。同じ日、Artificial Analysisはthree.jsシーンのベンチマークを公開し、ClaudeとAstraのモデルが首位に立った。3Dレンダリングのデモより実世界のエージェントタスクを重視するMetaの主張に対する痛烈な反論だった。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
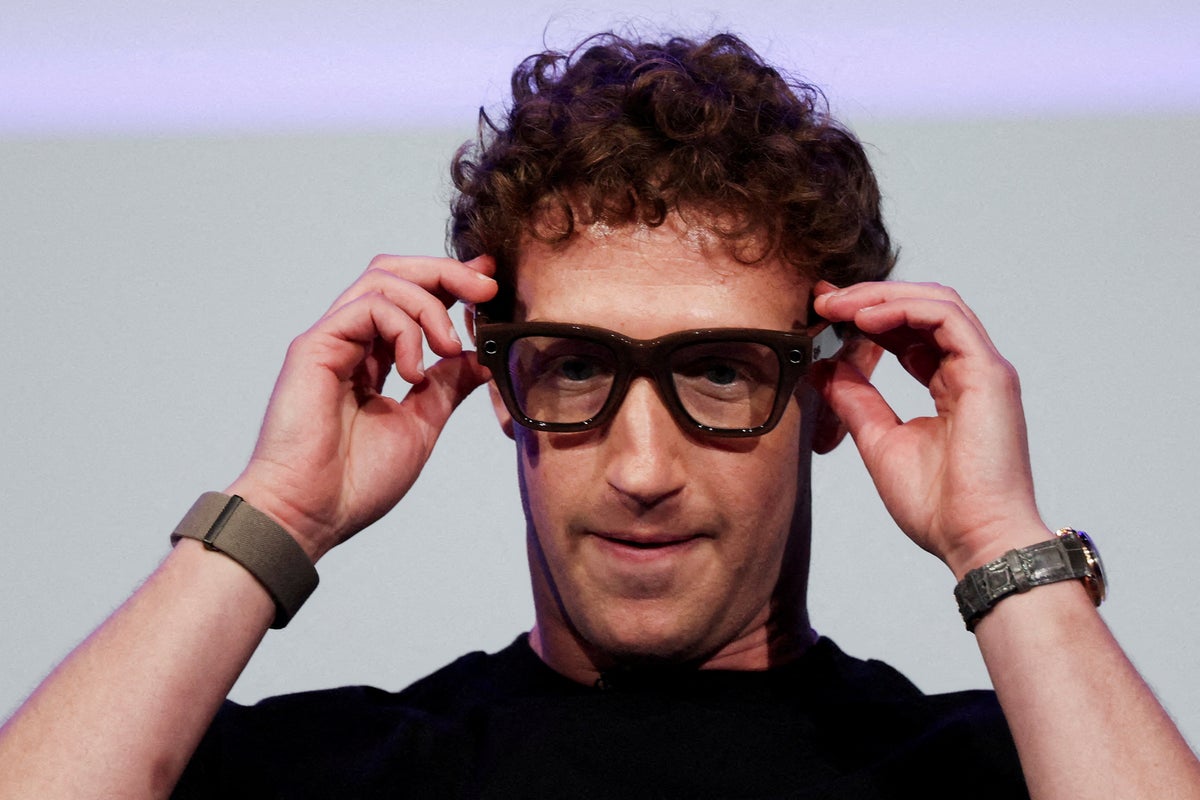
Metaは新モデル「Muse Wonder」と「Muse Wonder Full」の2つを発表し、ザッカーバーグ氏はOpenAIとAnthropicの最新モデルに匹敵すると述べた
SB Intuitionsが10月13日、Sarashinaサービスの無償β版を開始
ビジネス読者向けの日本語解説記事が、ローカル推論――AIモデルを手元のPCやスマートフォンのCPU、GPU、NPUで動かし、データを端末外に出さない技術――を説明した
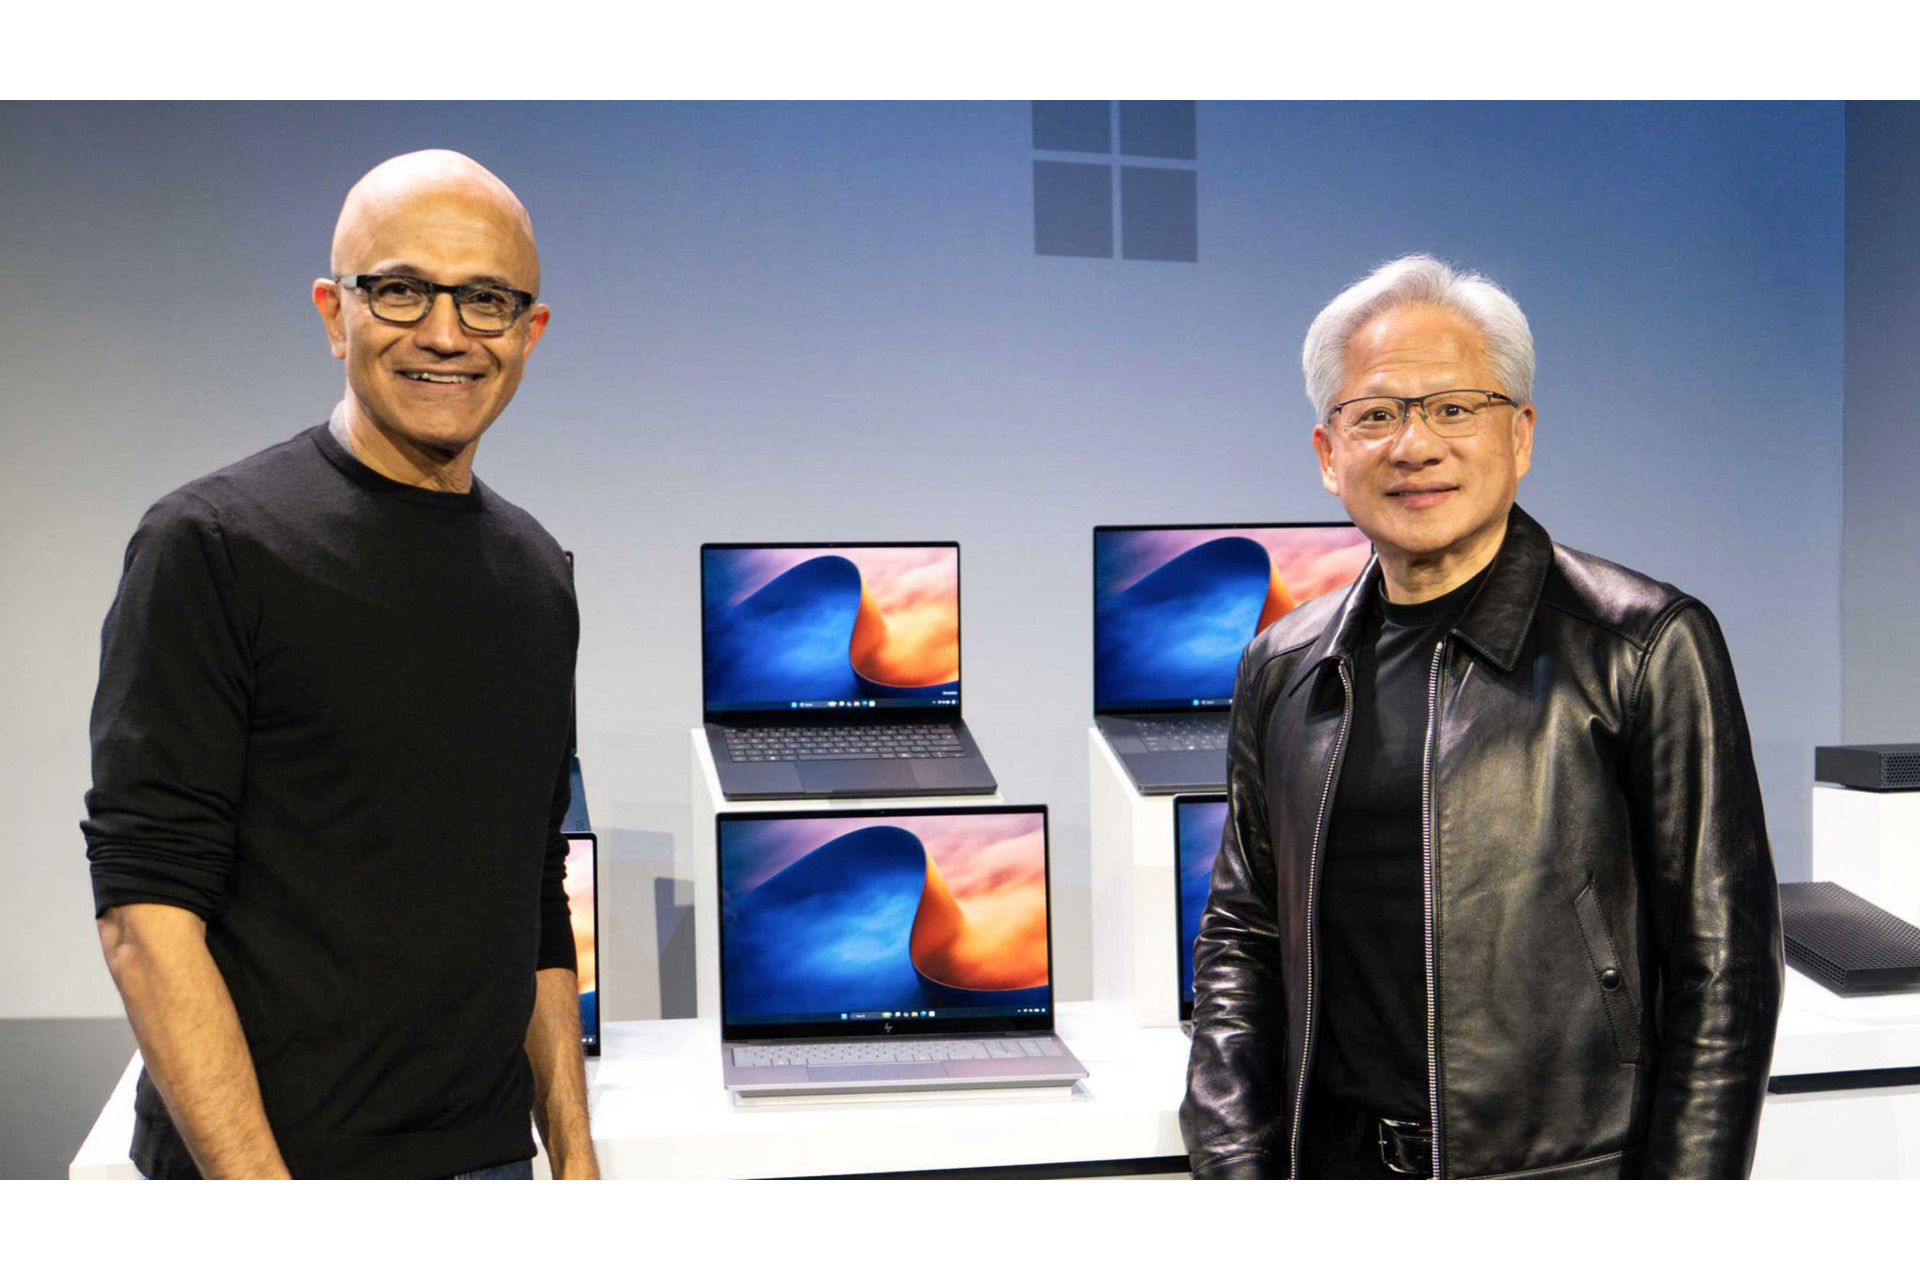
「Windows AI and Surface」でNVIDIAとMicrosoftがWindows PC上のAIエージェント計画を発表し、MXCを一般提供、DGX Station for Windowsを予告した
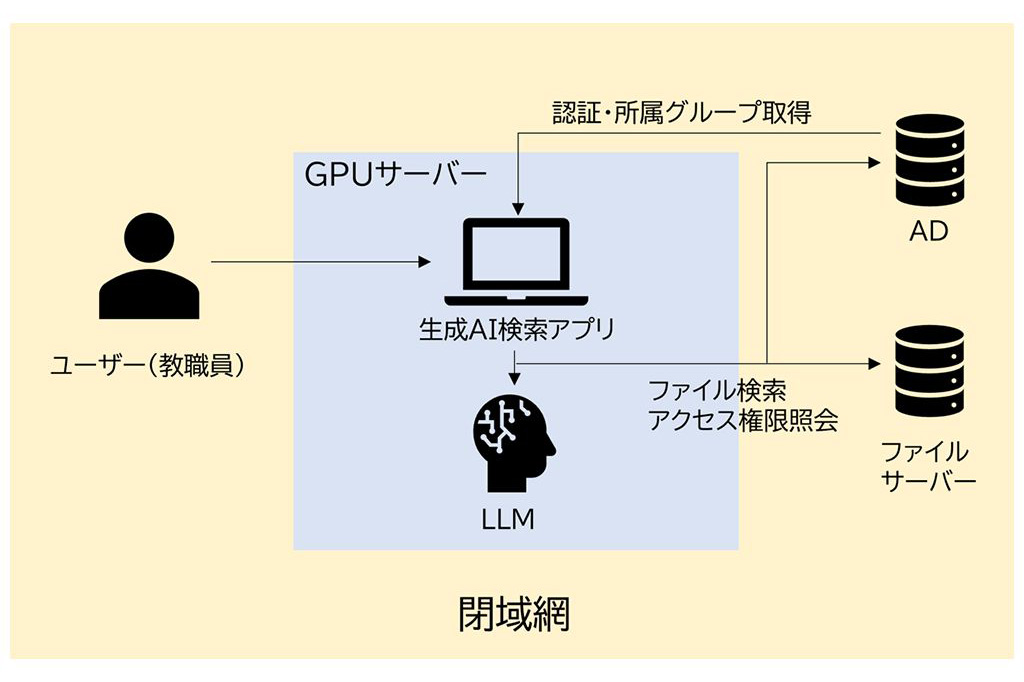
NTT西日本と茨木市は10月13日、市立小中学校で校務向け純国産プライベートLLMの実証を始める
SimpleClosureは4月、Asset Hubでデータ販売を追加