何が起きたか
Irodori-TTSを試した筆者は、4kHz超で見本より4〜7dB静かに発話すると判明(―31.9dB対―22.9dB)。
なぜ重要か
問題はモデル自身の挙動にあり利用者は直接変えられないが、見本音声を前処理して損失を補償すると出力が元録音の明るさに一致し、この声クローンツールの実用的な回避策となる。
こういう要約が、毎朝あなたのメールに届きます。
AIの支援を受ける非エンジニアの筆者は、Irodori-TTSのこもった音と感情表現の欠如という2つの問題の解決に取り組んだ。見本とモデル出力の平均的な音色を測定し、モデルが4kHz超で4〜7dB失っていると特定。うち2〜3dBのみが音声エンコード段階によるもので、残りは音声生成で生じていた。基盤モデルEcho-TTS向けの提案を含む一般的な設定調整では明るさは改善しなかった。代わりに見本音声の高域を事前に強調して損失を補償すると、出力は元録音の明るさに一致した。感情表現については、実録音ではなくモデル自身が生成した見本を使うと演技が可能になると判明。この修正で追加のこもりが生じたが、2〜4kHzの歪みを避けるため4kHz超のみを強調して解消した。筆者は限界も指摘する。声は2種類(いずれも自身の声)とテスト文3つのみで、結果が一般化するとは限らない。この手法はモデル内部を変えられない場合の同種の声クローンツールの実用的な回避策となる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
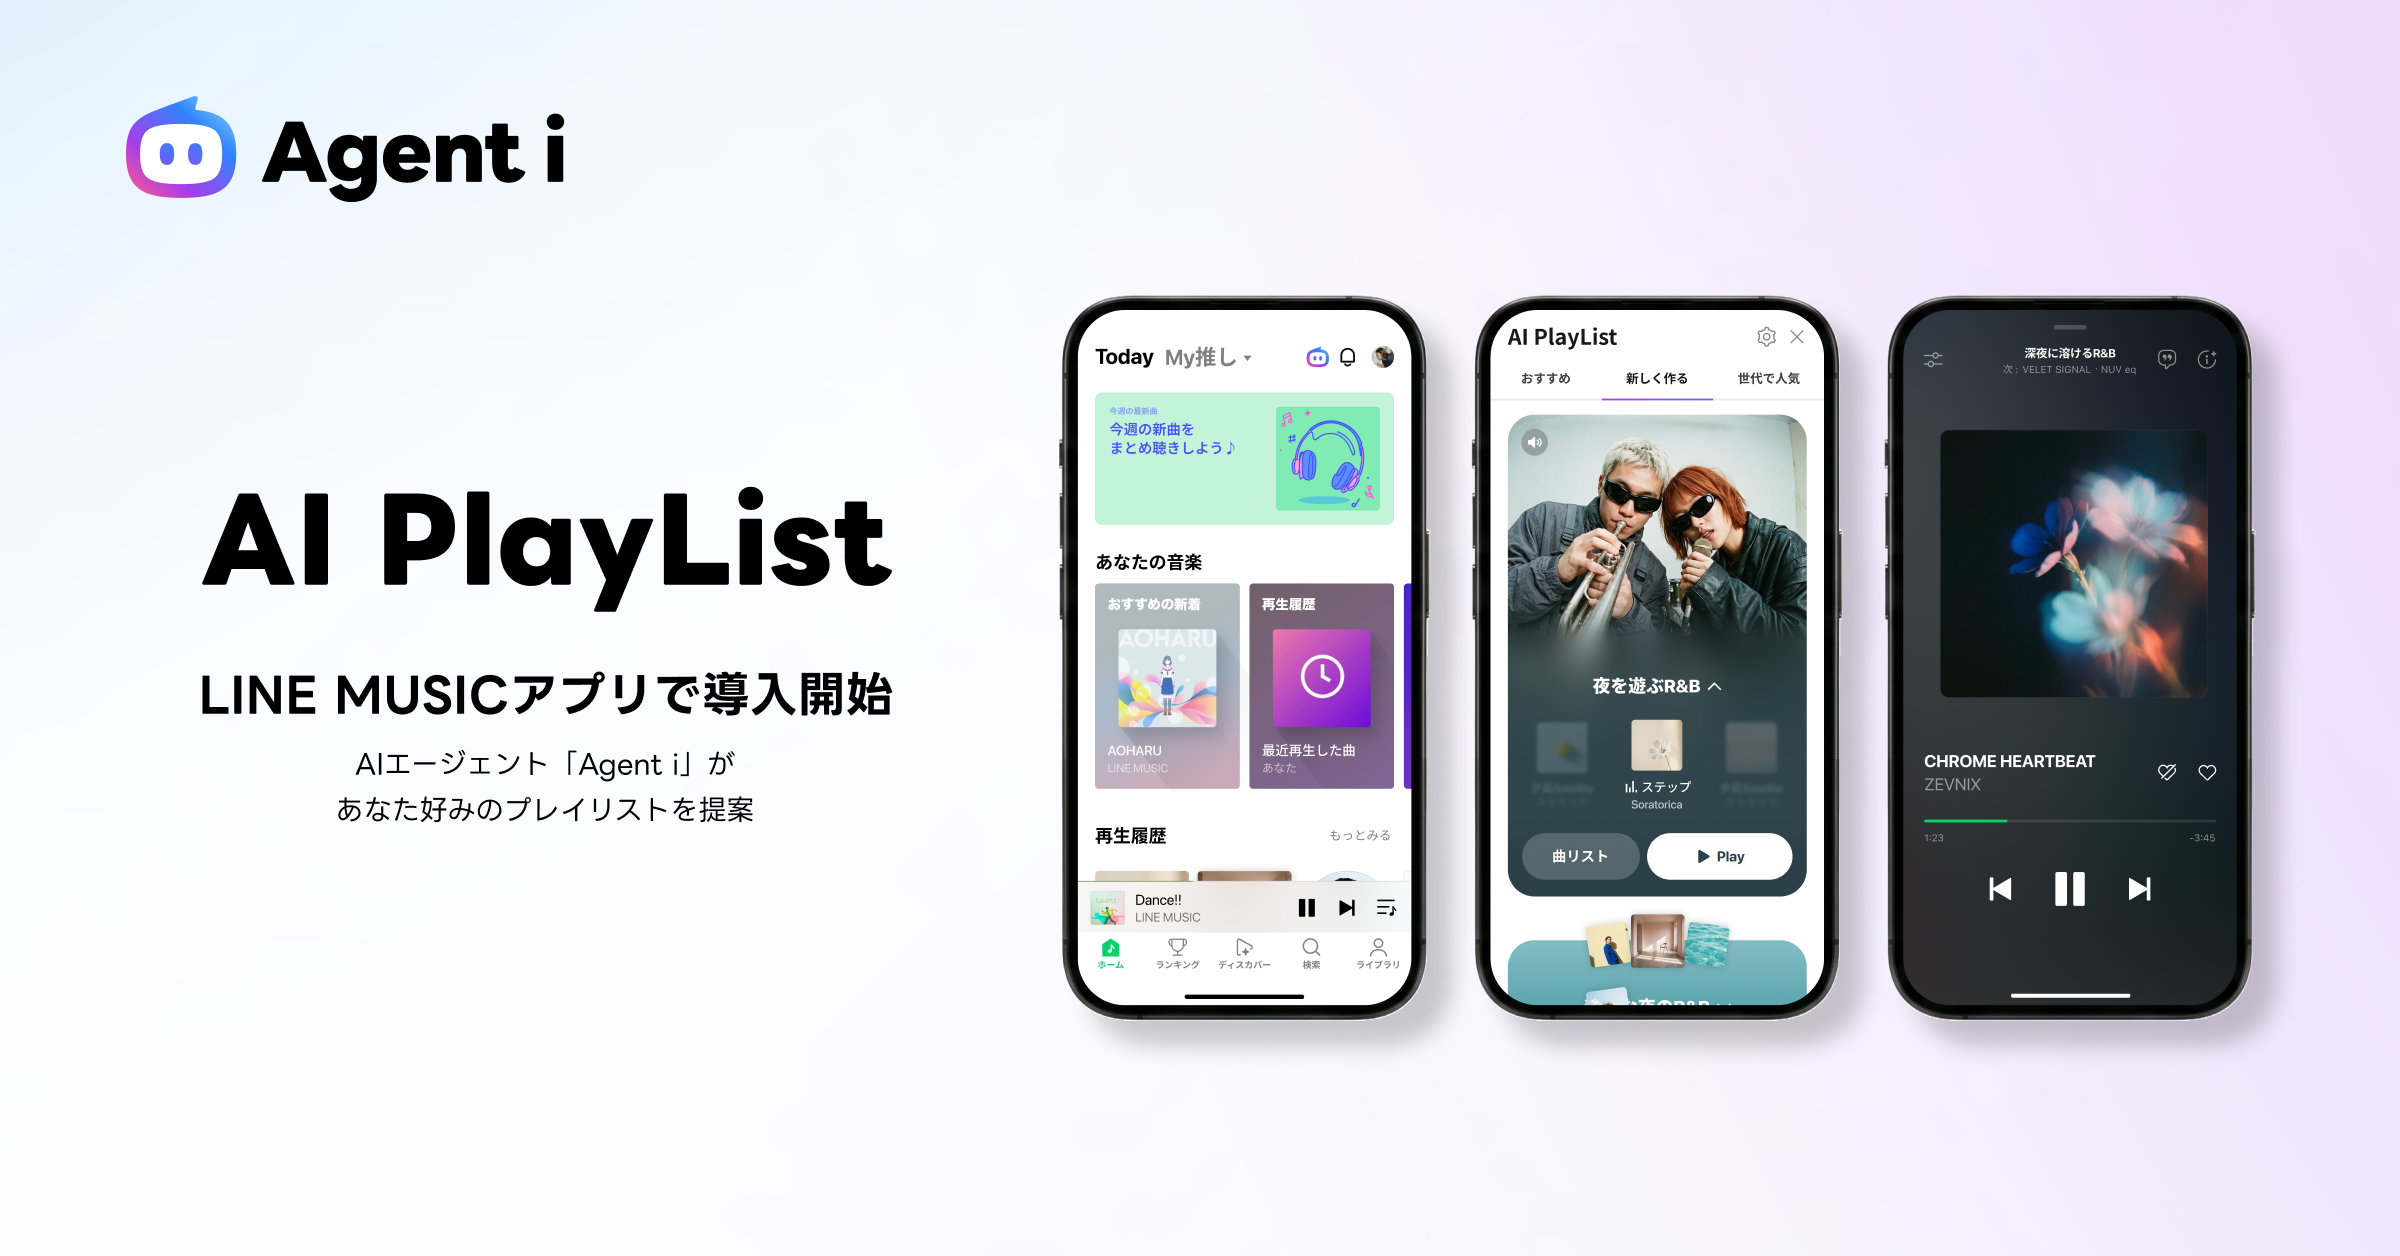
LINE MUSICとLY CorporationのAIエージェント「Agent i」が、個々の視聴好みに合わせたプレイリストを提案する機能「AI PlayList」を導入した
Together AIは音声合成モデルQwen3 TTSの提供を開始した
10行の台本と「有能な秘書の口調で」の指示を1回でGeminiのTTSモデル(音声Laomedeia)に送ると、62.7秒の音声は冒頭約15秒が指示文の読み上げで、台本部分は47.7秒だった
Softsuは、AI電話自動応答サービスMirai AIがASPIC AI・クラウドアワード2026のAI支援業務系ASP・SaaS部門でAX貢献賞を受賞したと発表した
Preparedが固定電話の通話を録音しAIで文字起こし・要約するRecACE plusの提供を開始、兵庫県内企業を特別キャンペーン価格でモデルケースとして募集

phonon:31m-enを試したところ、英語の短文音声が0.2〜0.3秒、長文(約17.4〜17.8秒)の音声が0.6〜0.8秒で生成され、メモリ使用量は約90〜126MBだった