何が起きたか
開発者がMoonshine Voiceの日本語「Small Streaming」モデルをLinux CPU(16コア)上でfaster-whisperのsmallモデルと比較し、合成音声・FLEURSの20クリップ・自作8文で検証。Moonshineは文字誤り率が低く(0.092~0.110対0.104~0.155)、応答も速かった(0.18~0.30秒対1.31~2.25秒)。
なぜ重要か
ローカルで動く日本語音声認識エンジンを検討する開発者にとって、MoonshineはCPU上でより高速かつわずかに高精度に見える。
こういう要約が、毎朝あなたのメールに届きます。
日本語音声認識を自分でベンチマークしたい開発者向けの実装体験記だ。セットアップ手順として、moonshine-voiceとfaster-whisperをインストールしたPython仮想環境、ffmpegで作成した16 kHzモノラル16ビットWAV入力を示し、moonshine-voice 0.1.5とfaster-whisper 1.2.1で動作する。Moonshineには100ミリ秒単位の音声チャンクをリアルタイム速度で与え、各行の完了時刻を記録できるようにし、faster-whisperには初回ロードの遅さを避けるためウォームアップ後にクリップ全体を一度に渡す。応答速度の定義は両者で異なり、Moonshineは最後の行が確定した時刻とその行の音声が終わった時刻の差、Whisperはクリップの総処理時間とする。
精度指標は文字誤り率(CER)で、句読点と空白を除去し全角・半角を正規化したうえで、参照文に対する編集距離を参照文字数で割って算出する。著者は注意点も挙げる。「三百二十八万五千円」を「328万5000円」と書くと意味は同じでもCERが上がるため、測定前に数字表記を揃えるべきだ。コードでは日本語向けにmax_tokens_per_secondをデフォルトの6.5から13に設定している。これはトークン毎秒数が多い言語に開発者ドキュメントが推奨する値だ。著者の計測では6.5と13でCERは小数点以下3桁まで同一で、そのサンプルでは差が出なかったが、ドキュメントに従うよう勧めている。
実用上の問題も2つ記録されている。1つのPythonプロセスで20クリップを処理するとMoonshineの結果が3件で空になったが、同じ音声を単独で実行すると正しく動作した。原因は特定できず、クリップごとのプロセス実行で回避した。またMoonshineは息継ぎや間で行を分割するため、話し言葉の日本語は多くの短い行になり、文に戻す後処理が必要となる。著者は非英語モデルの読み込み時に非商用ライセンスの通知が表示される一方、公式リポジトリのLICENSEは日本語を含む現行ストリーミングモデルをMITと記載している点も指摘し、商用利用前に公式に確認するよう勧めている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
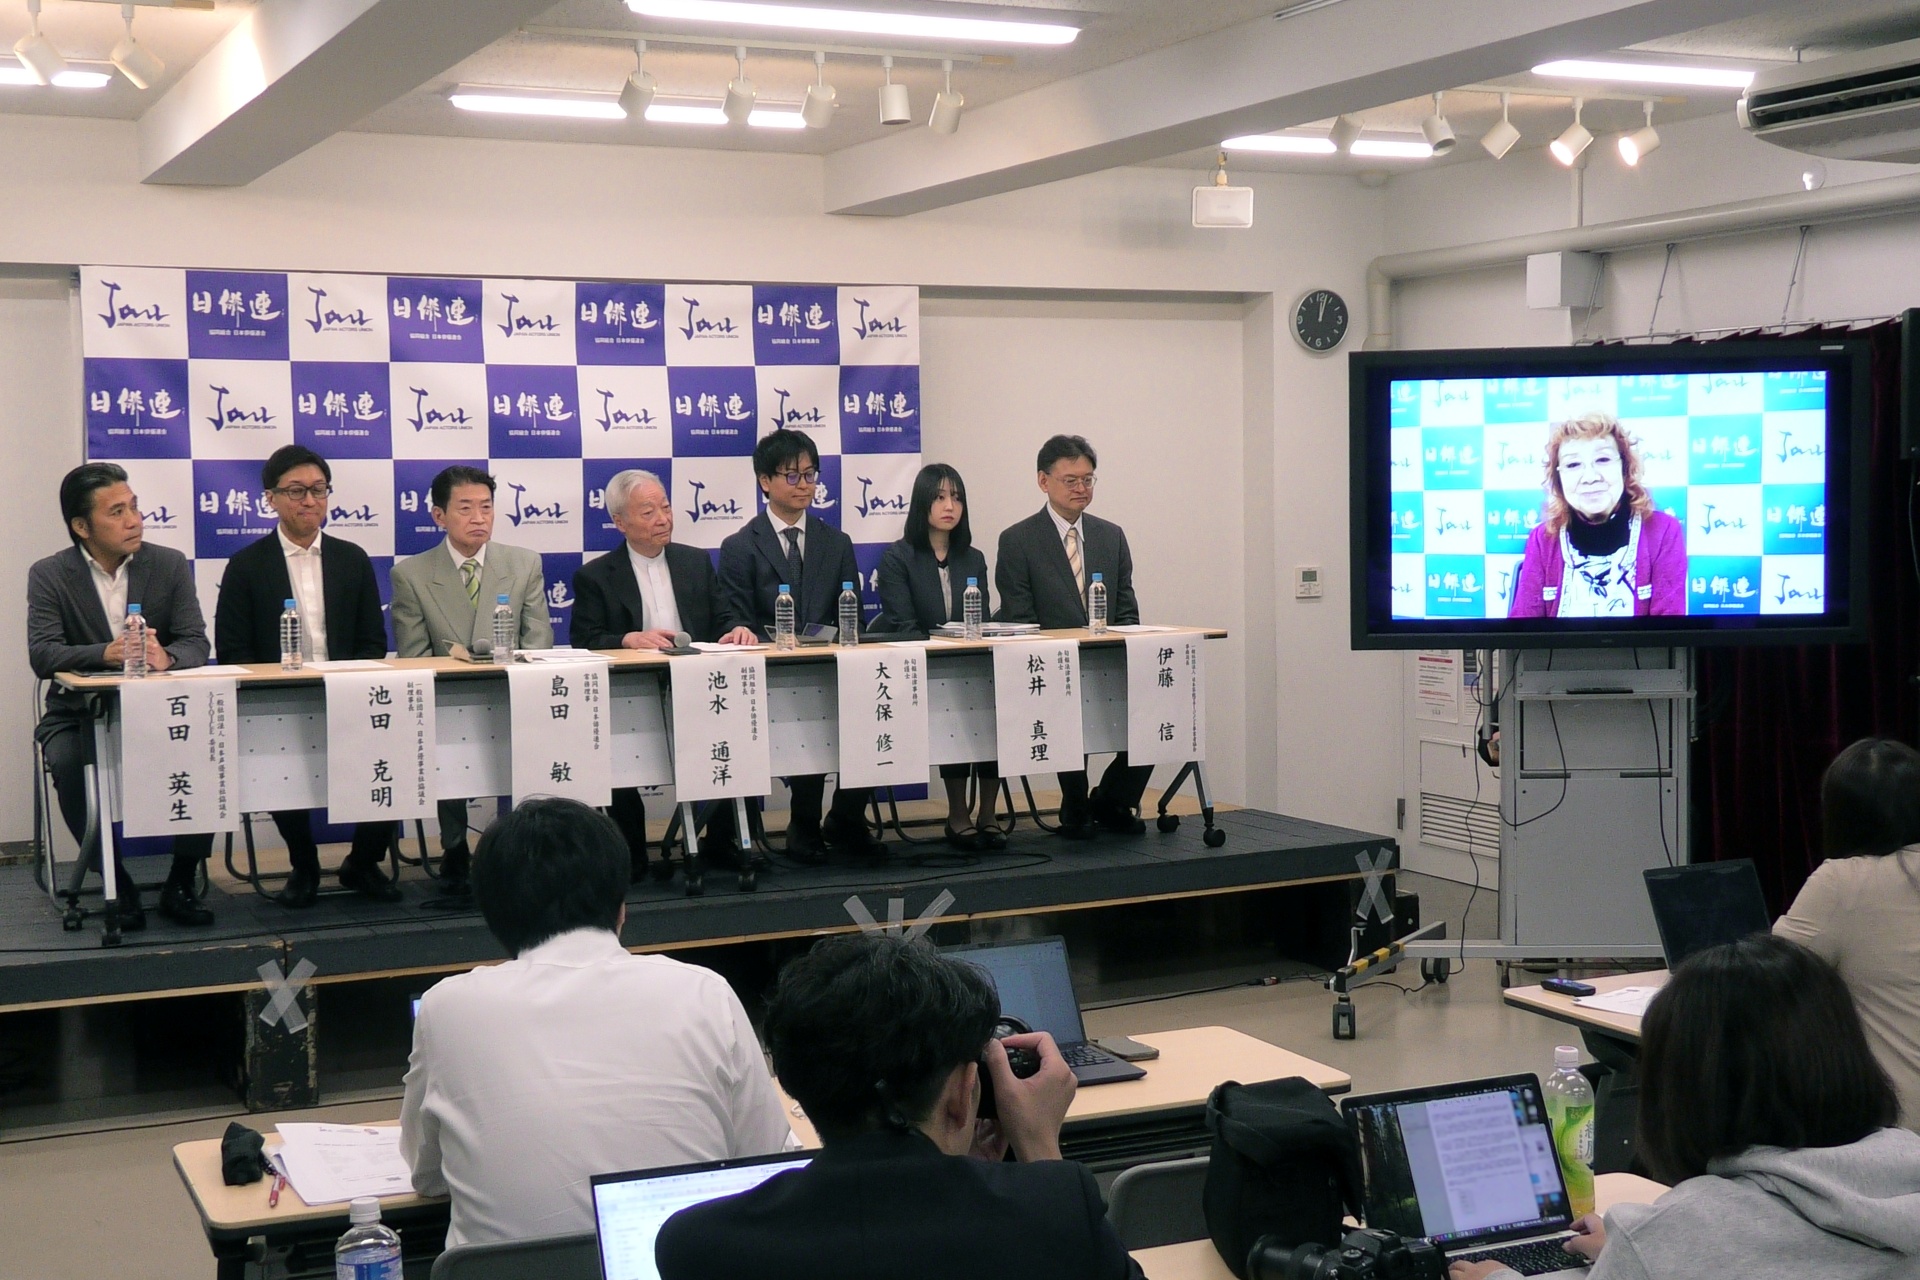
日本俳優連合は10月15日、音声に関する生成AIガイドラインを策定し、学習・生成・公開の全段階で演者の事前同意を求めた
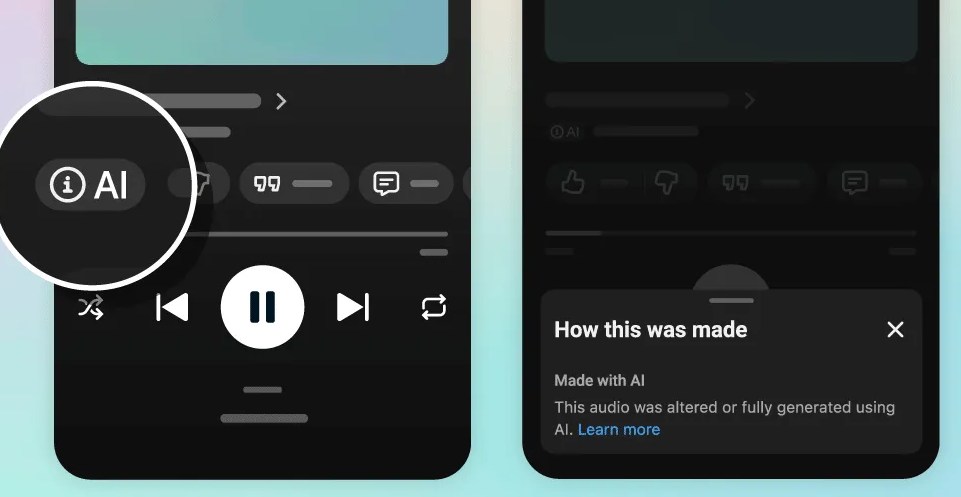
YouTubeはAIで「改変または完全に生成」された楽曲に「Made with AI」ラベルを付け始めた
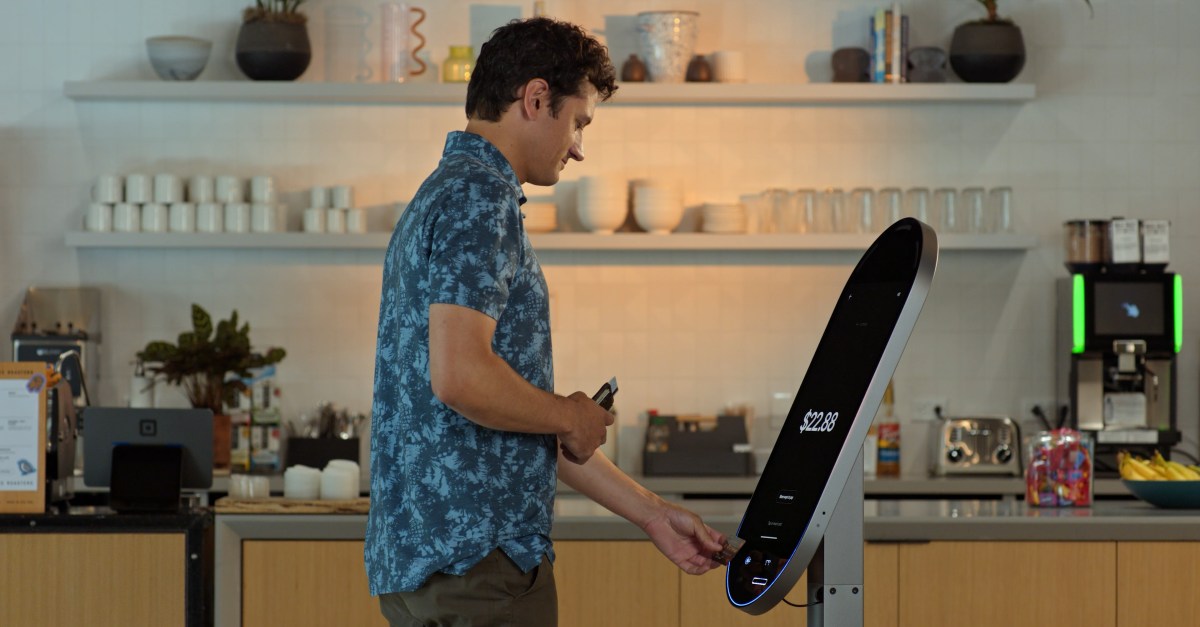
Squareは、21.5インチのタッチスクリーンと、販売店のメニューを理解して音声で注文を受け付けるAI音声レイヤーを備えたピル型の注文端末「Square Kiosk」を発売した
Appleの研究者らはWhisper-smallエンコーダーがCS-FLEURSの14言語ペアで音声からコードスイッチングを検出し平均F1 0.798、CNNの0.776、HuBERT線形の0.751を上回ったと発表した
EmbeddingGemma 2を流用し、約22万9000語から音声に合う語を選ぶ小規模モデルを組み合わせたEmbedding Gemma Transcribeが、macOS 14以降のApple Silicon搭載Ma…
Deezerは、検索結果からAI生成の楽曲やアルバム、関連アーティストを除外できるトグル機能を開発中だと明らかにした