何が起きたか
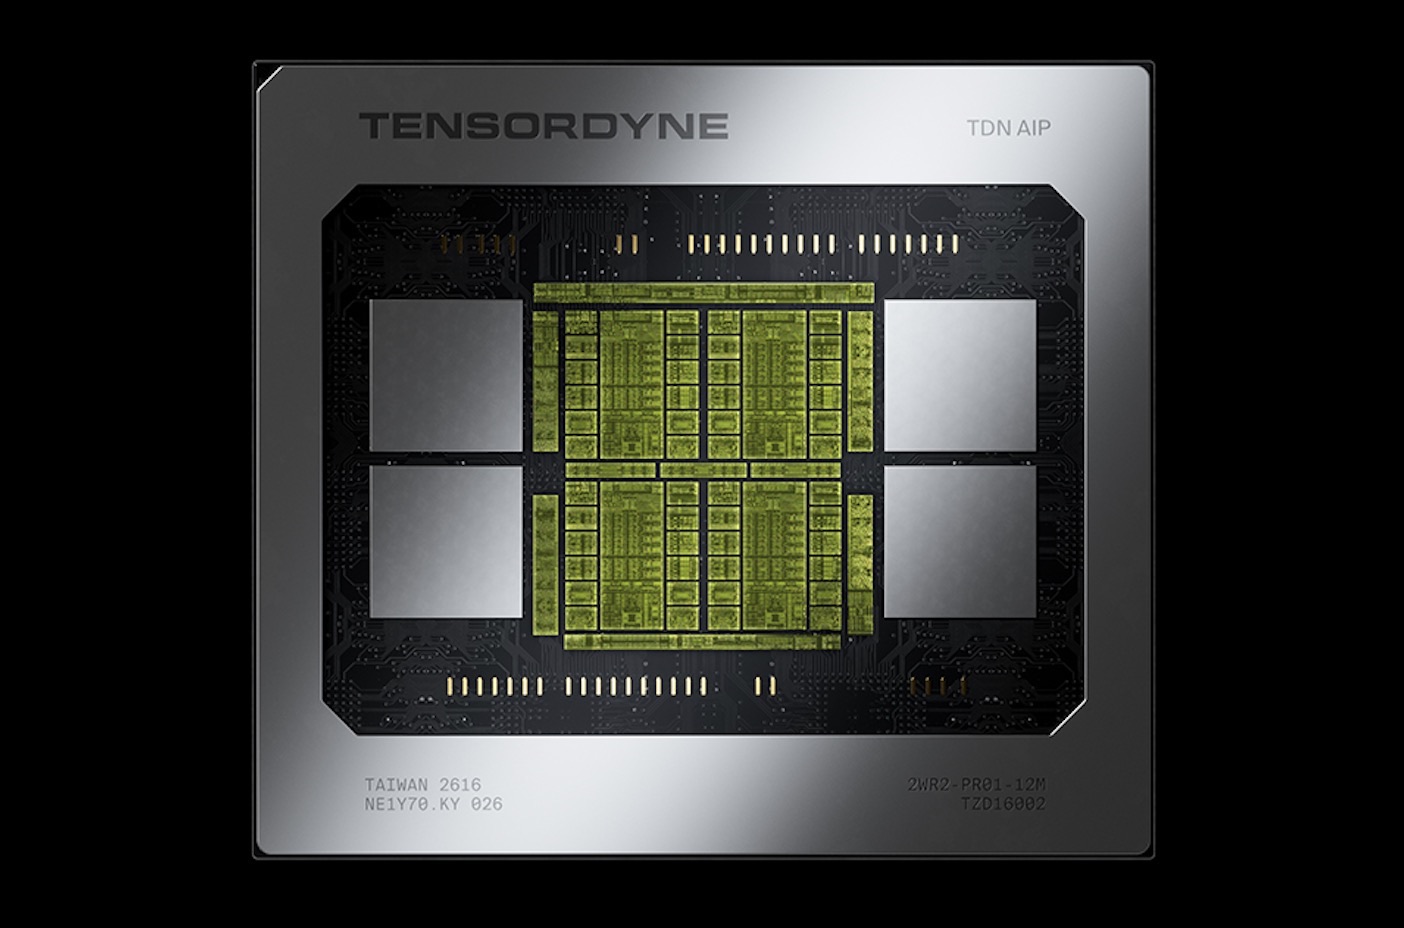
Tensordyne が 3nm プロセスで製造した AI チップ Napier と、それを 72 個搭載したラック規模システムを発表しました。掛け算を足し算に変換する対数演算を採用し、従来よりメモリ領域を確保することで、大規模言語モデルの推論処理を効率化する構想です。
なぜ重要か
現在の AI インフラは単なる計算速度よりも、メモリ帯域幅や電力効率、冷却の制約が推論性能を左右するようになっています。Tensordyne は 1 ラック 120kW で 2 兆パラメータのモデルを毎秒 1,300 トークン処理できると主張しており、NVIDIA や AWS の同等構成よりも電力消費を削減する可能性があります。
注目点
ベータプログラムは Q1 2027 年に、システム出荷は 2027 年 Q2 末までの予定。ただし実際のワークロードで性能と効率が実現するか、PyTorch などの既存開発環境での互換性が確保されるか、実運用での検証が成功の鍵となります。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
次の記事へAI導入企業が「トークン」の急増コストに直面—一部企業は使用を制限し始める一方、投資拡大で利益を狙う企業も
