何が起きたか
模擬ソフト企業でClaude Opus 5.5とGPT-6 AstraはSWE-benchなどで高スコアに迫りながら、完全に遂行できたタスクは10件に1件未満だった。
なぜ重要か
ベンチマークは、こうしたエージェントが乱雑な日々の業務を自律的にどれだけ確実に回せるかを過大評価している可能性がある。明確で独立した課題は素早く終えるが、自律的な開発者としては迷走する。
誰に効くかベンチマークスコアでコーディングエージェントを評価するエンジニアリングマネージャーや開発ツールの購入担当者は、実際のチーム環境で任せられる自律作業量を過大評価しているかもしれない。
こういう要約が、毎朝あなたのメールに届きます。
この実験が重要なのは、標準ベンチマークが測らないもの、すなわち継続性を試しているからだ。AnthropicがClaudeは本番コードの80%超を書くと述べていることやSWE-benchの飽和間近といった従来の結果は、孤立した明確な課題では高い能力を発揮するエージェント像を描き出す。
模擬企業の設定は、同僚やプロジェクトボード、不完全な引き継ぎといった乱雑な要素を残したまま、エージェントに長期稼働する開発者として振る舞うよう求める。明確なタスクを素早く終えることと、全タスクの10件に1件も完了できないことの差は、弱点が単一プロンプト向けのコード生成ではなく、日々の業務を通じた作業の追跡にある可能性を示す。この解釈は報告された結果からの推論であり、主張されていることではない。
見出しがClaude Opus 5.5とGPT-6 Astraを挙げるのは、テストされた最強のモデルでさえ及ばなかったからであり、ベンチマーク飽和という背景の中でこの結果が注目に値する所以だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Wells Fargoはオンラインアクセス契約に第15条を追加する
VisaはAgentic Readyを加盟店、PSP、アクワイアラ等に拡大し、Adyen、Checkout.com、PayPal、Stripe含む140社超で始動した
ServiceNowのSPM・CWM向けBrazilリリースには、SPM向けMCPが含まれる
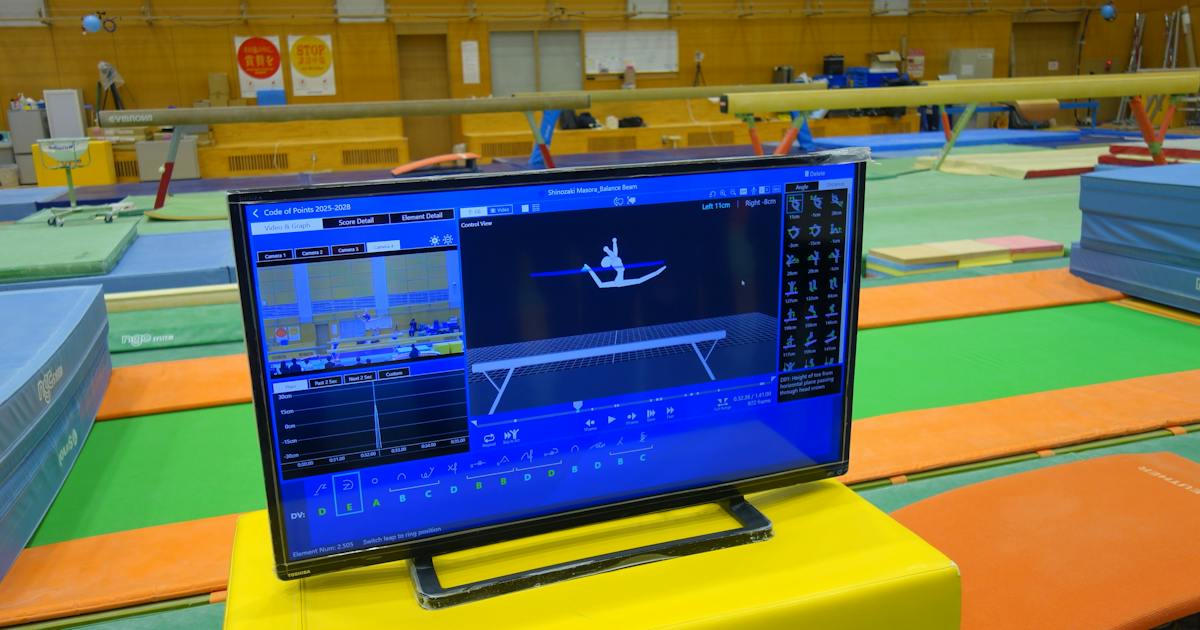
富士通は11月18日、体操の練習現場で選手の動きを3Dデータ化する「骨格認識AI」を使い、日本スポーツ振興センターと共同研究を始めると発表した
MUFGはAI開発の松尾研究所、スタートアップのThird Intelligenceと提携し、日本製AIの開発を支援すると発表した
座談会で執筆陣は、iOS 27.2のSiri AIが日本語対応し、メール返信の下書きや11月のフライト日程の読み上げを処理し、オンデバイスAIとして優れると評した