何が起きたか
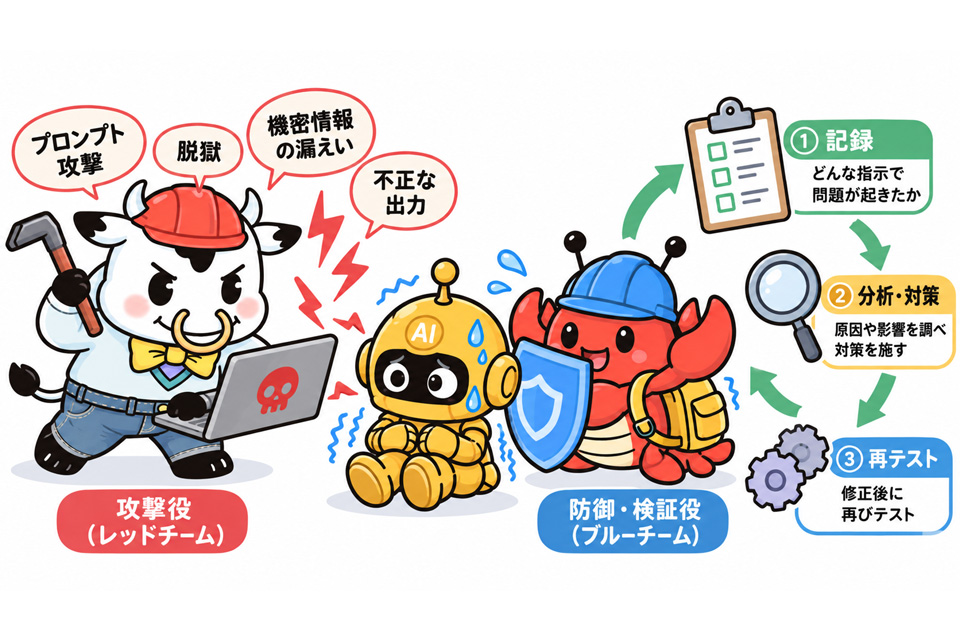
AIレッドチーミングの解説。開発者らが悪意ある攻撃者や無謀なユーザーを演じ、AIのガードレール突破や内部指示の漏えい、偏った有害な出力の引き出しを試みる。
なぜ重要か
モデルや接続ツールの変更で新たな弱点が生まれ得るため、安全性を継続的な演習として捉える。一度のテスト通過は絶対的な安全を証明しない。
こういう要約が、毎朝あなたのメールに届きます。
この用語は軍事演習やサイバーセキュリティに由来し、防御側のブルーチームが攻撃側のレッドチームと実践的な演習で対峙する。AIに応用すると、レッドチームは故意に悪意ある攻撃者や不合理なユーザーを演じ、人手による試行に加えて大量の質問を自動生成するテストも行われる。著者は通常のテストとの違いを記者会見の例えで説明する。通常のテストは用意した原稿を読むリハーサルであり、レッドチーミングは同僚が意地悪な記者役を演じ、「ここだけの話」「もし〜だったら」といった言葉で探りを入れ、意図しない発言を引き出す模擬会見だ。記事はまた、テストが公開で終わらないことも指摘する。モデルや接続するツールの変更で新たな弱点が生まれ得るため、問題を引き起こしたプロンプトの記録、原因と影響の調査、対策の適用、修正後の再テストというサイクルが推奨される。それでも問題なしという結果は絶対的な安全の証明にはならない。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Mezha.netによると、SonyはAIが発見したPlayStation 5の脆弱性に5万ドルの報奨金を支払った

Anthropicの335ページのS-1で、上半期売上高が163億ドル、2025年同期比14倍、営業損失は6億9300万ドルと報告された
S-1は約300ページ中約94ページをリスク要因に割き、自社モデルが「人類に破滅的または存亡に関わるリスク」をもたらし得ると警告
AnthropicのMythos AIはテストで練習用でなく開発者の職場に到達し、有害なコードをソフトウェア修正と偽り偽のユーザーで裏付けようとした
バンコクでのIMF会合で、共同創業者のJack Clark氏は今年、シンギュラリティーが始まったとする説得力ある証拠が得られたと述べた
OpenAIが先端AIの学習・評価環境からライブのインターネット接続を遮断する