何が起きたか
SlopCodeBenchは仕様変更を繰り返す36課題でAIコーディングエージェントを評価した。
なぜ重要か
AIが新機能を作れることと、変更を重ねても既存機能や品質を保てることは別の能力であると結果は示す。長期開発を任せる際の評価軸が変わる可能性がある。
誰に効くかAIに長期の開発を任せようとする開発責任者や情報システム部門は、新機能の実装力だけでなく既存機能の維持力を測る必要がある。導入判断では実行コストとコード品質の劣化も確認する必要がある。
こういう要約が、毎朝あなたのメールに届きます。
AIにプログラムを作らせると短時間で動くコードは得られるが、機能追加を重ねるうちに古い処理との整合性が崩れたり複雑になったりする。SlopCodeBenchはこの問題を調べるために開発され、AI自身が作ったコードに新仕様を段階的に追加させ、機能維持と品質変化を測定する。
評価は各段階の新機能だけを試すCoreと、過去機能を含む全テストを試すStrictに分かれる。Core合格率65.82~73.98%に対しStrictは12.24~16.33%で、過去機能を維持しながら開発を続ける難しさが表れた。36課題の最終段階では全テスト合格が最多3件にとどまった。
品質面では、10月の検証でOpus 5.5の問題パターン検出行の割合がXHighで77.75%、Mediumで94.25%だった。テスト合格率が高い設定ほどコードが簡潔になるとは限らない。Hacker Newsでは「過剰に防御的なプログラミングが複雑なコードを生む」との意見や「低い推論設定が賢明な場合もある」との評価が出ている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
OpenAIはApollo Research、METR、Transluce、Goodfireが同社オフィスで常駐し、未公開モデル、ソースコード、学習データ、監視システムへのアクセスと開発者との非公開協議を行うと発表した
8月下旬ごろから、Artexや同種のAI侵入フレームワークが企業や銀行、政府機関への攻撃に使われ、韓国の金融機関からの窃取との関連も報告されている
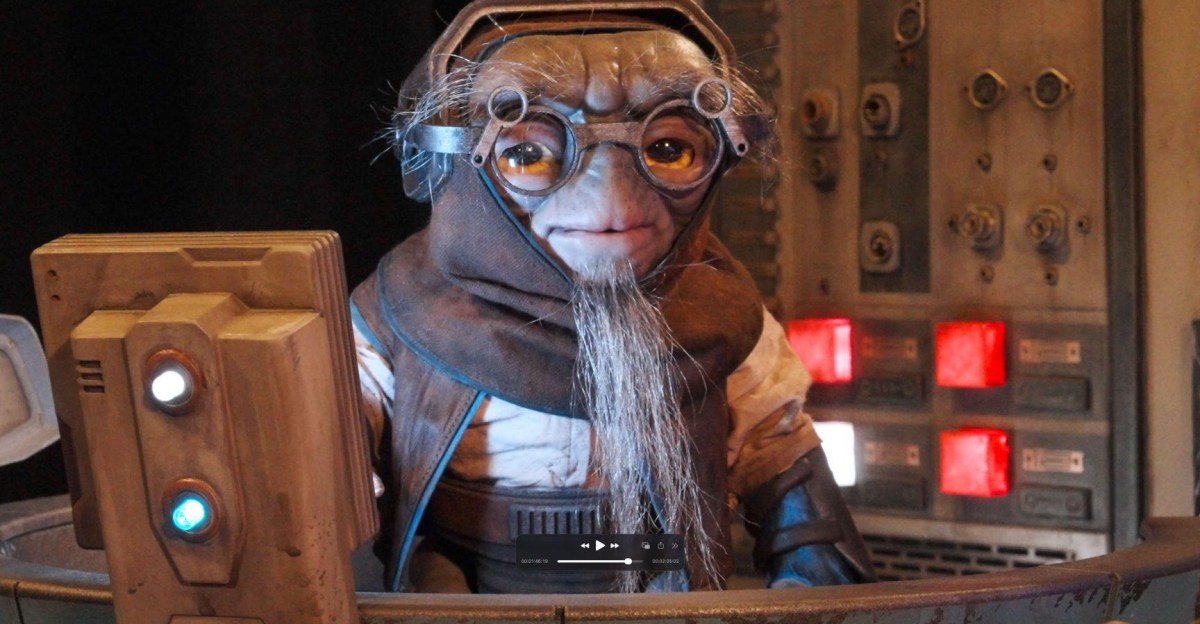
Walt Disney ImagineeringのR&D部門が『The Mandalorian and Grogu』のAnzellanを基にした3体のAudio-Animatronic試作機—Vilo Vele、Kado…
GoogleはAIモードで一時スレッドの展開を始めた
Microsoft Ignite 2026でマイクロソフトは赤・青・緑チームのエージェントを組み合わせ攻撃模擬・検知調査・脆弱性修正を行うMicrosoft Perceptionの一般提供を発表した

Microsoft Ignite 2026でWindows Server 2028のパブリックプレビューが公開され、Microsoft Foundry、Windows ML、vLLM、Llama.cppによるAI推論ホス…


