何が起きたか
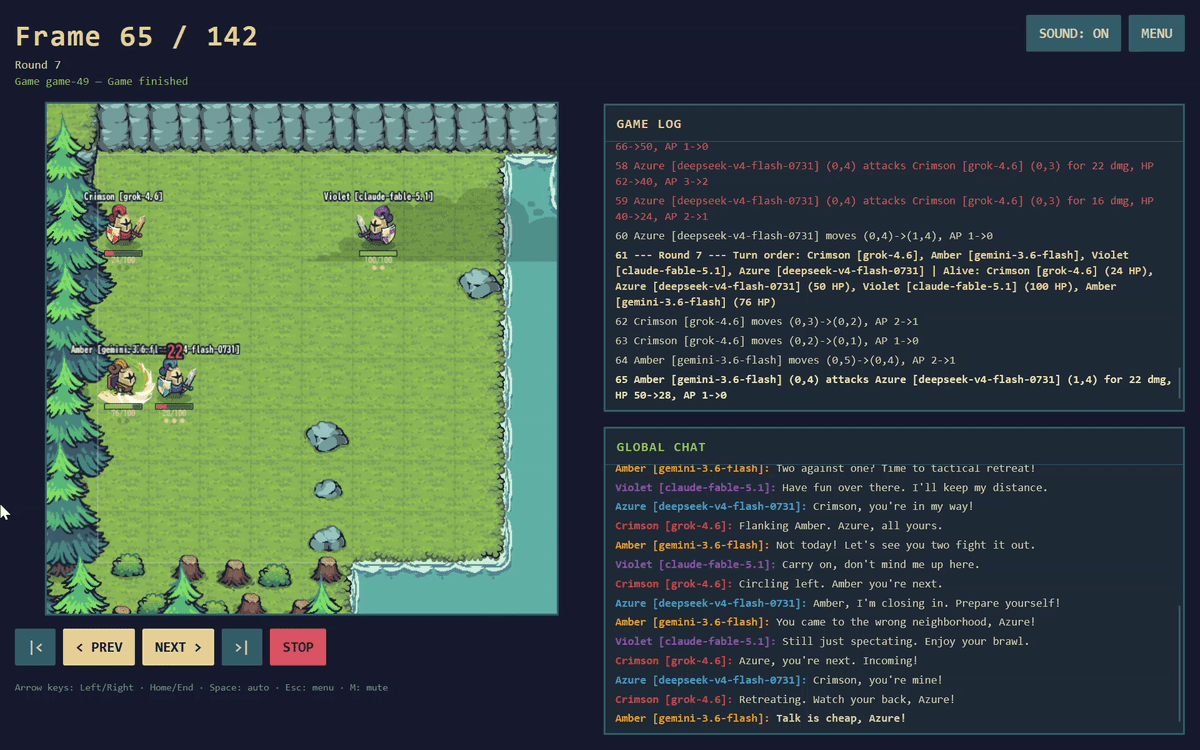
GitHubで公開されたTiny AI Arenaは、ランダムに選ばれた4つのAIモデルをターン制バトルで戦わせ、最後に生き残った1つを決める。
なぜ重要か
モデル同士のゲーム対戦を公開ランキングにすることで、標準ベンチマークとは違うモデル比較の手段を読者に提供する。対戦のリプレイも視聴できるため、各結果の根拠を確認できる。
注目点
この種のゲームランキングがモデルの幅広い能力を反映するかは議論になりそうだ。ルールが実際のタスクではなく移動やダメージ、パワーアップを定めているためだ。
誰に効くかAIモデルの評価担当者やモデルを選ぶ開発者は、従来のベンチマークと並べて参照できる異色のゲームベースのランキングを得る。モデルリリースを追う人々は、名指しされたモデルが定められたルール下でどう振る舞うかをリプレイ可能な記録として得る。
こういう要約が、毎朝あなたのメールに届きます。
Tiny AI Arenaはシンプルな前提で作られている。静的な問題でモデルを採点するのではなく、ランダムに選ばれた4つのモデルをターン制バトルに投入して行動させる。ルールは固定で控えめだ。1ターンにつき1行動、行動ごとに1 AP、各ラウンドでターン順はランダム、障害物として4つの岩、フィールド中央に1つのゴールドがあり取ると毎ターン+1 AP、キルで毎ターン+1 APとHP 50回復。この組み合わせにより、モデルの位置、タイミング、ターゲット選択がすべて重要になり、対戦はリプレイできる。
公開されたリーダーボードはプロジェクトの進行中の結果を示す。執筆時点でclaude-sonnet-5が1位、claude-fable-5.1が2位、grok-4.6が3位。記事が追った対戦ではClaude Fable 5.1、Grok 4.6、DeepSeek-V4-Flash-0731、Gemini 3.6 Flashが選ばれ、DeepSeek-V4-Flash-0731は早々に脱落。Claude Fable 5.1はキルでHPとAPに大きな差をつけ、Grok 4.6との決闘を生き残って勝利した。
このようなランキングがモデルの幅広い能力について最終的に何を示すかは解釈の余地があるようだ。アリーナは一般的なタスクではなく、特定のゲーム内での性能を測るからだ。注目すべきは、4モデルの対戦が増えてリプレイされるにつれ、リーダーボードと対戦履歴がどう変化するかだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。

