何が起きたか
PositronのCameron McCaskill氏は、AIインフラの処理のうち約3分の2が推論となり、学習が3分の1になったと述べた。2023年は学習が約85%だった。
なぜ重要か
McCaskill氏によると、推論が経済性を決めるようになり、買い手は安価な電力と迅速な導入を重視している。これは低コストメモリと空冷サーバーを使うPositronに有利だ。
誰に効くかMcCaskill氏によると、AIインフラの買い手であるクラウド事業者、ネオクラウド、モジュール型データセンター事業者は、チップ性能と同じくらい電力、冷却、導入速度を重視するようになった。Positronのような推論優先のチップメーカーはこの変化を取り込もうとしている。
こういう要約が、毎朝あなたのメールに届きます。
McCaskill氏の数字は急速な逆転を示している。2023年はAIインフラの処理で学習が約85%を占め、推論は15%だった。McCaskill氏によると、現在は推論が約3分の2、学習が3分の1だ。この変化が重要なのは、推論の処理は物理的な要件が異なるためだ。学習クラスタで使う高密度で高価なメモリよりも、安価な電力と迅速な導入を必要とする。
Positronの設計はそれを反映している。同社はMcCaskill氏が供給が非常に限られ高価だと表現した広帯域メモリを避け、汎用メモリを採用した。この選択により、サーバー1台は約4,500ワットに収まり、空冷の部屋でも使え、Titanサーバーのラック1台分も40キロワットに収まる。同社の第1世代Atlasサーバーはプログラマブルチップで動作し、PositronはTitan向けに来年初めに自社シリコンのテープアウトを予定する。Oracleは今四半期に約340台のAtlasサーバーをクラウドで稼働させ、あるネオクラウド事業者はAtlasを契約しTitanの採用も約束した。
モジュール型データセンター市場はこの特性に合う。McCaskill氏によると、0.5メガワットから2.5メガワットのモジュール拠点を持つ事業者は迅速に導入でき、そうした拠点とPositronの技術を組み合わせれば、推論向け各社が90〜120日で収益化可能なトークンに到達する助けになる。Positronは9月に評価額50億ドルで8億7500万ドルを調達し、推論支出がチップの配備先を形作る中で競争できる立場にある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Nvidiaの研究チームは小説全体を読み込ませるのは高コストな過剰装備だと指摘
Search Consoleベースの「検索カルテ」は28日間の指標に開始日と終了日(例:2026-10-19から2026-11-15)を付け、「直近28日間」を置き換えた
Museをカスタマイズする実践者が他のモデルに文書や設計案をレビューさせ、Gemini判定役がVertex AIとOpenRouter経由で各指摘を評価する多段構成を組んだ
筆者は身長と「スリムなクロップドトップスが欲しい」とだけMuseに伝え、クラウド上でZOZOTOWNを閲覧させてサイズ・在庫・セール価格を確認した
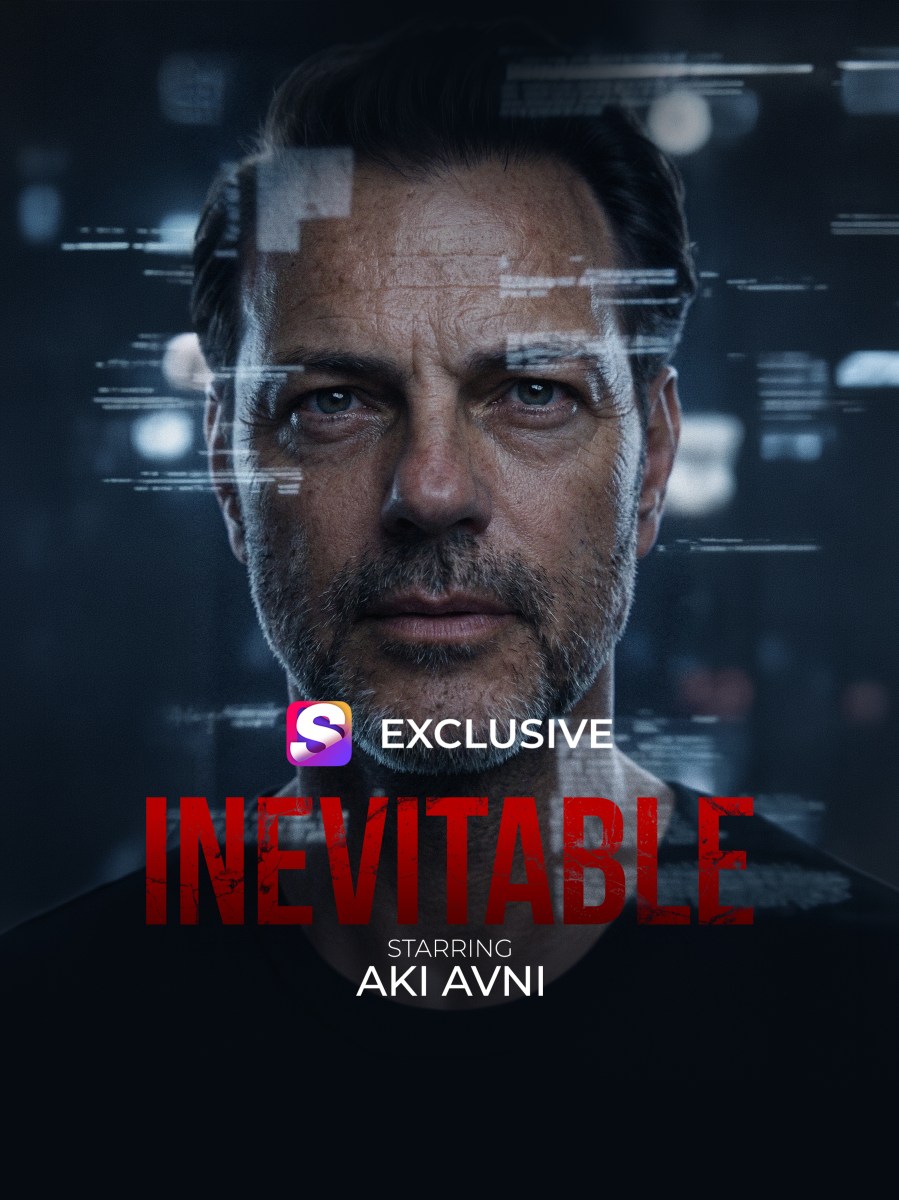
Shorticalは先週ロサンゼルスで「Inevitable」を初公開した
OpenAIはGPT-6.2 AstraとSol向けに文体・主体性・コーディングを扱うコピー可能なプロンプトを公開し、Responses APIで会話履歴を編集すると以前の推論内容が破棄される可能性があると警告した