何が起きたか
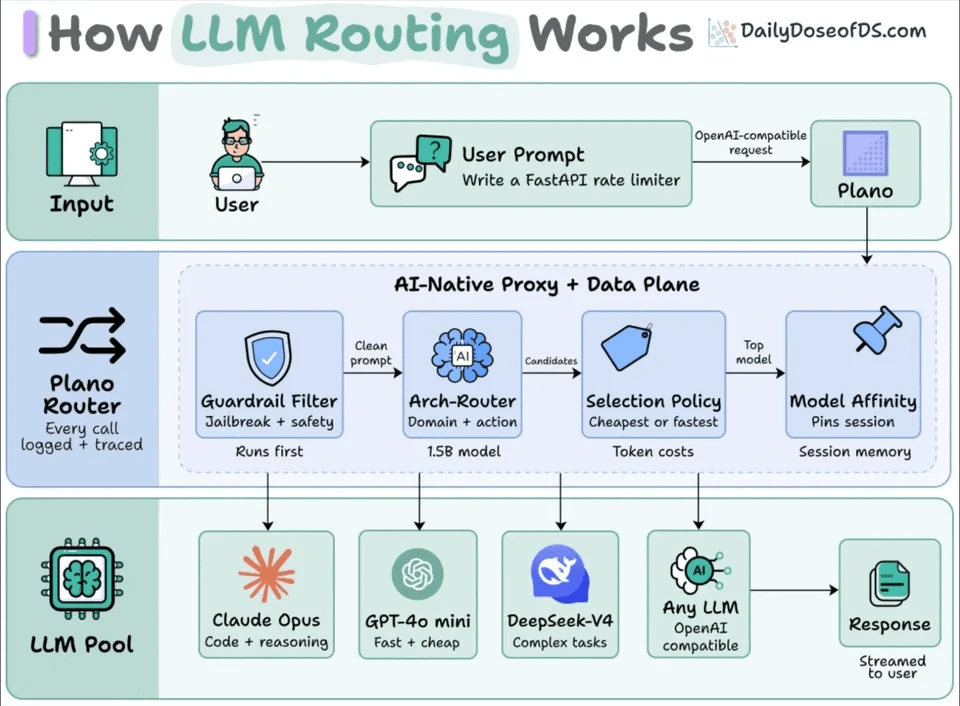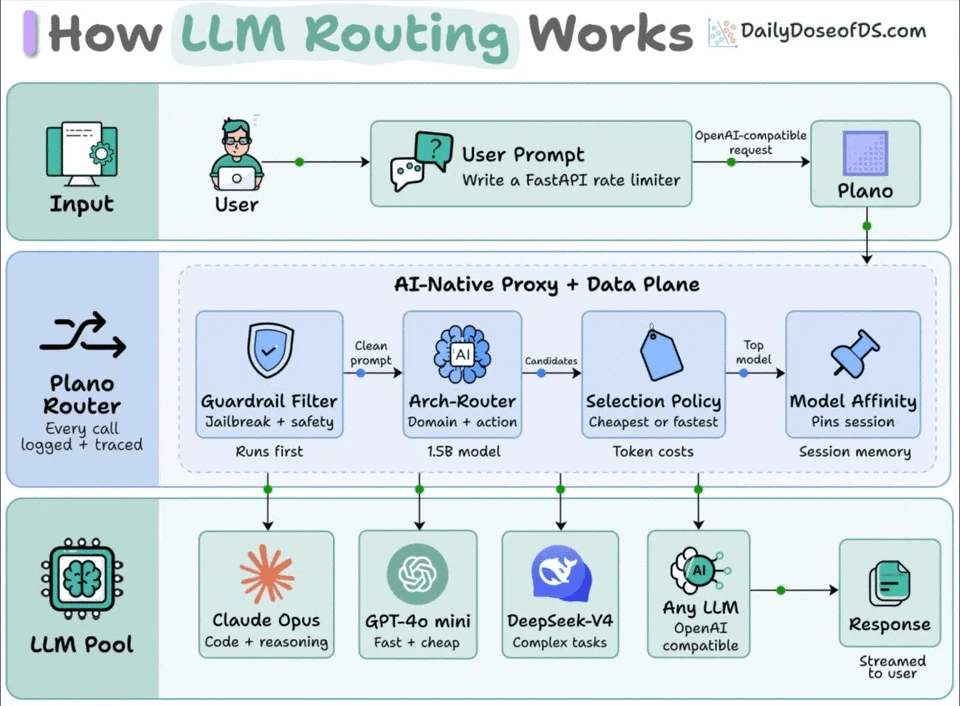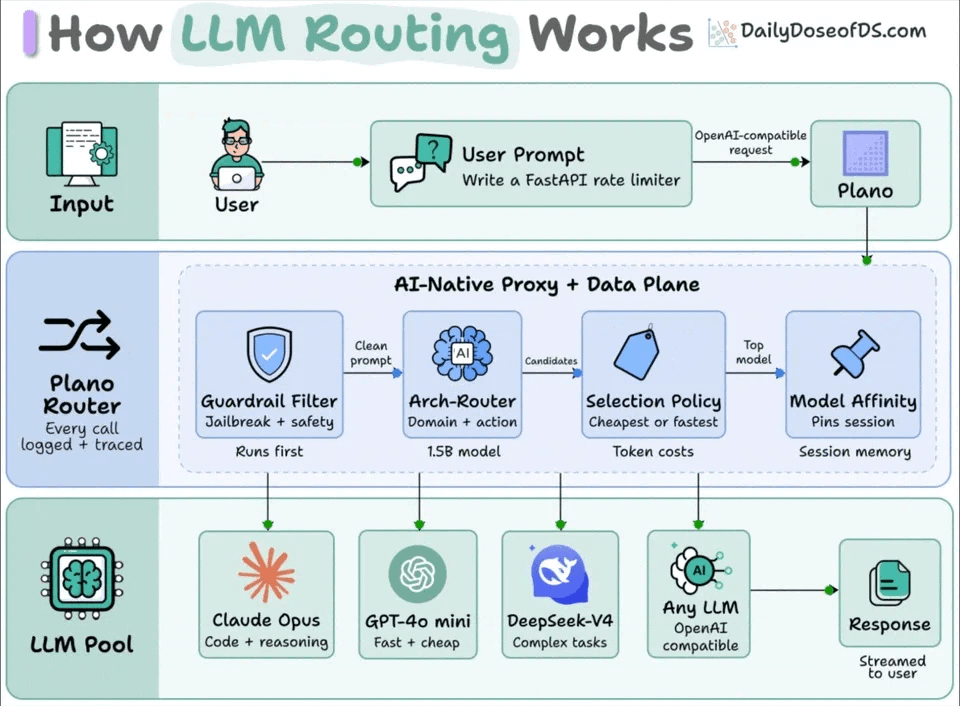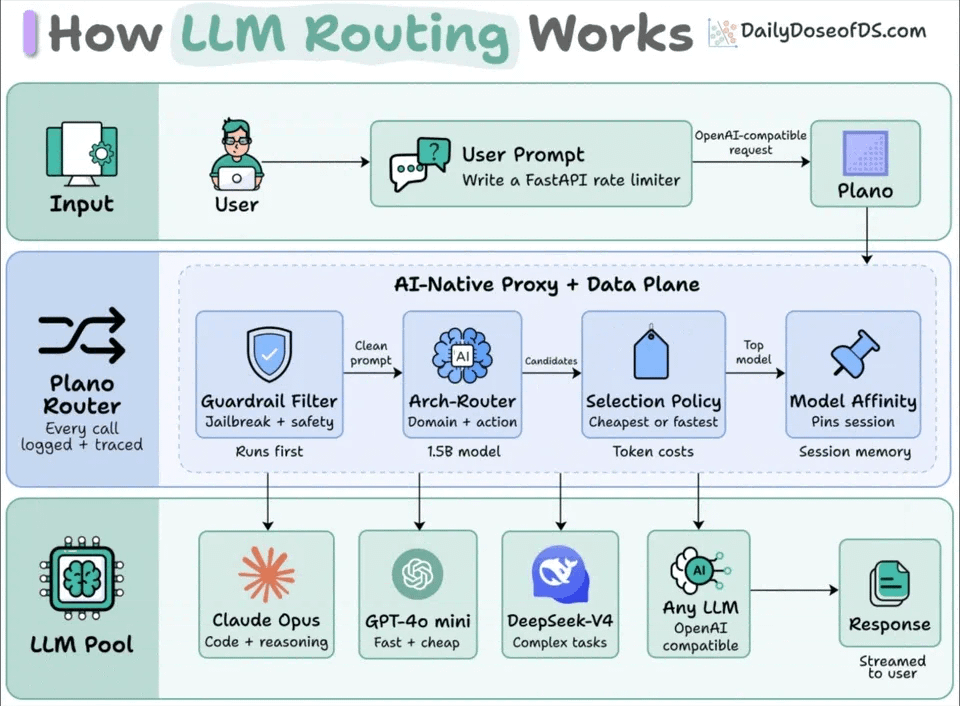
DigitalOceanがInference Routerを発表。小規模モデルでタスクを振り分け、セッションを1モデルに固定してキャッシュ消失を防ぐ。
なぜ重要か
単純なルーティングは1モデル利用より高コストになり得るが、今回のテストでは94%のコスト削減と77%の高速応答を実現。
注目点
ルーターの効果は意図の正確な識別とキャッシュ再利用にかかる。実トラフィックや複雑なコーディング課題での性能維持が注目される。
誰に効くかコーディングアシスタントなどのエージェント型アプリケーションを開発するエンジニアリングチームに影響する。複雑な社内ルーティングロジックの維持か、DigitalOceanのインフラ採用によるコスト削減と性能向上かの選択が可能になるためだ。
こういう要約が、毎朝あなたのメールに届きます。
本稿はLLM搭載エージェント構築の核心的問題、すなわち予測不能な障害と高騰するコストに焦点を当てる。単純タスクを安価なモデルに送るルーティングは明白な解決策だが、素朴な実装はエージェントループで逆効果となり、二重推論やモデル切替によるキャッシュ無効化でコストを増やすと解説する。
DigitalOceanのInference Routerは、ルーティングをインフラに統合し、これらの問題解決を試みる。意図理解のために専用設計の小規模モデルを使い、汎用モデルへのプロンプトより高速かつ高精度とされる。さらにセッション固定でキャッシュ親和性を維持し、マルチターンのエージェント対話に不可欠な仕組みを提供する。
より広い含意として、AIのコストと性能管理がインフラレベルで行われる流れが進む。チームの論点は「ルーティングが有効か」ではなく、「自前で構築・維持するか、マネージドサービスを採用するか」へと移る。本稿は後者の選択肢が現実的になり、チームがルーティング層よりもコアとなるアプリケーション開発に集中できる可能性を示唆する。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
OneTrustはOneTrust CORIEを基盤とするFall '26リリースを発表し、厳選した基盤モデルライブラリからモデルの関連付けと非推奨指標を継続的に更新するAI台帳を追加した

11月18日の日経「Dialogues on the Future」で、ソフトバンクグループの孫正義氏はAnthropicへの出資見送りを「僕の失敗の一つ」と語った

Cassava TechnologiesがNvidia製チップ購入のため最大10億ドルの調達を検討

Microsoft Ignite 2026でマイクロソフトは赤・青・緑チームのエージェントを組み合わせ攻撃模擬・検知調査・脆弱性修正を行うMicrosoft Perceptionの一般提供を発表した

Microsoft Ignite 2026でWindows Server 2028のパブリックプレビューが公開され、Microsoft Foundry、Windows ML、vLLM、Llama.cppによるAI推論ホス…

BrightAIがSmith Point Capital主導のラウンドで97百万ドルを調達


