何が起きたか
AWSがRay Serve DLCを発表。PyTorch、GPUドライバ、Ray Serveを同梱した事前構築コンテナで、モデル推論用。
なぜ重要か
TorchServeはメンテナンス停止。セキュリティパッチや互換性更新が得られず、Ray Serve DLCは定期更新でバージョン差異を解消。
注目点
移行が鍵。導入例はg5.xlarge 1台とA10G GPU 1基でQwen3-VL-2Bを稼働。
誰に効くか現在TorchServeで推論を運用するソフトウェアエンジニアやMLエンジニアは、新しいソリューションを見つける必要がある。移行しなければGPUスタック全体の維持が負担となるが、AWSのRay Serve DLCはサポート付きの代替案を提供し、その負担を軽減する。
こういう要約が、毎朝あなたのメールに届きます。
TorchServeはPyTorchモデル推論の標準だったが、現在は公式にメンテナンスされず、チームは脆弱性パッチ、CUDAやPyTorchのバージョン管理、統合デバッグなど、推論スタック全体を自己管理する必要がある。AWSのRay Serve DLCは、このギャップを埋め、確立されたDeep Learning Containersの手法をトレーニングから推論に拡張する。OS、GPUランタイム、PyTorch、Ray Serveの事前テスト済み組み合わせを提供し、バージョン差異をなくし、定期的なセキュリティ更新を行う。
ブログでは、ビジョン言語モデル(Qwen3-VL-2B)をAmazon EKSの単一GPUノードで稼働させる具体例を示す。アーキテクチャは意図的にシンプル(ポッド1つ、GPU 1基)だが、KubeRayを使ったマルチノードへのスケーリングも可能と記す。最小限の機能セットに焦点を当てることで、エンジニアは移行経路をテストし、Ray Serve DLCがニーズに合うかを評価しやすい。
エンジニアリングチームにとって、TorchServeからの移行は、自己管理スタックの運用負担と、タグの変更だけでアップグレードできるサポート付きコンテナの利便性の比較になるだろう。Ray Serve DLCの成功は、カスタムモデルへの柔軟性と、マネージドコンテナが実際にインフラの負担を軽減できるかどうかにかかっている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
サカナクション山口一郎が10月27日のYouTube生配信で、パスタに混ざったカメムシの句をChatGPTに頼むと、「うんうん、聞いてるよ」と相づちだけを返し、「こんな壊れ方するの?
IteraのLLMOチェキが「AI質問の提案」を開始

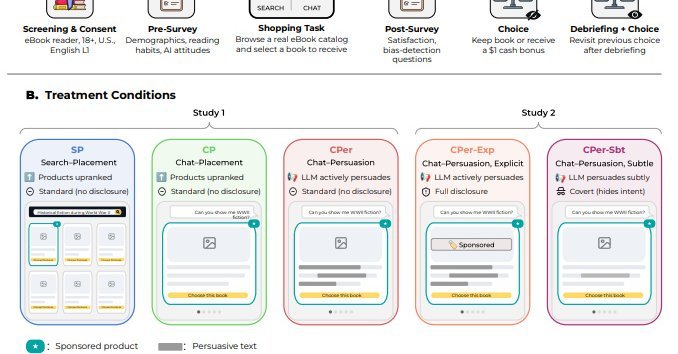
プリンストン大学の研究で、参加者2,012人と約5,500冊を使い、広告商品の選択率は検索結果経由22.4%、中立のチャット配置26.8%、AIに秘密裏に説得を指示すると61.2%だった
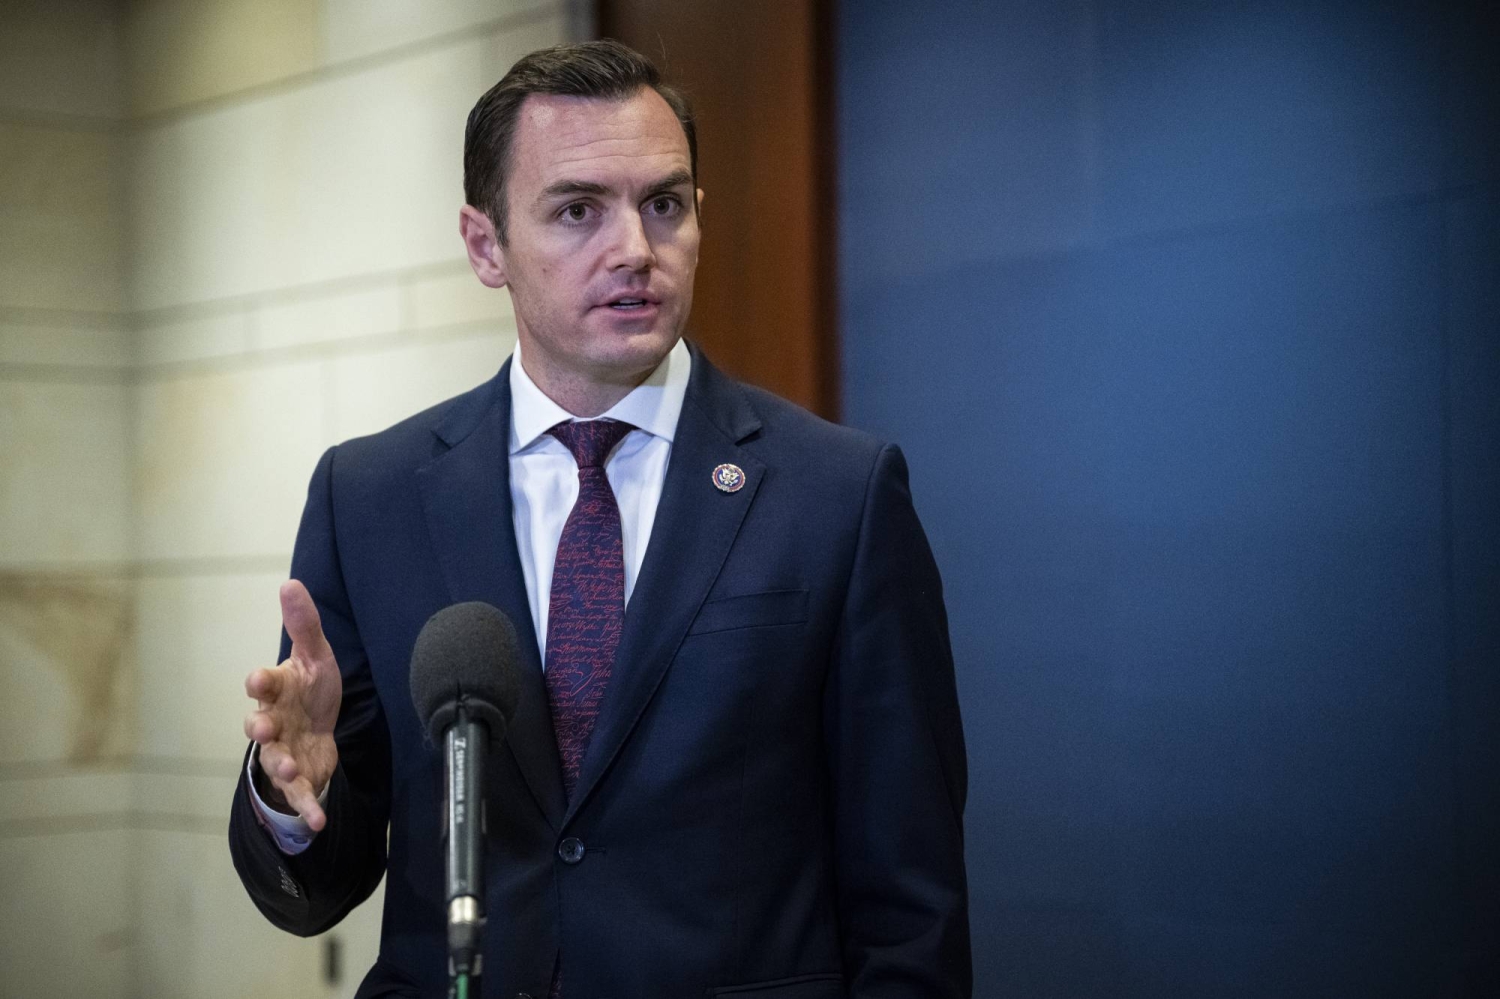
Palantirの防衛部門責任者Mike Gallagher氏は水曜日、AI開発における台湾の役割が増大し、習近平国家主席が北京の台湾構想を実行に移す必要が生じかねないと述べた
Project Tadoriの「ワイカメ」が10月29日、無料の対話型トップページを公開
NTT TechnoCrossは12月からForeSight Voice MiningにAIナビゲーションを追加