何が起きたか
MetaはTriton拡張「TLX」の詳細を公開した。warp-groupとクラスタレベルの明示的なオーケストレーションが可能。
なぜ重要か
MetaのMLインフラ全体で数カ月間の本番使用実績があることは、コンパイラのサポートを待たずに新しいハードウェア実行機能を導入できることを示す。
誰に効くかMetaのMLエンジニアやカーネル開発者、さらには大規模なトレーニングや推論を手がける他社のエンジニアも、TLXを使ってTritonで明示的なwarp-groupオーケストレーションを記述できる。アーキテクチャ固有のCUDAコードの必要性を減らし、最適化サイクルを短縮できる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
TLXはGPUプログラミングにおける広がりつつあるギャップから生まれた。NVIDIAのHopperやBlackwellといった現代のアーキテクチャは、warp特化や非同期データ移動、テンソルメモリといった実行機能への依存を強めているが、こうした機能はCUDAの細粒度のスレッド制御とTritonのブロックレベルの生産性の間に中途半端に位置している。Metaのエンジニアは、CUDAでは必要な実行構造を表現できるもののアーキテクチャ固有のオーケストレーションコードを大量に必要とし、Tritonではそうした関係の多くがコンパイラの抽象化の背後に隠れてしまうことに繰り返し直面した。その結果、新しいハードウェア世代が登場するたびにコンパイラが追いつくという問題が生じていた。
Metaの答えは、新たな独立言語を構築するのではなく、Tritonに実行指向の構成要素を第二の層として追加することだった。TLXを使えば、プログラマは計算には慣れ親しんだテンソル演算を使いながら、producer、consumer、epilogueの各warp groupやmbarrierによる同期、クラスタレベルの協調を明示的にオーケストレーションできる。同社によれば、このMIMWモデル(Multiple Instructions, Multiple Warps)はSIMTとSIMBの間にあった空白を埋め、開発者の速度を犠牲にせずにハードウェア機能を実用的に導入できるようにする。
Metaが挙げる本番での実績は3つの導入にまたがる。BlackwellでのGEMモデルトレーニング、HopperでのRecSys推論向けIn-Kernel Broadcast Optimization(IKBO)、LLM事前学習向けの分散grouped GEMMカーネルだ。Metaによれば、TLXは数カ月間本番稼働しており、GEMトレーニングでは最新バージョンが数千基のBlackwell GPU上でE2E MFU 20〜25%を達成するのを後押しし、IKBOは計算集約型ネットワークの遅延を最大3分の2削減した。Metaによれば、より広い意味では、カーネル最適化はもはやGPU専門家だけの領域ではなくなっている。MLエンジニアはTritonのPythonモデルの中で最もホットなカーネルを反復改善できるようになり、TLXはピーク性能のベンチマークだけでなく実際の本番システムで先進的なハードウェア機能を実用的に導入できるようにすることを目指している。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
CADMAGEDDONはBenchCADの64³ボクセルIoUで、1000部品のサブセットにおいて0.991を記録し、Claude Sonnet 5.5の0.963、Claude Opus 5.5の0.962、GPT-6…

CodeRabbitはOpenAI Daybreak Defense Networkに参加した
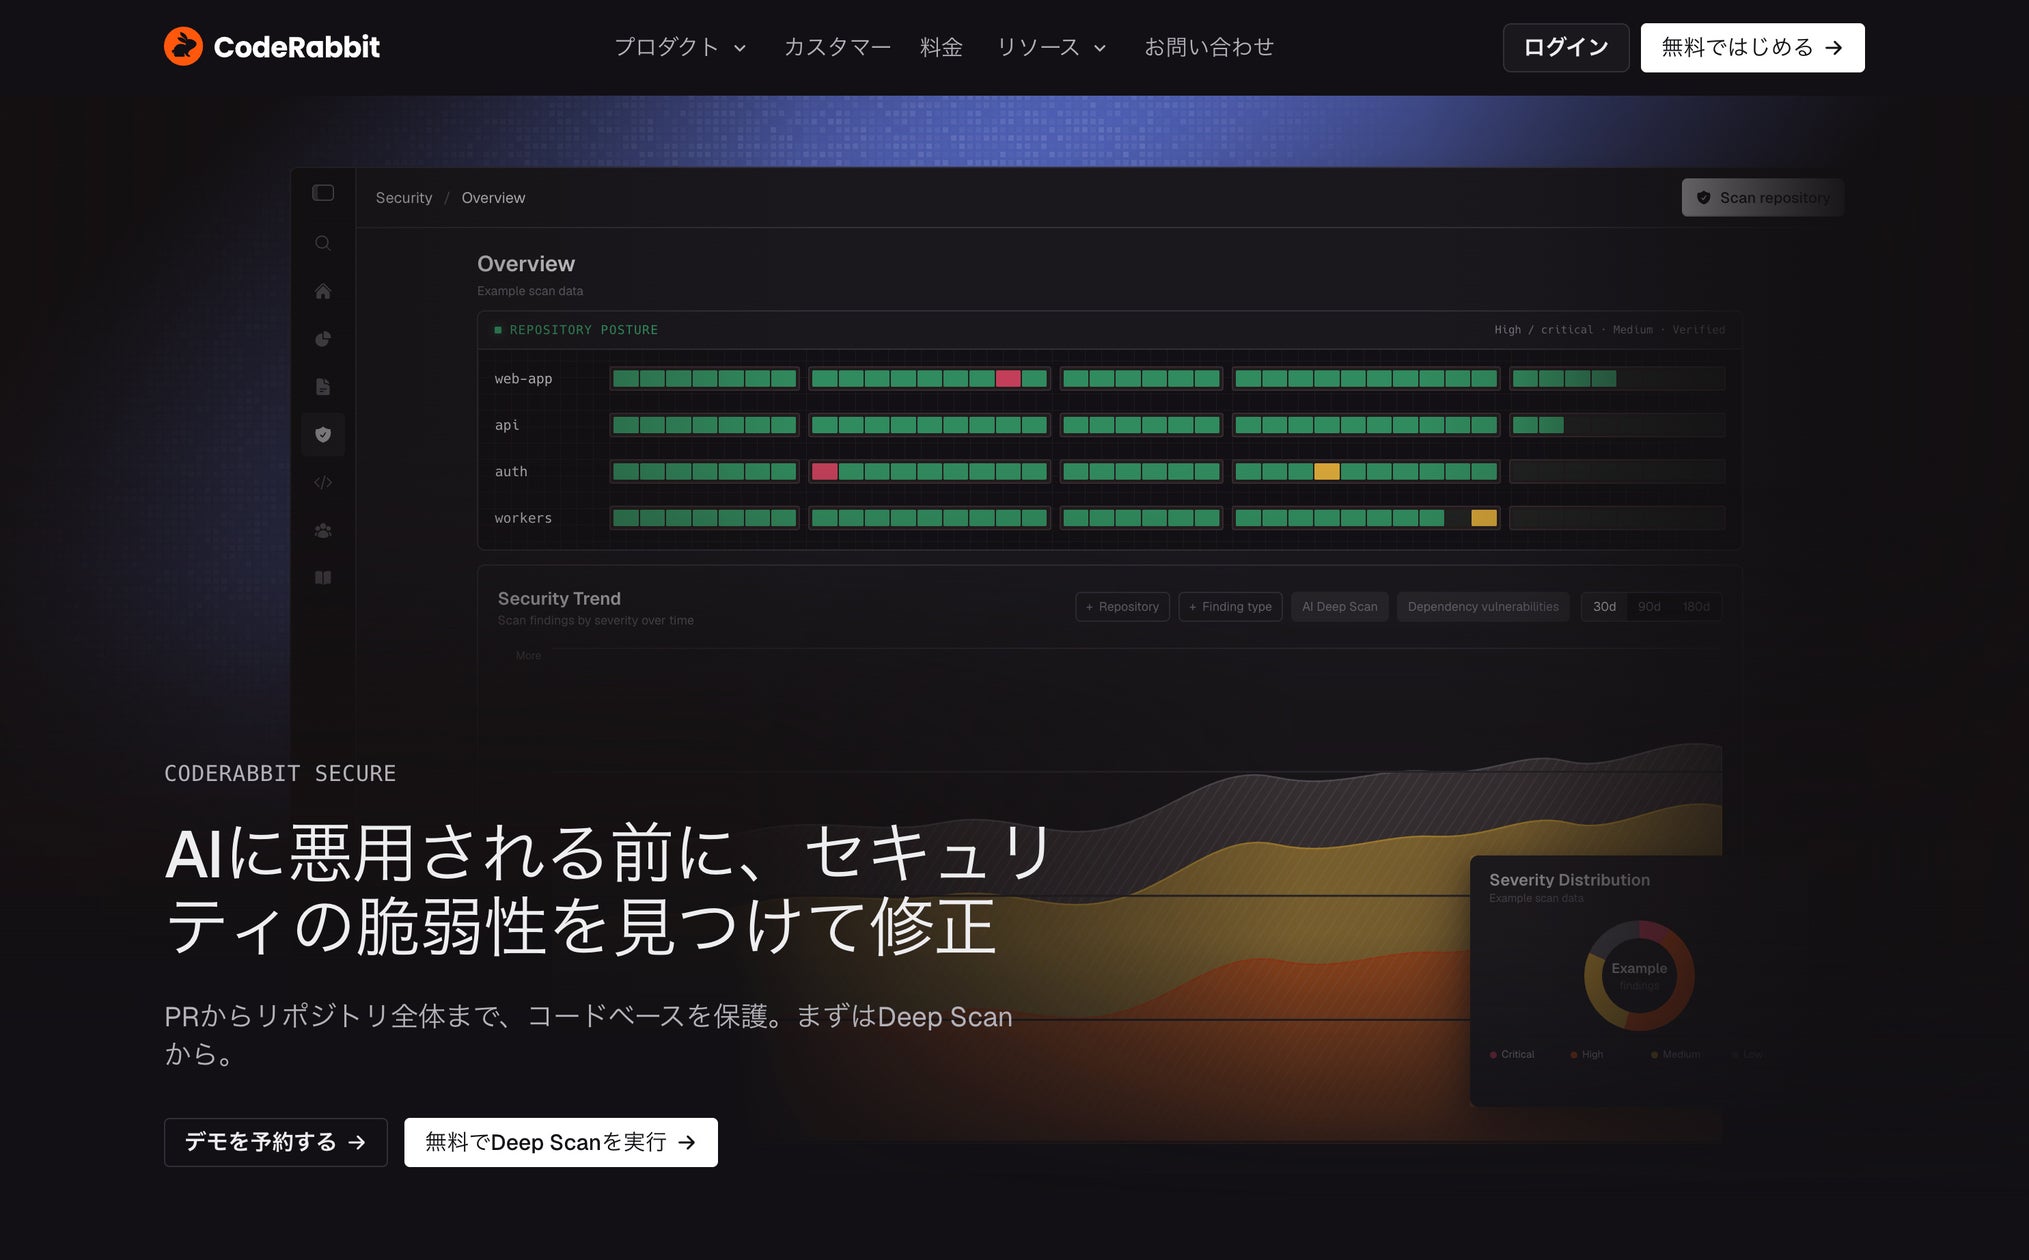
Microsoft Ignite 2026でCEOのSatya Nadella氏はCopilotを「仕事の新しいOS」と呼び、AIチャットやエージェントへの委任、アプリ開発、自律的なタスク実行を統合すると述べた
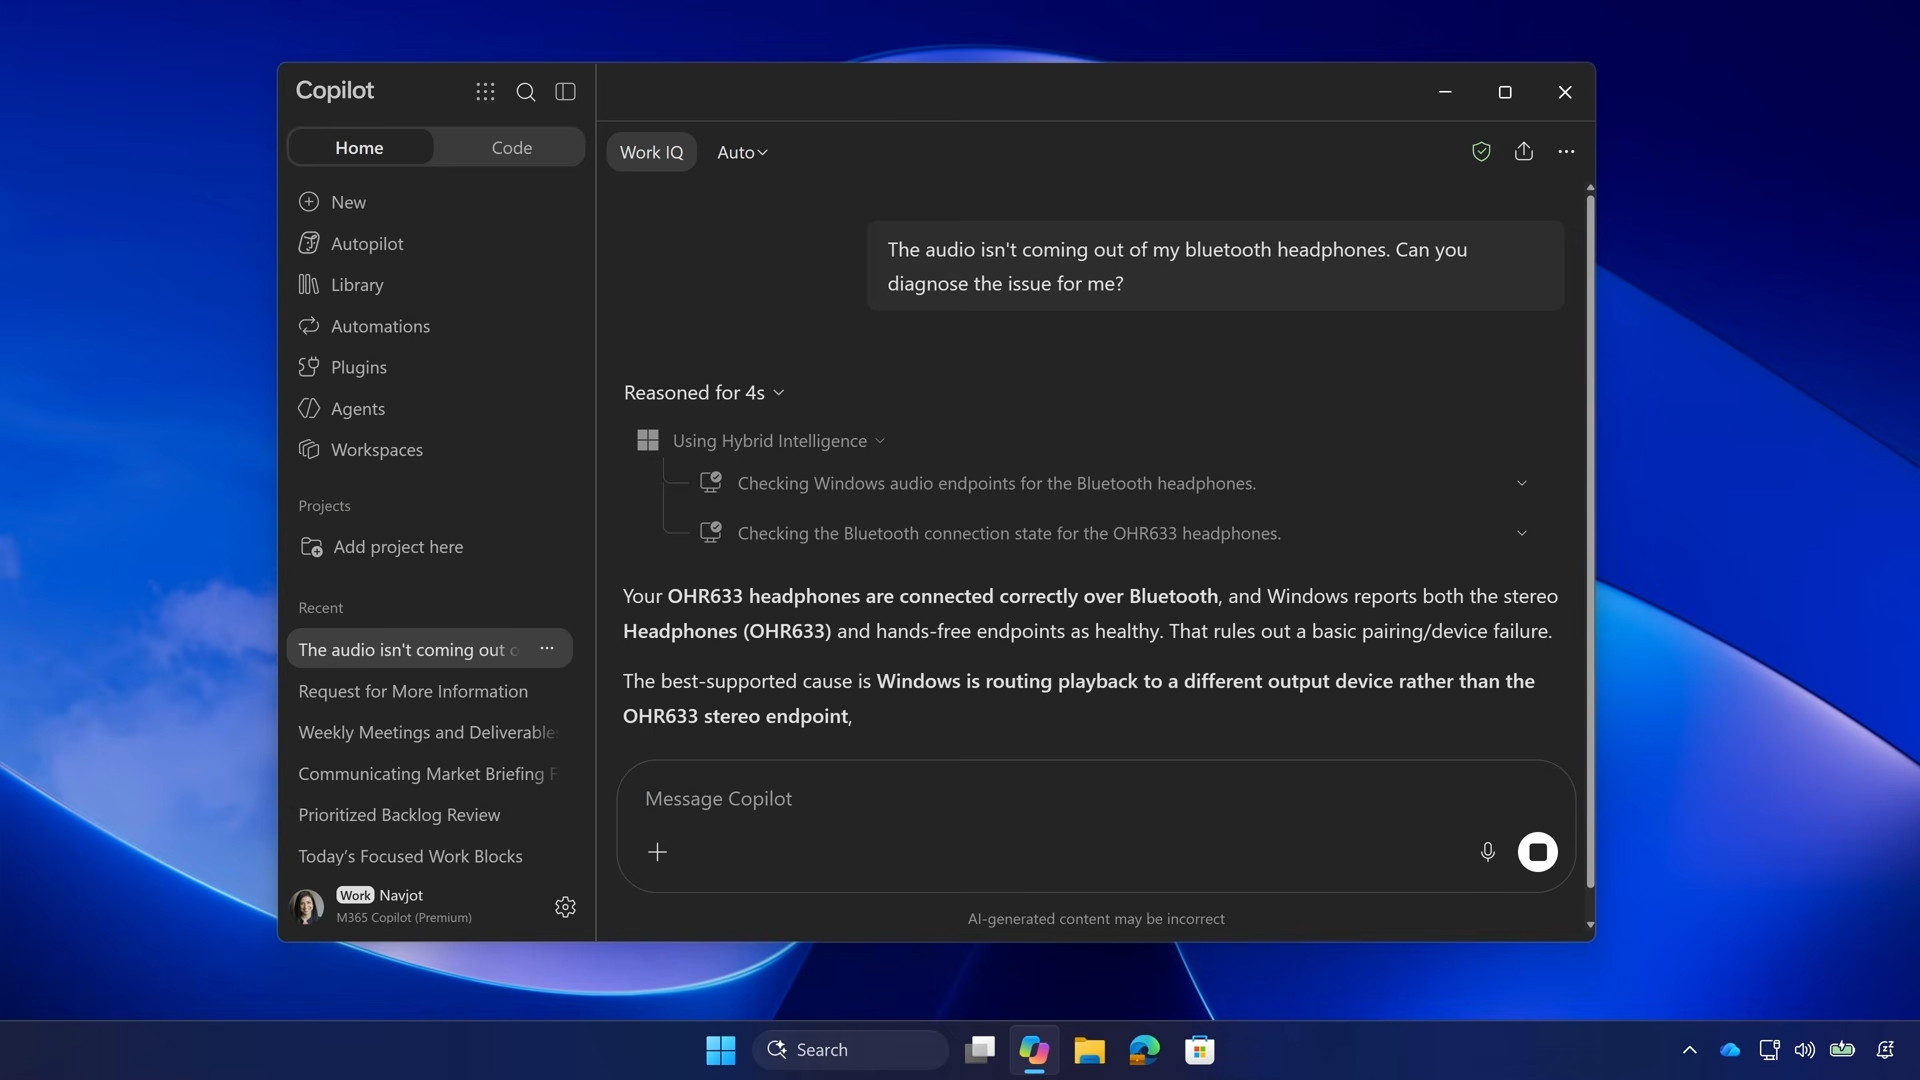
ゲームクライアントエンジニアがClaude Code(Maxプラン)を使い、書かれた実装計画からAIが下書き・レビュー・実装・テストを担い、本人は計画の承認とコードレビューだけを行うと説明
llama.cppがバージョン1.0となり、--moe-cache-cpu-shareを導入
GIXの釣谷氏は、sudoなどのコマンドを許可ルールで制限し自動承認設定を避けてClaude Codeをローカルで実行していたが、社内のApple containデモを機にコンテナ隔離を再検討した