何が起きたか
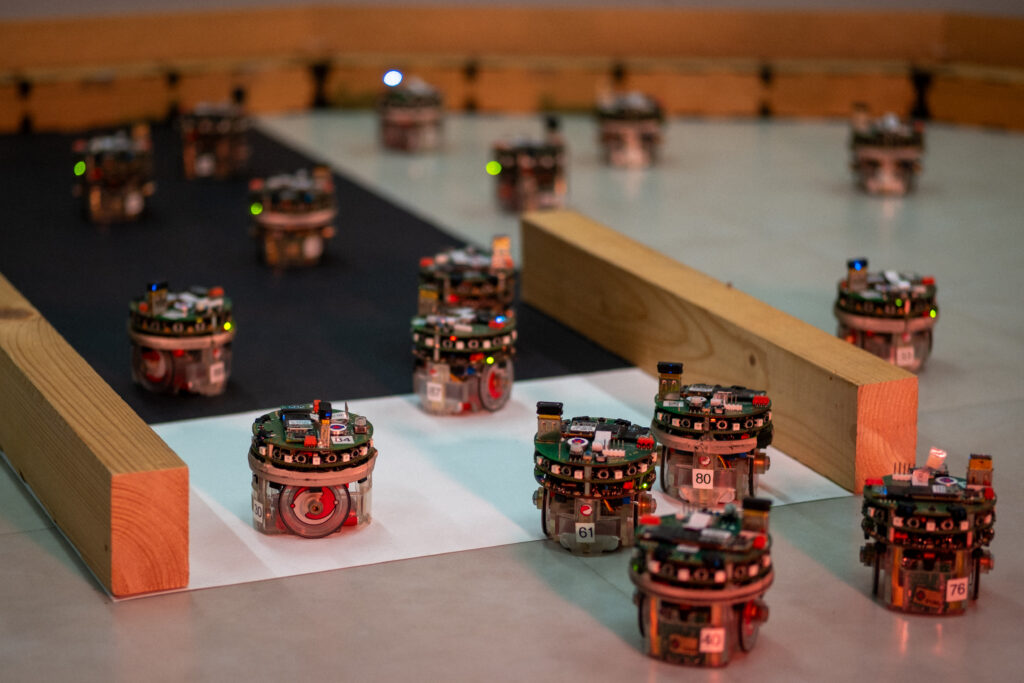
IRIDIAの研究者が20台のe-puckロボットの群れを5つの集団ミッションで訓練し、実機で250回実験。最先端の直接モーター制御手法を大幅に上回った。
なぜ重要か
学習を少数の実証済み行動の選択に絞る手法で、実機で強化学習ポリシーを壊しがちな現実ギャップを減らすとみられる。より単純で制約の強いポリシーの方が、大きく柔軟なものより転送性能が高かった。
誰に効くか群ロボティクスやマルチロボットシステムに取り組むロボティクス技術者や研究者、特に捜索救助、環境モニタリング、危険地帯ミッションを計画する人々は、シミュレーション訓練から現場展開へのより信頼性の高い道筋を得られる可能性がある。
こういう要約が、毎朝あなたのメールに届きます。
群ロボティクスは伝統的に、定義済みの構成要素から行動を組み立てるモジュール設計手法に依存してきた。これらの手法は実機への転送信頼性が高いが、遅くコストのかかる探索手順を必要とする。一方、強化学習は脚式移動やロボットマニピュレーションで目覚ましい進歩を遂げたものの、現実ギャップへの敏感さから群れへの利用は限られてきた。この2つの研究潮流が堅固な実験基盤で比較されることはほとんどなかった。
IRIDIAチームのアプローチはその中間に位置する。アルゴリズムが学習できる範囲を、少数の実証済み行動間の切り替えタイミングに限定することで、学習問題を低レベル制御ではなく協調に集中させる。研究を率いたMauro Birattariは、現実ギャップを過学習の問題と表現する。柔軟すぎる設計手法はタスクではなくシミュレーターを学習してしまう。単純で制約の強いポリシーの方が、大きく柔軟なものより転送性能が高いという発見は、モデルは大きいほど一般的に優れるという人工知能分野の広範な直感に反する。
筆頭著者のIlyes Gharbiは、この成果により強化学習が群ロボティクスの実用的ツールになると述べる。新しいミッションのためにシミュレーションで群れを訓練し、自信を持って実機に展開できる。研究は20台のe-puckロボット、5つの集団ミッション、250回の物理実験でのテストを報告している。チームは次のステップとして、より大規模な群れ、他のロボットプラットフォーム、制御の緩い環境でのテストを挙げており、これにより手法が実験室の枠をどこまで超えられるかが示される。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Microsoft Ignite後の円卓会議でSatya Nadella CEOは政治経済について「AGIに開眼した」と述べ、単一のAIモデルが支配的になれば民主主義が終わり得ると警告した
VisaのMichael Jabbara氏がFox BusinessでAIによる決済脅威の急増を警告した
日立製作所は「Public Biometric Infrastructure」を基盤とする「Proof of Human Delegation」を開発した
パナソニックHDが指先の触覚に反応するロボット操作AI「T-Rex」を開発し、両手作業で平均成功率65%を達成した
環境省は廃棄物選別にフィジカルAIを導入する官民コンソーシアムを設立する
首相官邸の「フィジカルAI関連企業との意見交換会」で、ugoがセミヒューマノイド「ugo Nova」を高市総理に実演した