何が起きたか
2025年8月18日にApache-2.0で公開されたQwen-Image-Editは、20B MMDiTバックボーンを持つ20.43Bパラメータのモデルである。
なぜ重要か
編集をQwen2.5-VLによる意味制御とVAEによる外観アンカーに分離する設計が、マスク外の小さな文字が崩れやすい粗いインペインティングより局所修正の破綻が少ない理由として示されている。
こういう要約が、毎朝あなたのメールに届きます。
問題はプロンプトではなく構造にある。従来のテキスト駆動の再生成や粗いインペインティングは、入力画像をノイズ空間の深部まで押し込んでから再びデノイズするため、マスク端が不自然になり、マスク外の小さな文字が潰れやすい。ポスターやパッケージ、メニューでプロンプトを試し直すチームが、安定性を得られないまま生成回数だけを膨らませてしまうのは、この失敗パターンが原因だ。
Qwen-Image-Editが採る解決策は、同じ入力画像を2つの経路に流すことにある。Qwen2.5-VLが指示と画像をまとめて解釈し、何を変え何を変えないかを決める。一方でVAEエンコーダが色、質感、照明、テキストレイアウトをアンカーとして保持する。この分離を経て初めて、20B MMDiTが統合された信号を受け取る。
限界もある。入力画像を必要とする編集モデルであり、ベース画像をゼロから生成する用途はZ-Image TurboやGPT-Image級のモデルに任せるべきだ。2511でドリフト耐性が向上しても、元画像と1つの指示による1回のパスを推奨し、4〜5回の上書き積み重ねは避けるよう求めている。推奨出力解像度は示されておらず、呼び出し側が自分でサイズを設計する前提だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
ブラックバーンにあるマクドナルドのAI制作壁画が、地元の名所とつづりを間違えた
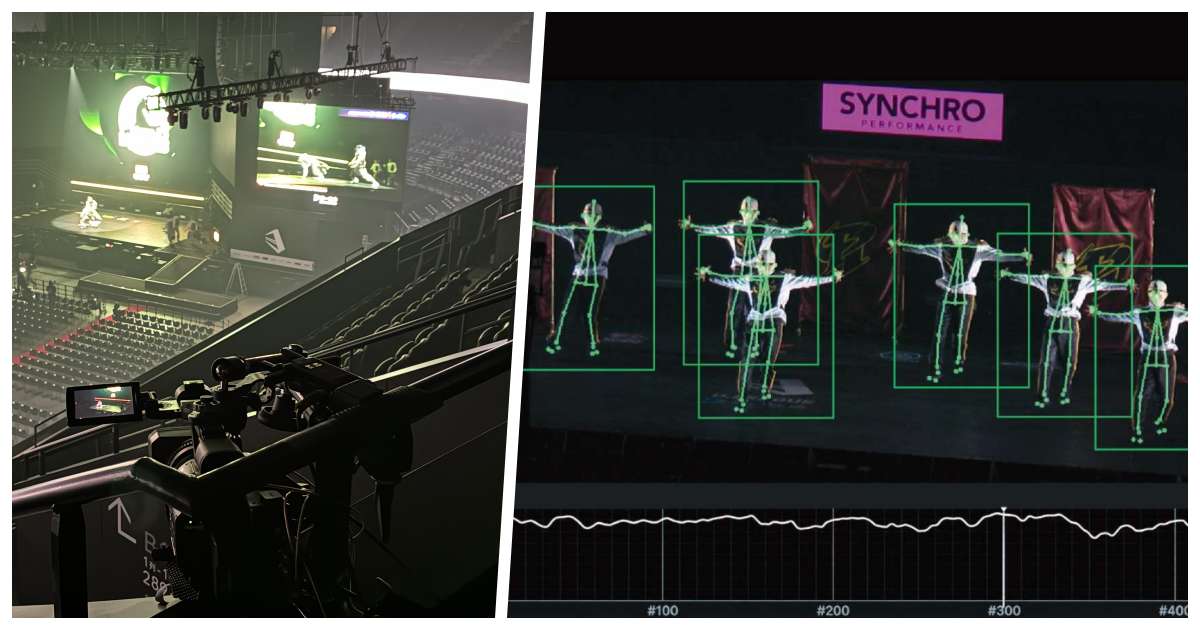
ソニーは複数カメラとAI画像解析を組み合わせ、8人のダンサーの動きの同期を数値化する映像解析システムを開発
Zennのガイドが、CLIP系モデルで画像とテキストを同じベクトル空間に写し、自然言語で個人の写真・動画ライブラリを検索する実装方針を公開
Innovation BASE 北海道が2026年11月4日発表で、AI:Promoの画像編集にOpenAIのGPT-Image-2.6 Sunburstを採用し、範囲を囲む・四角で囲む・印を付けるマークアップ編集を追加…
GenBunnyに関係する筆者が、参照画像のSHA-256ハッシュとクレジット換算(6クレジット=0.15ドル)をローカルPythonで記録する手順を公開した
WebRTCの参照構成の技術解説