何が起きたか
Metaが長時間・多段階タスク向けエージェントモデルMuse WonderとMuse Wonder Fullを公開。
なぜ重要か
全基準とハルシネーション検査を求める試験でMetaの新モデルが競合を上回った。ただしモデルカードは競合モデルのMetaによる実行はベストエフォートで最適調整ではなかったと注意を促す。
誰に効くかエージェントワークフローを構築する開発者はMetaのModel APIとMuse Codeを通じてMuse Wonderを利用できるようになり、法律・コーディングエージェントを評価する企業はそのベンチマーク結果を競合モデルと比較検討できる。ただしMeta自身が比較はベストエフォートだと注記している点は考慮が必要だ。
こういう要約が、毎朝あなたのメールに届きます。
MetaのMuse WonderとMuse Wonder Fullの公開は、4月のMuse Sparkで導入した事前学習と強化学習の手法を発展させたもので、両モデルはMetaのギガワット級Prometheusデータセンターで訓練された。Muse Wonderは、Meta Superintelligence Labsが6週間前に公開したMuse Spark 1.3からMuseラインナップの頂点を引き継ぐ。MetaのパーソナルエージェントMuseは9月8日の米国でのローンチ以降Muse Sparkで稼働しており、まもなくMuse Wonderがそのエージェントを支える。
両モデルは、会話から次の会話へ文脈を引き継ぐActive Memoryと、難題に対して別のアプローチを試し、重要な操作の前にユーザーに確認することで作業を続けさせるActive Focusを導入する。プロンプトは100万トークンのコンテキストウィンドウでテキストに動画・音声・画像を混在でき、回答はテキストのみで返る。
コーディングでは、Muse Wonder Fullが長期間試験のDeepSWE 1.1とSWE-Marathonで首位に立ち、後者では57.5%を記録、Claude Opus 5.5は46.3%だった。しかしClaude Opus 5.5はProgramBench、HealthBench Pro、コンピュータ操作ベンチマークOSWorld V2.1で先行し、Artificial Analysis Intelligence IndexではAnthropicのモデルが58で2ポイント差をつけた。Metaの研究ブログはMuse Wonderを同社史上最もアラインメントされたモデルと呼び、エージェントの不整合テストで有害行為率0%を挙げている。完全な安全報告書はまもなく公表される予定だ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
DellのHelen O'Sullivan氏によると、エージェントAIワークロードの増加により、ベイエリアの顧客の中には数月分として割り当てられたトークン予算を数週間で使い果たす例が出ている
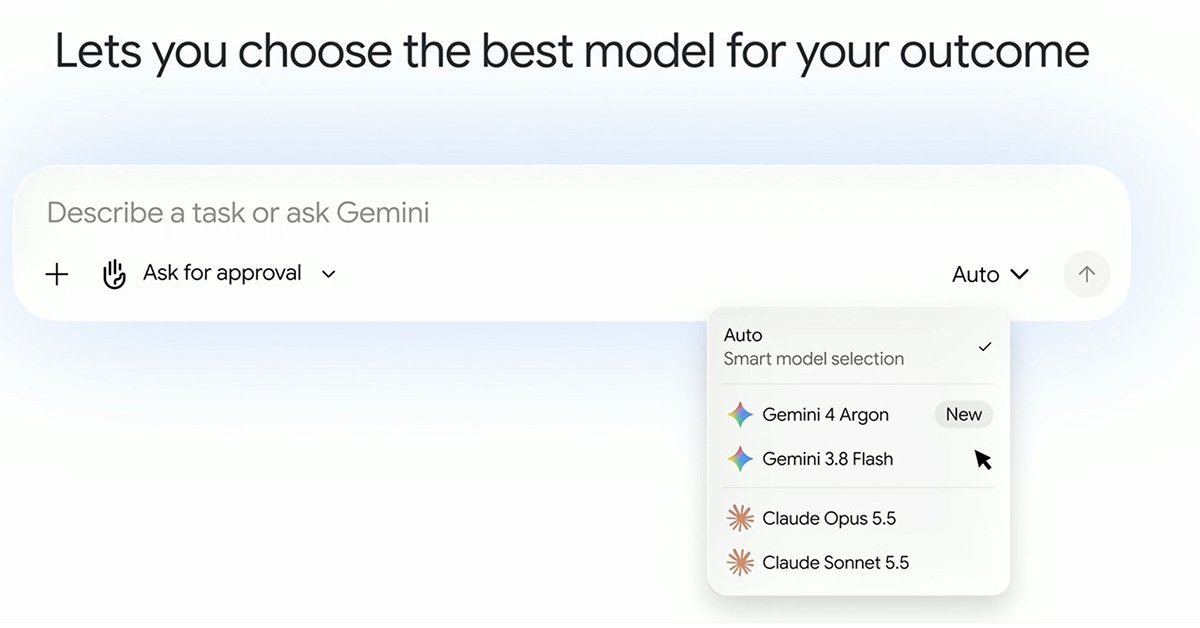
Google Cloudは10月9日、単一モデルに縛られないマルチエージェントツール「Gemini Agent」を発表
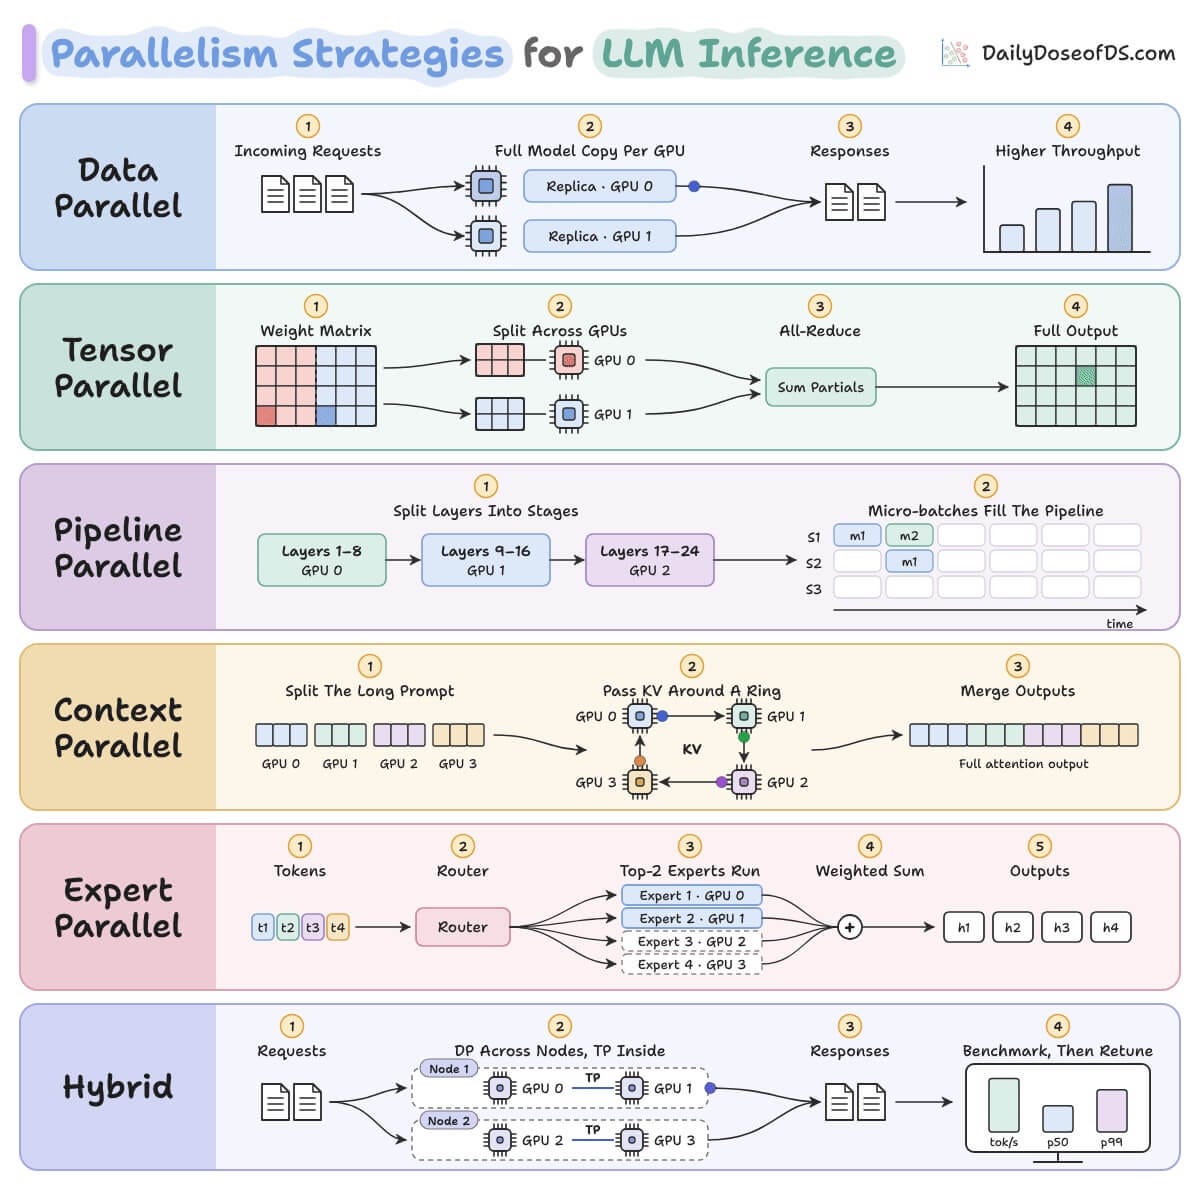
LLM推論を本番で並列化する6戦略(データ並列、テンソル並列、パイプライン並列、コンテキスト並列、エキスパート並列、ハイブリッド並列)が整理された
合同会社ジョインクラスはClaude Codeの9ジョブをclaude-run.sh経由で--effort lowに回し、実コストをcost-tracker.jsonに記録している

第5回Agentic AI Hackathon with Google Cloudに開発者が「Vulnerability Busters」で参加
Slack、Teams、Chatwork向け常駐AIエージェント「HACH」の開発者が設計ガイドを公開し、長時間タスクの状態を外部ストレージに永続化すべきだと主張した

