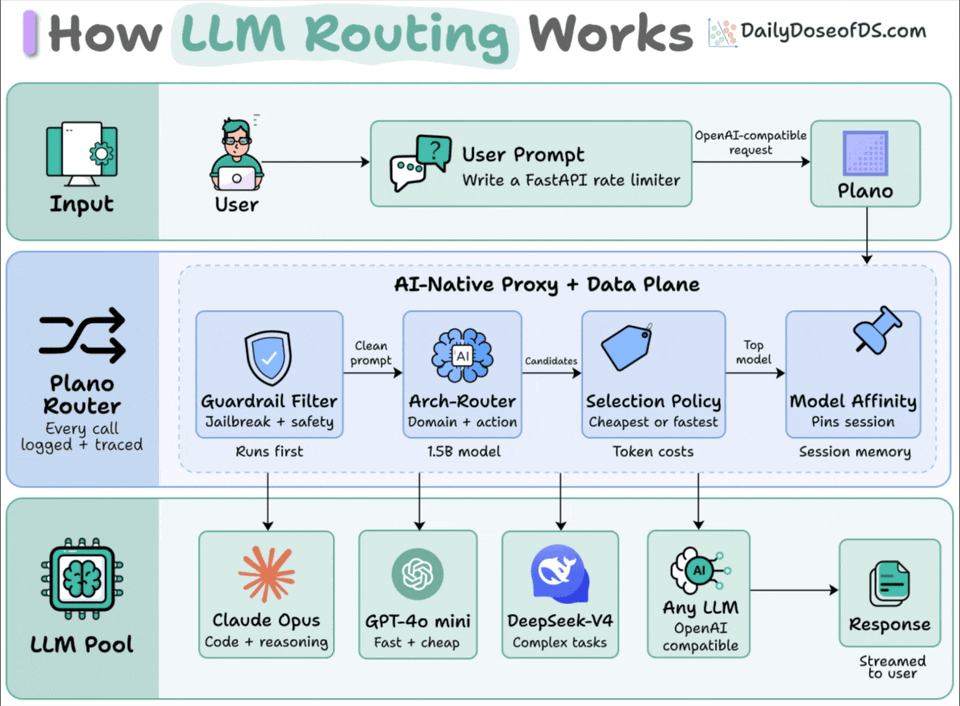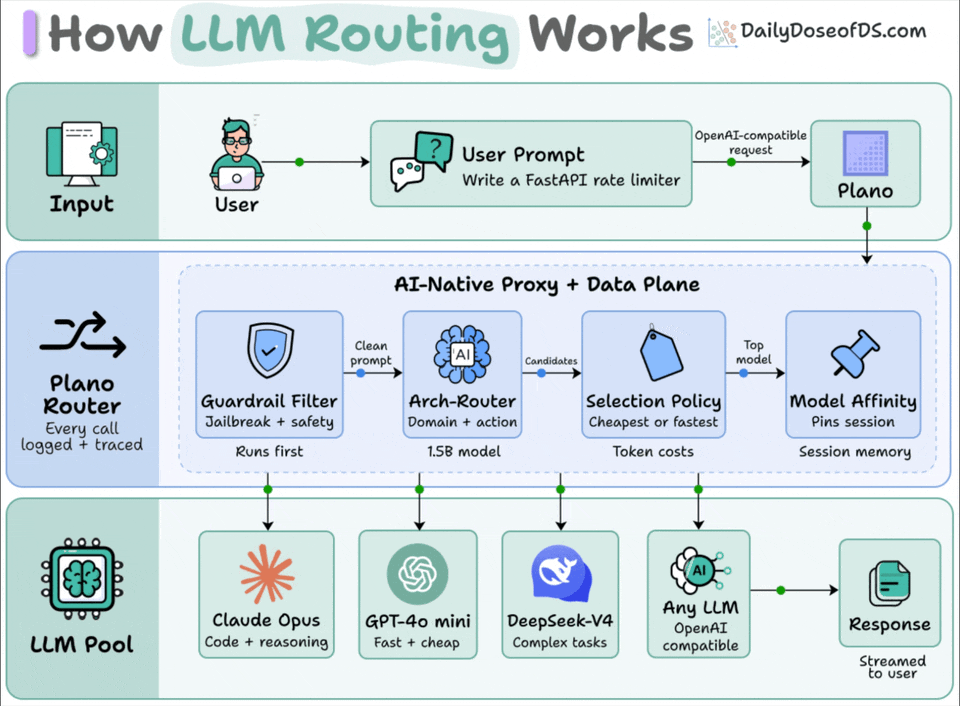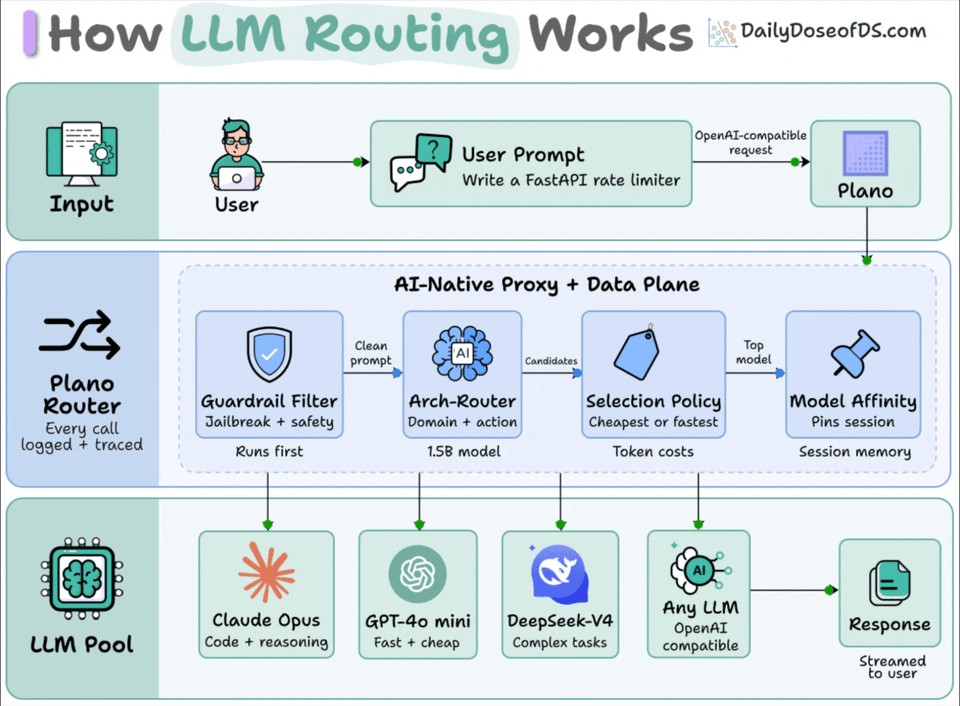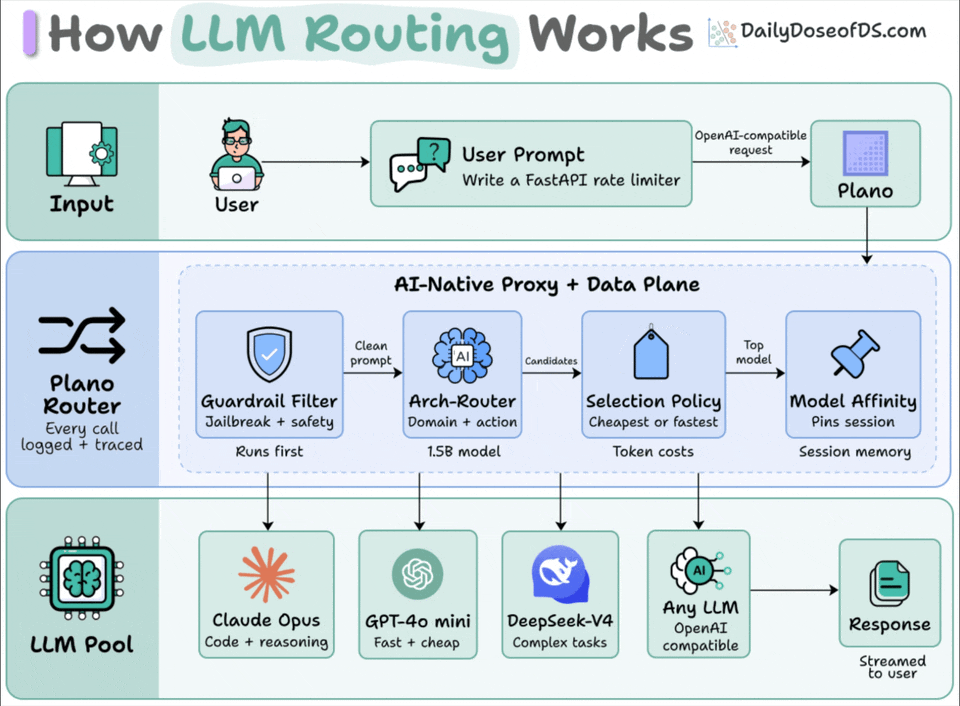
何が起きたか
エージェント(自分で判断して作業するAI)で安価なLLM(文章を理解・生成するAI)へのルーティングを導入しても、コスト削減が実現しないケースが起きていることが明かされました。原因は、LLMが前回の処理結果をキャッシュして再利用する仕組み(プロンプトキャッシング)で、モデルを切り替える度にこのキャッシュが失われ、文脈全体を高額な新規入力として請求されるためです。
なぜ重要か
本番環境のルーティングシステムでは単なるタスク難易度による振り分けでは不十分で、タスク内で同じモデルに固定する「モデルアフィニティ」を実装する必要があることが示されました。この4段階のルーティングパイプライン(安全フィルタ・ルーティングモデル・選択ポリシー・モデルアフィニティ)を組むことで、初めてコスト削減が実現する可能性があり、実装例では使用量が2倍削減されたと報告されています。
注目点
Planoというオープンソースプロキシがこのパイプラインを実装しており、GitHub上で入手できます。ルーティングモデルにはArch-Router(1.5Bモデル)が使用され、設定はYAML形式で管理されるため、エージェントコード自体に変更を加えることなく柔軟に調整が可能です。
こういう要約が、毎朝あなたのメールに届きます。
エージェント型AIシステムでLLMの利用コストを削減する場合、単純にタスク難易度に応じて安価なモデルに振り分けるだけでは不十分であることが明らかにされました。その理由は、現代のLLMが提供する「プロンプトキャッシング」という最適化機能にあります。この機能により、すでに処理した文脈は約90%割安で再利用できるものの、キャッシュはモデル固有であり、モデルの切り替えがあるたびにそれまでの最適化が失われるため、費用削減の効果が帳消しになってしまうのです。
本番環境での実装は、この問題を回避するために「モデルアフィニティ」という層を導入しています。これは、タスクの開始時にどのモデルを使用するかを決定し、その後のタスク内部のすべての処理呼び出しについては同じモデルに固定する方式です。この仕組みにより、キャッシュが温かい状態(「ウォーム」)を保ったまま処理が進み、かつ新しいタスクが始まると再び自由にルーティング判定が行われるため、全体として安価なモデルへの振り分けメリットとキャッシュ効率化のメリットの両立が実現します。Planoなどのオープンソースツールでこのパイプラインが提供されており、実装例では使用量が2倍削減される効果が報告されているため、実務レベルでも検証可能な知見となっています。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
ElevenLabsが220億ドルの評価額で3億ドルの従業員向けテンダーを完了し、Mati Staniszewski氏は音声が主要なインターフェースになると予測した

OpenAIは10月15日、Rosalind Academic Planを発表した

Qiita記事がLLMアプリ向け自動レッドチーミング手法GCG・PAIR・TAPを実LLMなしの模擬実装で比較した

Liquid AIは2026年10月15日、オープンウェイトの改良版意思決定モデルd1-ultraを公開した

CircliaがTASTE SIGNALの実証実験を開始した

フランス数学会会長イザベル・ガラガー主催のウェビナーで、フィールズ賞受賞者のユーゴ・デュミニル=コパンは、OpenAIが350の主要未解決問題の解答を一夜で公開したと述べた

