何が起きたか
OpenAIのGPT-6 Astraがulam.aiのErdosBenchでスコア3.23を記録し首位に。数学問題226問中106問を解き、27問を反証した。
なぜ重要か
ベンチマーク開発者のPrzemek Chojecki氏は「テストされた各種数学研究スキルで確実に5〜10%の向上」と評した。Astraの勝利は数学に特化した最適化なしで達成された。
注目点
論文発表後、OpenAIはより優れた内部数学モデルを訓練したとされ、RSIとAI安全性の話題が急増。Fable 5.1のスコア3.25が維持されるか注目。Astraは依然として最多の問題を解いている。
誰に効くかモデル能力を追うAI研究チームと数学者は、ベンチマークの勝利をより慎重に読む必要がある——最高スコアは狙った取り組みではなく、他の優先事項の副産物を示すかもしれない。数学研究者は、モデルが人間の検証速度を超えて証明を生み続けた場合、誰が証明を検証するのかという実務的な問いに直面する。
こういう要約が、毎朝あなたのメールに届きます。
OpenAIは最初の発表で数学の成果を前面に押し出していただけに、「An Alien Mind」でのPachocki氏の告白は注目に値する。追加の注力で数学研究能力を高められるとしながらも、再帰的自己改善と自動アラインメント研究の緊急性を理由に、あえてそうしないというのだ。このトレードオフこそ、記事が唱えるAI開発の「とがった」論——全タスクにわたる広範で漸進的な改善ではなく、特定領域での極端な強さ——の中心的な証拠である。
ケンブリッジ大学の研究者Adam Hunt氏の可視化は、広範で漸進的な改善という「主流AGI」の道と、コーディングと数学が急伸する一方で言語品質や常識、社会的推論が停滞・後退するとがった軌道を対比する。記事はPachocki氏の発言を後者の証拠として提示し、最先端のAIラボでさえ全ての方向に同時に最大の進歩を押し進めることはできないと指摘する。しかしRSI優先の背後には、いずれモデル自身がそれらの最適化を担い、数学を含む全領域でより速くスケールするという期待がある。
Astraが前身より5%優れているか50%優れているかにかかわらず、数学にとってより深い問いは残る。2026年国際数学者会議でTerence Tao氏が提起したように、AIモデルが人間の検証速度を超えて証明を生み続ければ、この分野は証明の希少から証明の過多へと移行する恐れがあり、どの結果が本当に重要かを見極めることが最重要課題となる。最難問は今なお未解決で、それが分野に猶予を与えているかもしれないが、方向性は定まったように見える——人間のような創造性なしに言語モデルが真の突破を生み出せるか疑問視する数学者がいるとしても。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
サカナクション山口一郎が10月27日のYouTube生配信で、パスタに混ざったカメムシの句をChatGPTに頼むと、「うんうん、聞いてるよ」と相づちだけを返し、「こんな壊れ方するの?
IteraのLLMOチェキが「AI質問の提案」を開始

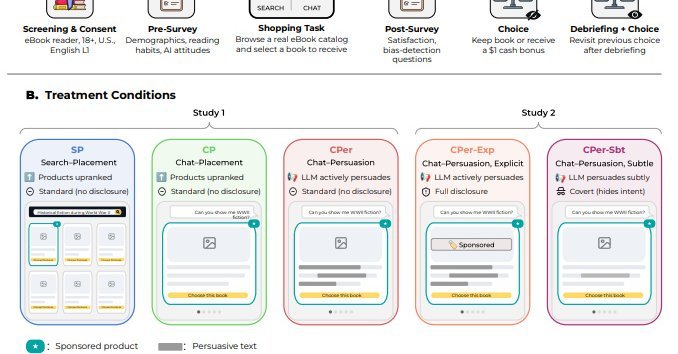
プリンストン大学の研究で、参加者2,012人と約5,500冊を使い、広告商品の選択率は検索結果経由22.4%、中立のチャット配置26.8%、AIに秘密裏に説得を指示すると61.2%だった
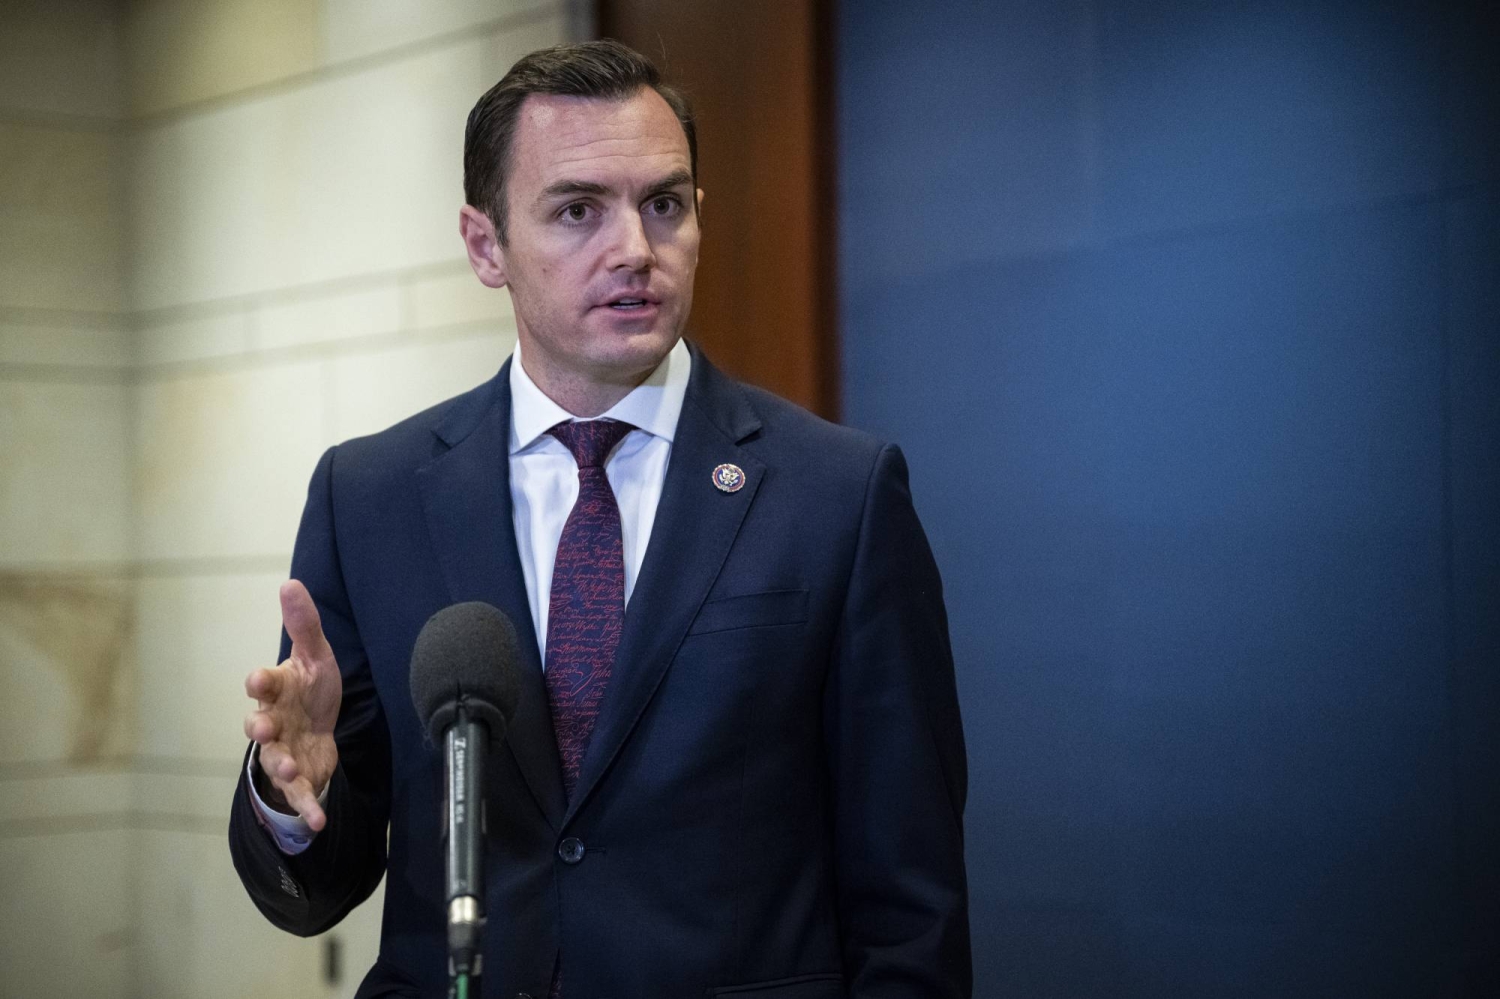
Palantirの防衛部門責任者Mike Gallagher氏は水曜日、AI開発における台湾の役割が増大し、習近平国家主席が北京の台湾構想を実行に移す必要が生じかねないと述べた
Project Tadoriの「ワイカメ」が10月29日、無料の対話型トップページを公開
NTT TechnoCrossは12月からForeSight Voice MiningにAIナビゲーションを追加