何が起きたか
SnowflakeとGoogle Cloudが、BigQuery、Apache Spark、Trino、Snowflake自体を含む複数の分析エンジンが、データをシステム間でコピーすることなく同じデータへ直接読み取り・書き込みできるよう、データプラットフォームを統合している。この統合は共有オープン形式としてApache Icebergを使用し、統一ガバナンスを強制するカタログフェデレーション(Snowflake Horizon CatalogとGoogle CloudのLakehouse runtime catalog)に依存している。
なぜ重要か
組織は多くの場合、同じデータパイプライン内で複数の専門ツールを使用しており、データをシステム間で複製する必要がある場合に冗長性と矛盾が生じる。この統一アプローチにより、チームは各ジョブに最適なエンジン(より高速な分析、より安いストレージ、より強力なセキュリティ)を選択でき、単一のガバナンスレイヤーがどのカタログがデータを管理しているかに関わらず、すべてのエンジン全体でアクセスポリシーと監査証跡を強制する。
注目点
統合はデータアクセスを超えてAIエージェントにまで拡張している。Snowflakeはプログラマティックエージェントアクセスのためのモデルコンテキストプロトコル(MCP)サーバーを公開し、両プラットフォームはセマンティックモデルとコンテキストメタデータ(データ品質シグナル、ビジネス定義、使用パターン)を提供し、AIハルシネーションを低減し、答えを検証済みビジネスロジックと信頼できるデータソースに基づけている。
こういう要約が、毎朝あなたのメールに届きます。
このパートナーシップは、モダンデータエンジニアリングの基本的な課題に対応している。組織は専門ツール使用の柔軟性を必要としているが、複数のエンジンでデータを複製すると冗長性、矛盾、ガバナンスリスクが生じる。Apache Icebergに収束し(Netflixで元々開発されたペタバイト規模のオープンテーブル形式)、フェデレーテッドカタログを実装することで、SnowflakeとGoogle Cloudはゼロコピーアーキテクチャを実現している。このアーキテクチャではエンジンはデータをネットワーク経由で移動させるのではなくデータの場所にコンピュートを持ってくる。Iceberg REST Catalog(IRC)標準は異なるベンダーのツールがカスタム統合なしで相互運用できることを保証し、vended credentialsは異なるカタログのエンジンが同じテーブルを読み取り・書き込みする場合でも細粒度のアクセス制御を強制している。このアーキテクチャシフトはガバナンスをエンジン層からカタログ層に移動させ、ポリシー強制を一元化しながらツール選択のチームの自律性を保持している。
統合はデータアクセスを超えてさらに深く進む。AIエージェント(Gemini Enterprise、コードアシスタント、カスタムフレームワークなど)は伝統的に各データソースとの個別統合が必要で、セマンティック基盤がないとハルシネーションするリスクがあった。このパートナーシップはモデルコンテキストプロトコル(MCP)をユニバーサルインターフェースとして導入し、MCP互換のすべてのエージェントがカスタムプランニングなしにレイクハウス資産を発見し推論できる。さらに重要なことに、セマンティックモデル(Horizon ContextおよびGoogle CloudのUniversal Semantic Layer経由)はビジネスロジックをデータレイヤー自体に埋め込む。計算ルール付きのメトリクス、階層構造を持つディメンション、検証済みクエリパターンにより、すべてのAIシステム、エージェント、アナリストが同じ正確な解釈を継承する。コンテキストメタデータ(データ品質シグナル、ビジネス定義、使用パターン、ドメイン関係)はAI応答をさらに信頼できるデータに基づけ、汎用推論(「収益はおそらく...」)から根拠のある事実(「Q4の収益は信頼できるfinance.revenueテーブルから4720万ドル」)へと答えを移す。複雑なマルチエンジンデータパイプラインを管理する企業にとって、このアプローチはドリフトと矛盾を低減し、カタログとガバナンス責任をマネージドサービスにシフトすることで運用オーバーヘッドを低下させている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
FlashLabsがOrcaRouterゲートウェイのTrace Exportを強化し、SDKやコード変更なしでAIリクエストのトレースをGrafana、Datadog、Langfuse、LangSmithへリアルタイム…

KivaのSamurai Appに、ヤマト運輸「ビジネスメンバーズ」の顧客コードへログインし運賃と請求金額を取得、複数コード・複数月の運賃CSVを一括ダウンロードできるAPI連携を追加
kickflowはシリーズAで約10.6億円を調達
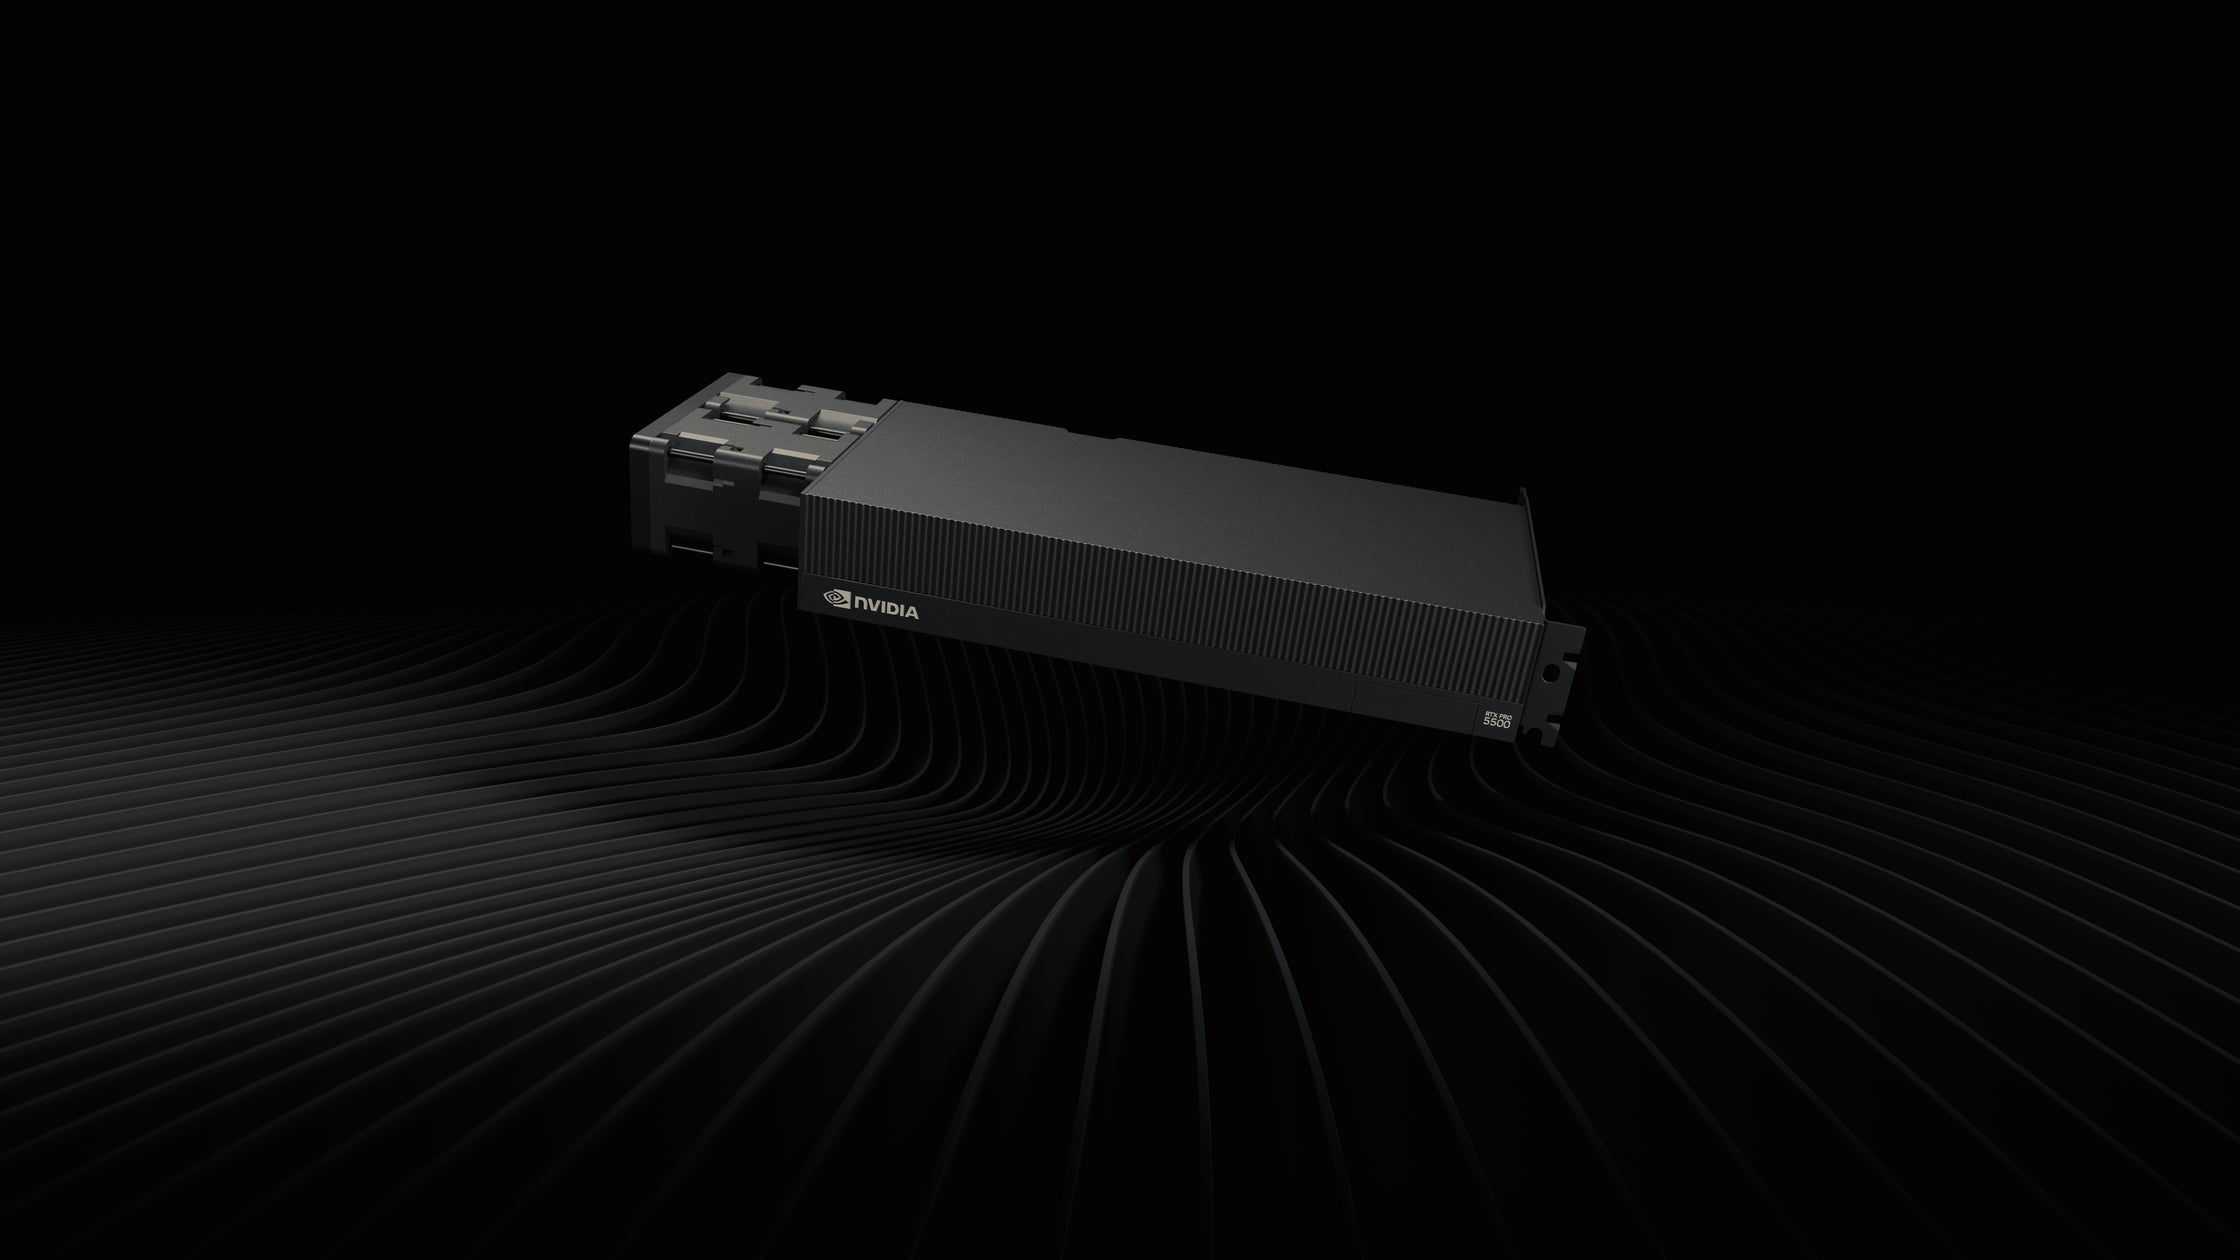
リョーサン菱洋が84 GBのGDDR7メモリを搭載し大規模AIモデルをローカル実行できるNVIDIA RTX PRO 5500 Blackwell Workstation Editionの取り扱いを開始した
JAPAN AIが「JAPAN AI HR」で「AI面接」の提供を開始
Anthropicは11月19日に上場する見通しで、筆者は2026年上半期の売上高が前年同期比1,305%増の163億ドルだったことを挙げ、SpaceXより好意的に見ている