何が起きたか
Artificial Analysisが Search Indexベンチマークをリリース。Parallel、Exa、Firecrawl、You.com、Tavily、Keenable、Braveの7つの検索APIプロバイダーを、同一のAIモデル(GPT-5.6 Luna)で同じエージェント環境下でテスト。ベンチマークは3つの均等配分されたテストスイート—DeepSearchQA(900件の研究質問)、BrowseComp(200件の難しい事実発見タスク)、AA-Omniscience(6領域600問)—で構成される。
なぜ重要か
検索品質はAIエージェントの性能とコスト両方に直結する。検索なしではモデルは33点だが、検索ありでは65〜75点に跳ね上がる。良好な検索品質はトークン総使用量を削減する。Parallelの上位版は基本版比で40%以上のトークン消費削減を達成し、1検索あたりの手数料が高いにもかかわらず、タスク全体のコストは0.11ドルから0.084ドルに低下。企業は適切な検索プロバイダーを選択することで精度と支出の両方を最適化できる。
注目点
Parallel、Firecrawl、Parallel(ターボ版)が最良のコスト・パフォーマンス混合を達成したが、クエリあたりの生速度がタスク全体時間の短縮につながるとは限らない。Parallelのターボ版はクエリあたり最速(0.51秒 対 基本版1.03秒)だが品質が低く(67 対 73)、エージェントがより多くのパスを実行する必要があり、全体時間は変わらない。方法論は公開されており、他のプロバイダーは参加申請が可能。
こういう要約が、毎朝あなたのメールに届きます。
Artificial AnalysisがSearch Indexを構築した理由は実務的なギャップを埋めるため。AIエージェント向け検索APIを、品質・コスト・速度すべてが重要なとき、どう比較するのか。モデル(GPT-5.6 Luna)、フレームワーク(Stirrup)、テストシナリオ(スイートあたり900〜600問)を標準化することで、ベンチマークは検索プロバイダーを唯一の変数として分離。この厳密なアプローチから一見矛盾する知見が生まれた。クエリあたりの最速検索がタスク全体の最速完了を保証しないのだ。Parallelのターボ版は最短応答時間(0.51秒)を実現するが、品質が低いため、エージェントが追加パスを実行する必要があり、速度優位を相殺する。一方、Parallelの上位版とExaは生速度より品質を優先し、必要なクエリ数を削減しトークン消費を抑制。1検索あたりの手数料が高くても、全体コストの削減につながる。ベンチマークが示すのは、AIエージェントにとって品質は経済的テコ。少数の高精度クエリは、多数の低品質な安価クエリより全体コストが安い。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NEURA RoboticsがNeuron AIを発表
GoogleはGemini 4 Argonをコーディング、ナレッジワーク、企業ワークフロー、サイバー防衛向けに世界展開
GoogleはGemini 4 Argonの提供を開始した
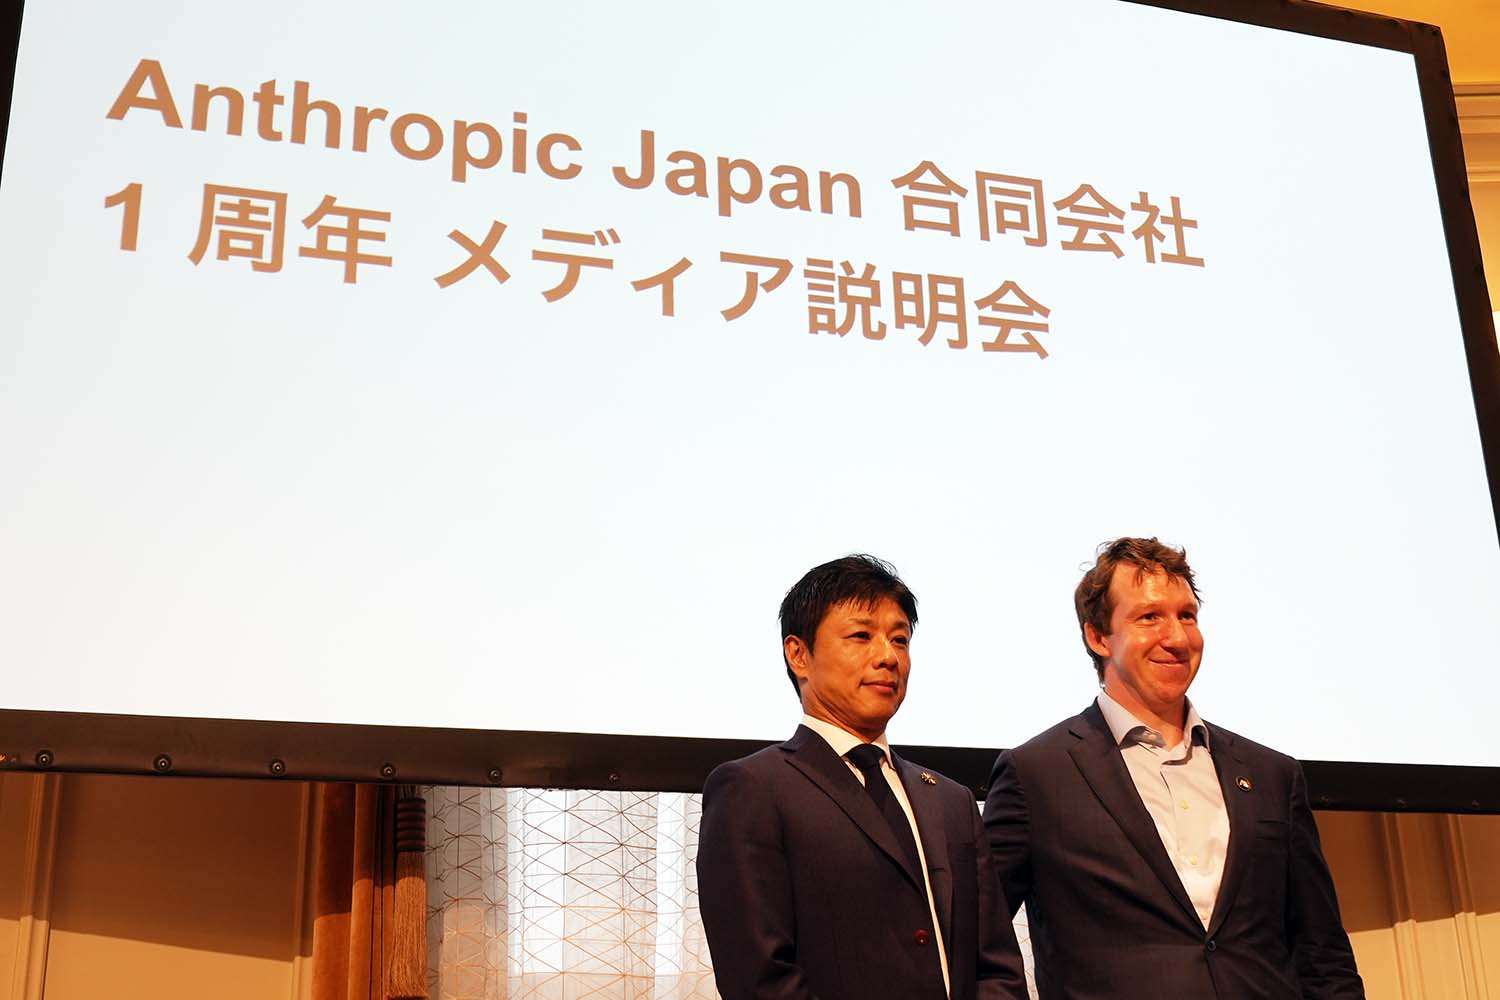
Anthropicは日本法人の従業員が1年で3人から50人超に増え、顧客導入は10倍、日本でのClaude利用は他国の平均の1.9倍と発表した
2026年10月12日、Character.aiは破産手続きを開始し、一部資産をWalt Disney関連会社に売却すると発表
SnowflakeはGemini 4 ArgonのパブリックプレビューをSnowflake Cortex AI上で開始した