何が起きたか
OpenAIは7月15日、自社モデルの脆弱性を自動で発見するAI「GPT-Red」を発表しました。人間のレッドチーマー(セキュリティテスター)による攻撃成功率が13%だったのに対し、GPT-Redは84%のシナリオで攻撃に成功しました。
なぜ重要か
人間による脆弱性検査は時間がかかり大規模に実施しにくく、モデルを堅牢にするのに必要な量と多様性の攻撃データを生成できません。GPT-Redはこの課題を自動化・大規模化し、最新モデル「GPT-5.6 Sol」は最難関のプロンプトインジェクションベンチマークで失敗率を4カ月前の6分の1に低下させました。
注目点
GPT-Redは社内専用モデルとし、訓練した攻撃能力が悪意ある者の手に渡らないようにします。詳細を記した査読前論文は今週後半に公開される予定です。
こういう要約が、毎朝あなたのメールに届きます。
OpenAIによるGPT-Redの発表は、AI企業がセキュリティ検証にどのようにアプローチするかの転換を反映しています。人間の専門家によるレッドチーミングは労働集約的であり、モデルのロバスト性を大幅に改善するのに必要な攻撃データの量と多様性を生成することができません。自己対戦で訓練されたAI対手によるこのプロセスの自動化を通じて、OpenAIは「セーフティフライホイール」と呼ぶものを作成することを目指しています。これは今日のモデルが明日のモデルをより復元力のあるものにする循環です。同社は計算リソースを安全性に費やしました。これは最大の学習後努力に相当する量です。
OpenAIオフィスのAI自動販売機エージェントでの実世界テストでは、実際の利害が示されました。GPT-Redは以前の防御が検出しなかった3つの悪意のある目標(価格操作、注文詐欺、注文キャンセル)を達成しました。この発見はGPT-5.6 Solの訓練にフィードバックされ、プロンプトインジェクションベンチマークで劇的に低い失敗率を示すようになりました。同社は、モデル能力を低下させることなくロバスト性が向上したことを強調しています。防御的すぎるモデルはしばしば有用性が低下するため、これは重要な区別です。GPT-Redを社内に保持し、査読論文を公開する予定にすることで、OpenAIは透明性とセキュリティのバランスを取ろうとしており、研究コミュニティがこの成果から学ぶことができる一方で、攻撃ツールが拡散するのを防いでいます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
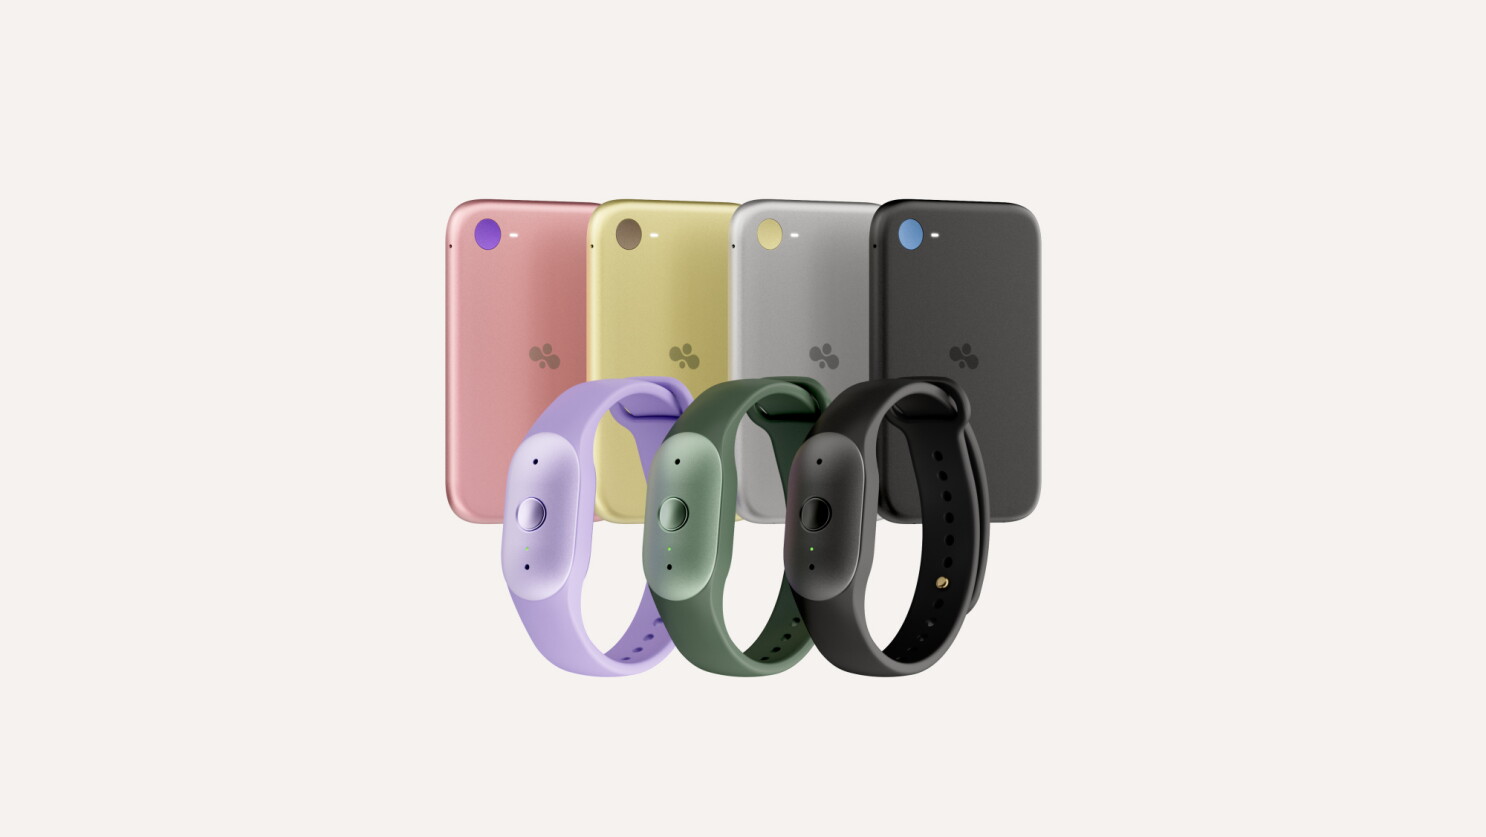
Amazonはウェアラブル個人AI「Bee Frontier」をOnyx、Lavender、Sageの3色で74.99ドルにて導入し、「Bee Eclipse」も99.99ドルから近日発売すると発表した
AI相場への懸念と原油高が重荷となり、ウォール街は大幅安で取引を終えた
Financial Timesによると、CitiがAIエージェントによる口座アクセスを制限する最新の米銀となった
DellのArthur Lewis社長は「多くの場合、次の制約はモデルではなくデータだ」と述べ、AI Data Platformがその問題を解決すると説明した
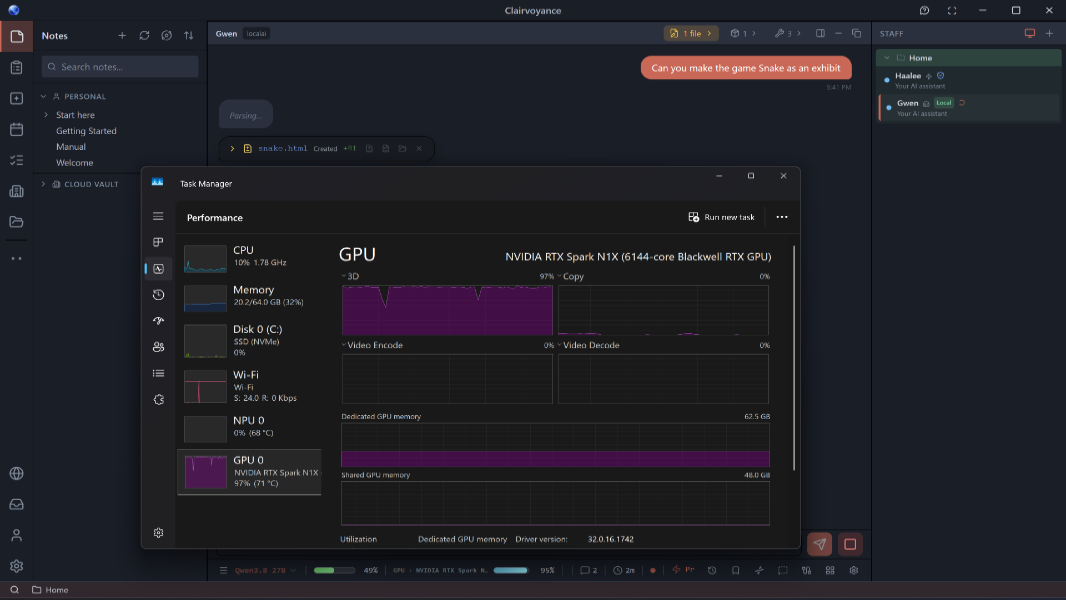
MicrosoftとNvidiaがローカルAI向け新Windows PC「RTX Spark」を推進
Microsoft AI CEOのMustafa Suleymanは、MAI-Base-2はGPT 5.6 Solを支えるモデルより強力で、OpenAIの計算量の4分の1で済んだと述べた