何が起きたか
Llama 3.2 1B Instruct(w4a16、コンテキスト512)をDragonwing RB3 Gen 2上で手組みパイプラインによりコンパイル・リンク・プロファイリングし、プリフィル1,024 tok/s、デコード16.4 tok/sを記録した。
なぜ重要か
異なる2つのモデル系統が新たな驚きなしに通れば再現可能な手法を示唆する。測定はQwen3実行と同じグラフ単位プロファイリングで行われ、2行は比較可能だ。
こういう要約が、毎朝あなたのメールに届きます。
2つの実行が共有するのはチップだけではない。手順は同一だった。失敗したエクスポートジョブからパイプライン自身のコンパイルパラメータを読み取り、問題のフラグ1つを外し、スクリプトが修正し忘れる入力シェイプを固定する。最後のステップは重要だ。著者によれば、最初のQwen3の試みはシェイプを動的のままにしたために失敗した。RB3 Gen 2上で6回のコンパイル、1回のリンク、6回のプロファイリングがすべて通っても、不具合はスクリプト内に残ったままで、回避策がそれを迂回している。
著者が本当に構築しているのは単一の結果ではなくシリーズだ。比較表にはw4a16・コンテキスト512の2行が並ぶ。Qwen3-0.6Bがプリフィル1,555 tok/s、デコード24.6 tok/s、Llama 3.2 1B Instructが1,024と16.4だ。両行を比較可能にしているのは明示された手法であり、著者は手法を伴わない大きな数値よりも、手法とセットで数値を公開したいと述べている。待機列の次の項目、Qwen3-1.7BとLlama 3.2 3Bが加われば、2点比較は傾向へと変わり、このチップで何がどれだけ速く動くかについて外挿から実測の答えへと近づく。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Microsoftは11月17日から20日までサンフランシスコでIgniteを開催し、CEOのSatya Nadella氏が基調講演を行う
11月12日、Googleは日常的なコーディングと多段階のエージェントタスク向けにGemini 4 Hydrogenを発表し、GeminiアプリとGoogle検索での展開を開始した
Sebastian Raschka氏がLLMの位置埋め込みを解説
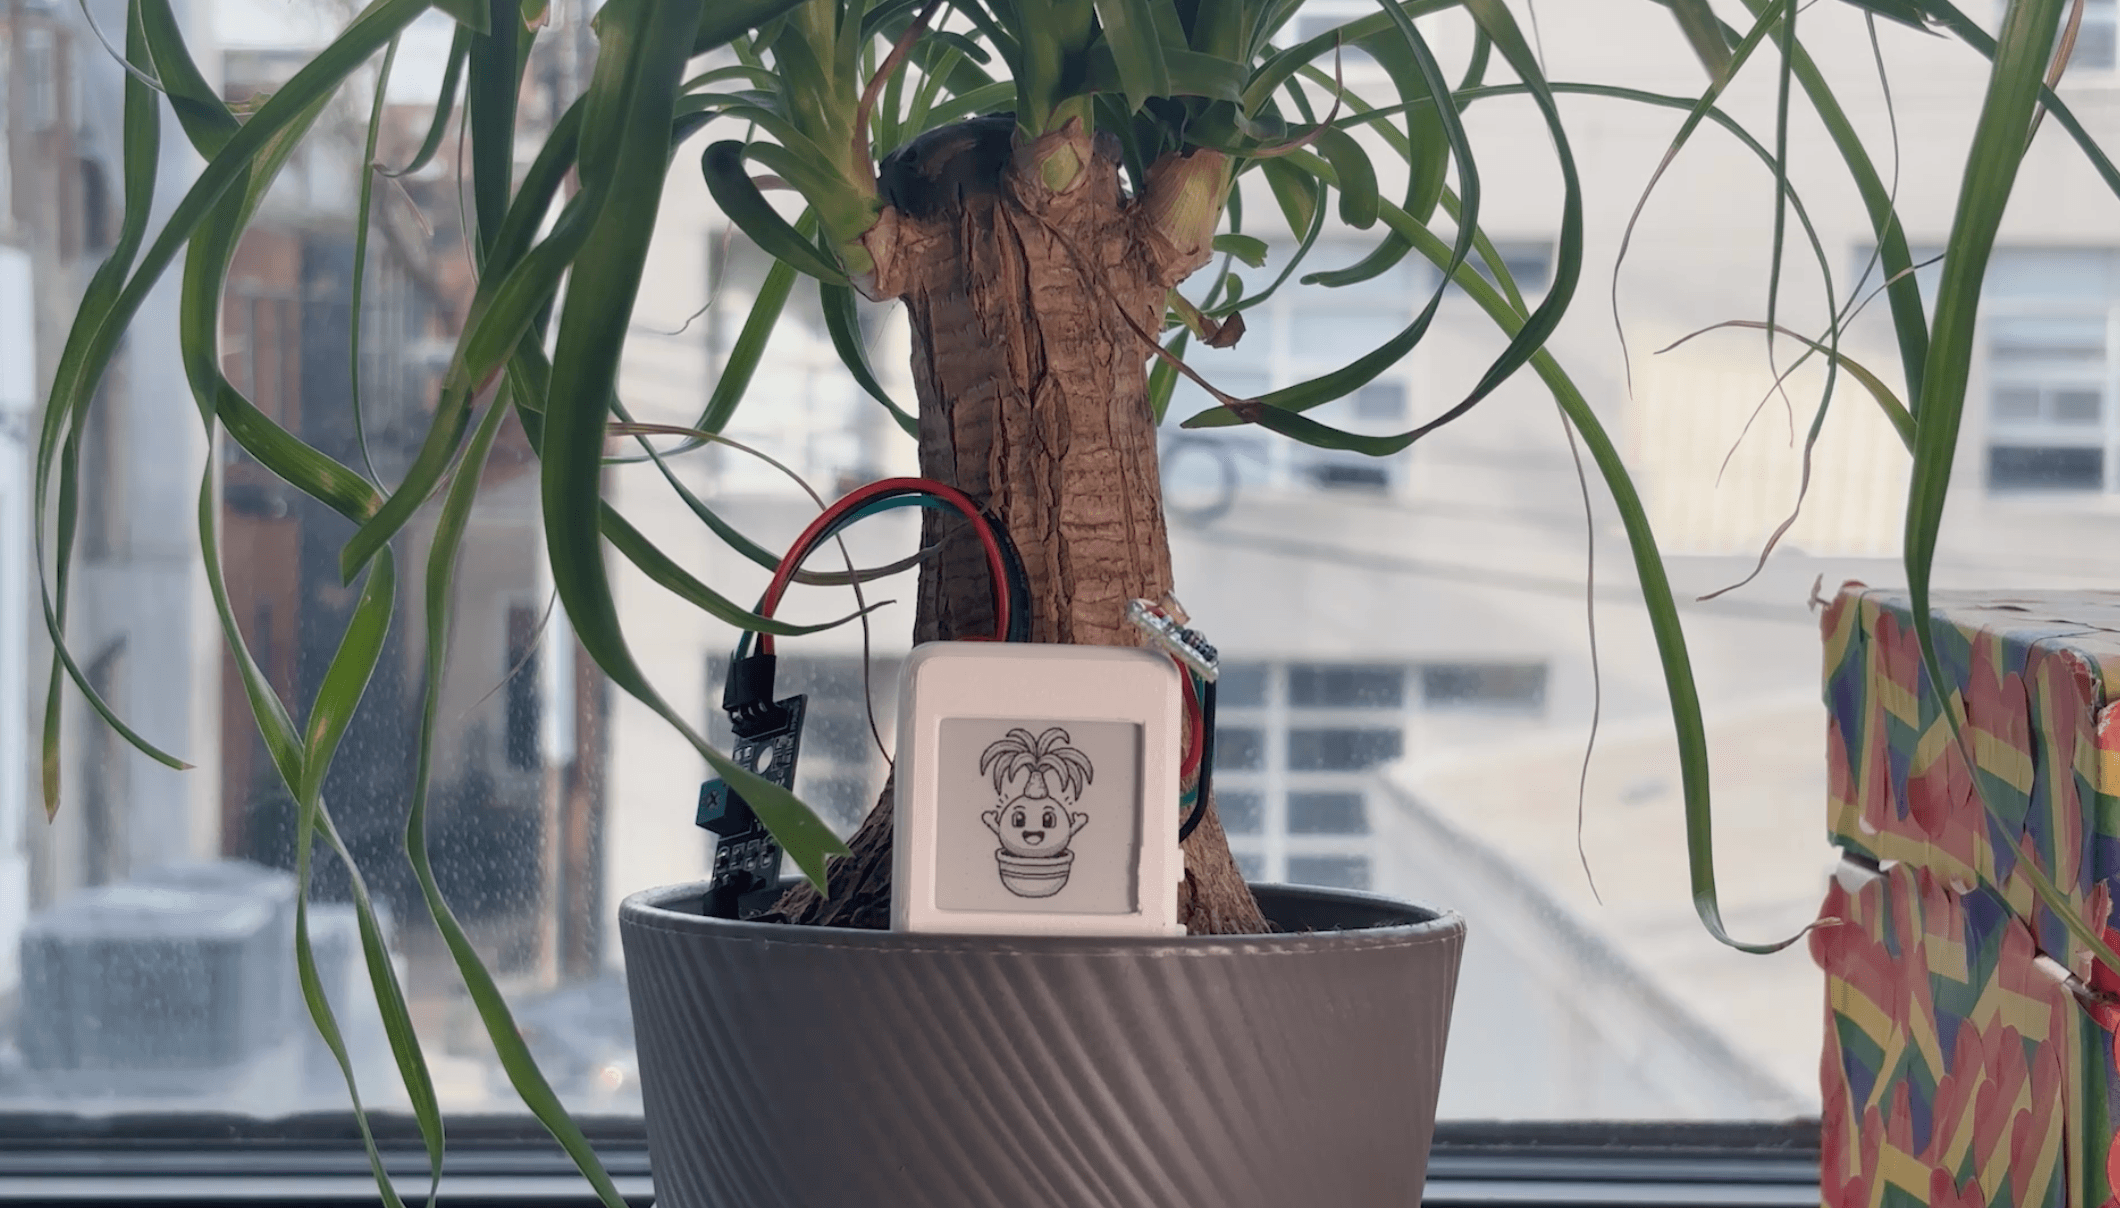
Daehwa Kim氏がACMシンポジウムでOATsを発表
Nvidiaが火曜に決算、FRBが水曜に10月議事録を公表、Anthropicは水曜にIPO価格を決定し、木曜にナスダックで「ANT」として取引開始予定
藤井氏がMuseの「Space」上でアプリを構築