何が起きたか
個人参加者がKaggleのRSNA膝異常検出コンテストで6,299チーム中67位に入り、Private LBのmacro AUCは0.949で、金メダルラインの0.954に迫った。
なぜ重要か
専門家ラベルが乏しい医療画像コンテストでは、レポート文からLLMに放射線科医の判断を予測させる方が、レポートをそのまま転記するより有効なラベル戦略になり得ることを示した。
こういう要約が、毎朝あなたのメールに届きます。
このコンテストの最大の難点は、訓練用4,407件のうち画像を読んだ専門の放射線科医がラベルを付けたのはわずか58件だったことだ。残りの症例には読影レポートのテキストしかなく、そのレポートは評価に使う専門家ラベルとは異なる基準に従っている。参加者は競技序盤、レポートの記述をそのままラベルに転記するだけでは真の陽性例の約4分の1を誤分類すると測定し、画像モデル改善の主なてこはラベル品質にあると見定めた。
この解法の要は、LLMにレポートの内容を尋ねるのをやめ、放射線科医のパネルが画像からどう判断するかを予測させることに切り替えた点だ。この捉え直しにより、専門家ラベル付き58件でのラベルのmacro AUCは0.9017に上がり、従来最良のラベルセットの0.8816を上回った。最終的な画像モデルは画像のみで訓練され、テスト時にレポートを見ることはないが、レポート由来の訓練ラベルの品質が性能に影響した。
上位チームとの差は、LLMに何を読ませたかにありそうだ。上位3チームはレポートとMRI画像の両方をLLMに読ませてラベルを構築したが、この解法はレポートのみを使った。参加者自身もLLMに画像を読ませる簡単なテストを58件で20分足らずで切り上げており、振り返ればこれが上位入賞を逃す一因になった可能性がある。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Bay AI Inc.が5000万ドルで始動した
Cyanogen共同創業者のKirt McMaster氏率いるKora Systemsが、アプリ間でAIモデルと自律エージェントを動作させるLinuxベースのデスクトップOSを発表
IPROSはAI-Industry World 2026で20分の無料セッション5本を発表
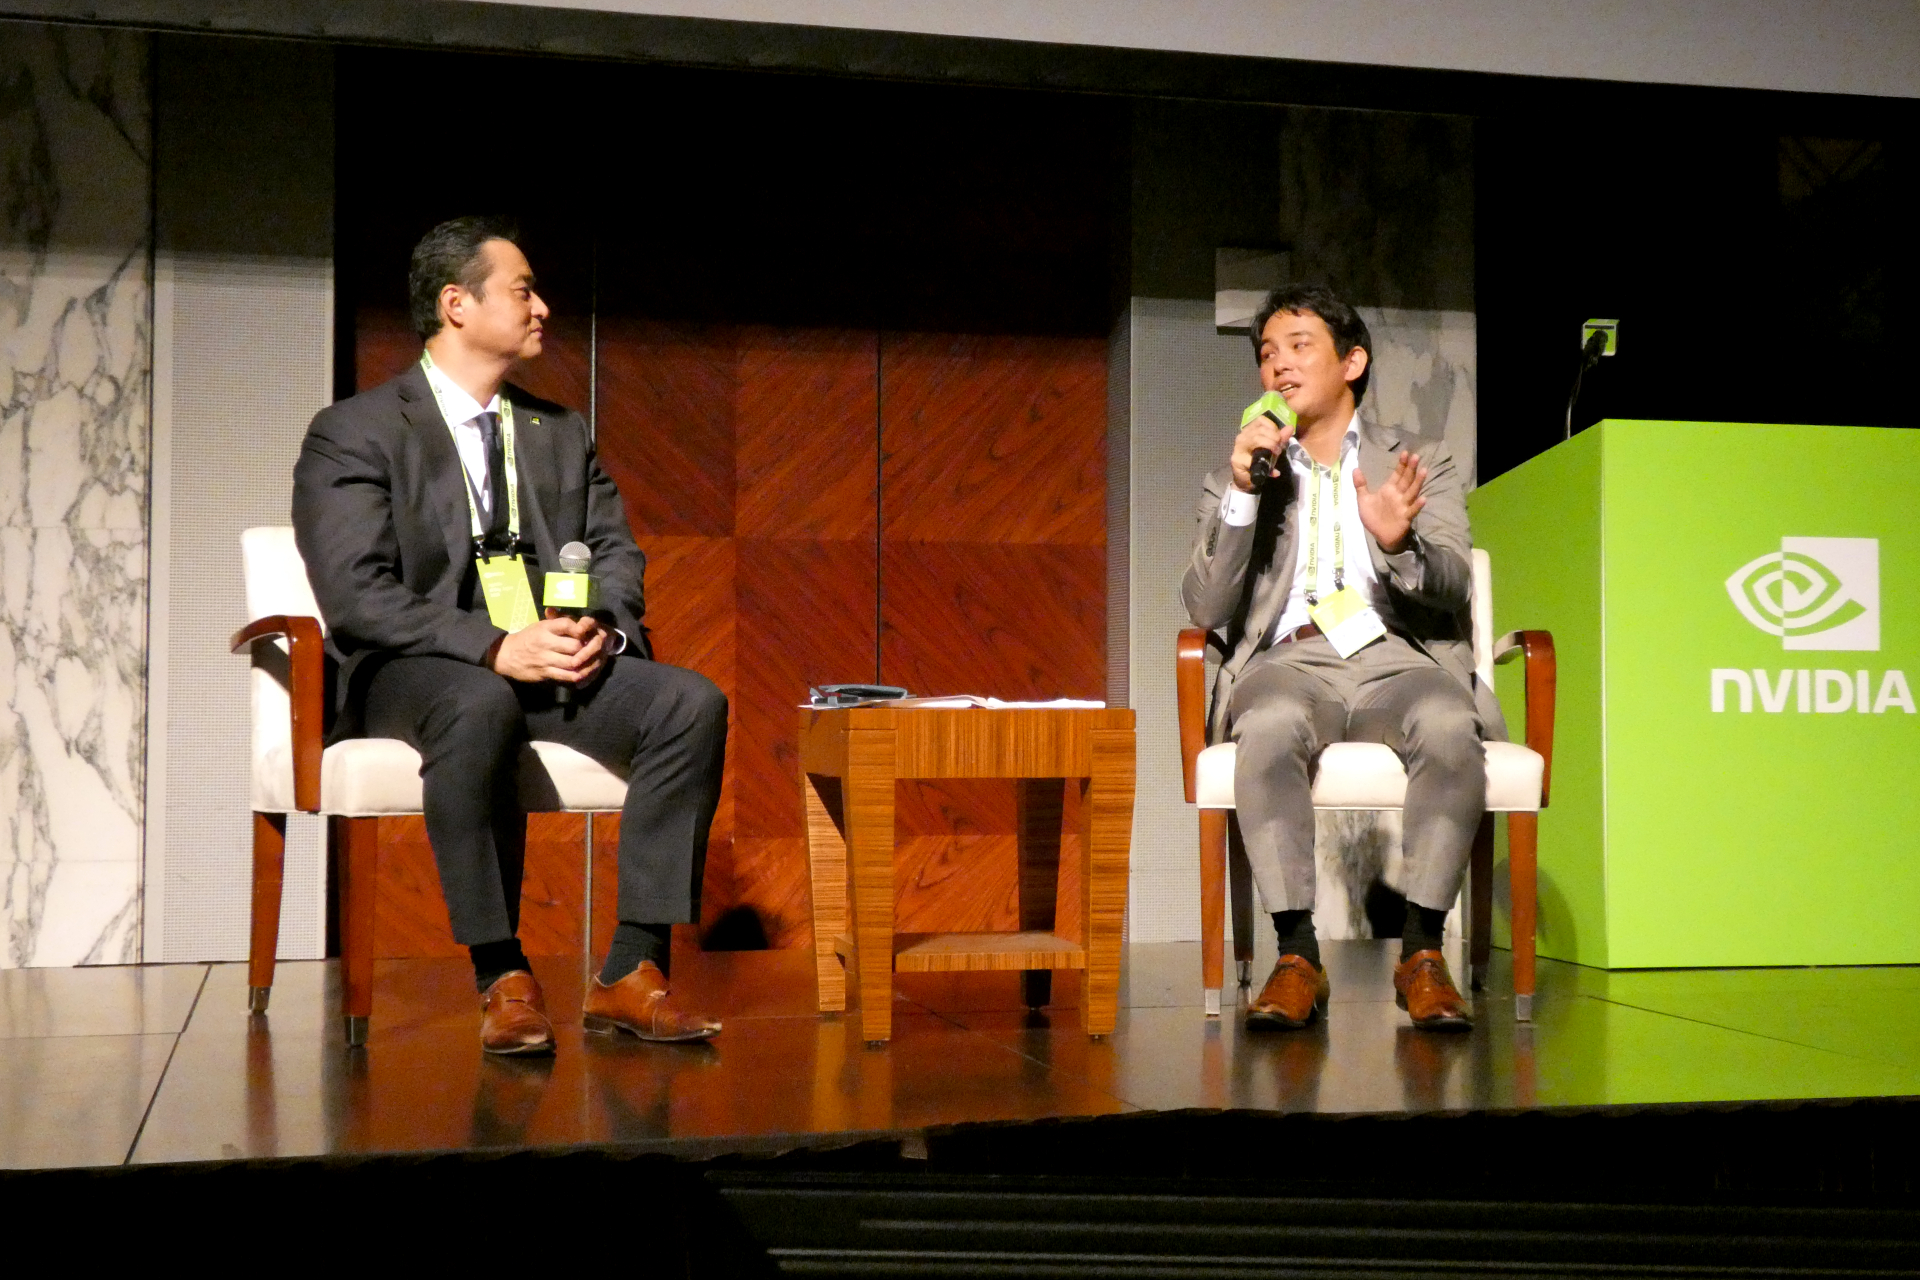
11月10日のNVIDIAのAgentic AI Day Japan 2026で、JAISTの今井翔太氏は、競争の激しい分野はフロンティアモデル、非競争的なタスクは主にオープンモデルになると予測した
Devon ThomasはAppleを辞めAbliteration AIを創業し、Z.aiのGLM-5.3などから安全策を外して販売
11月10日、OpenAI AcademyとCaregiver Action Network、Alzheimer's AssociationなどがOakland、Tampa、Pittsburgh、Atlanta、Detr…