何が起きたか
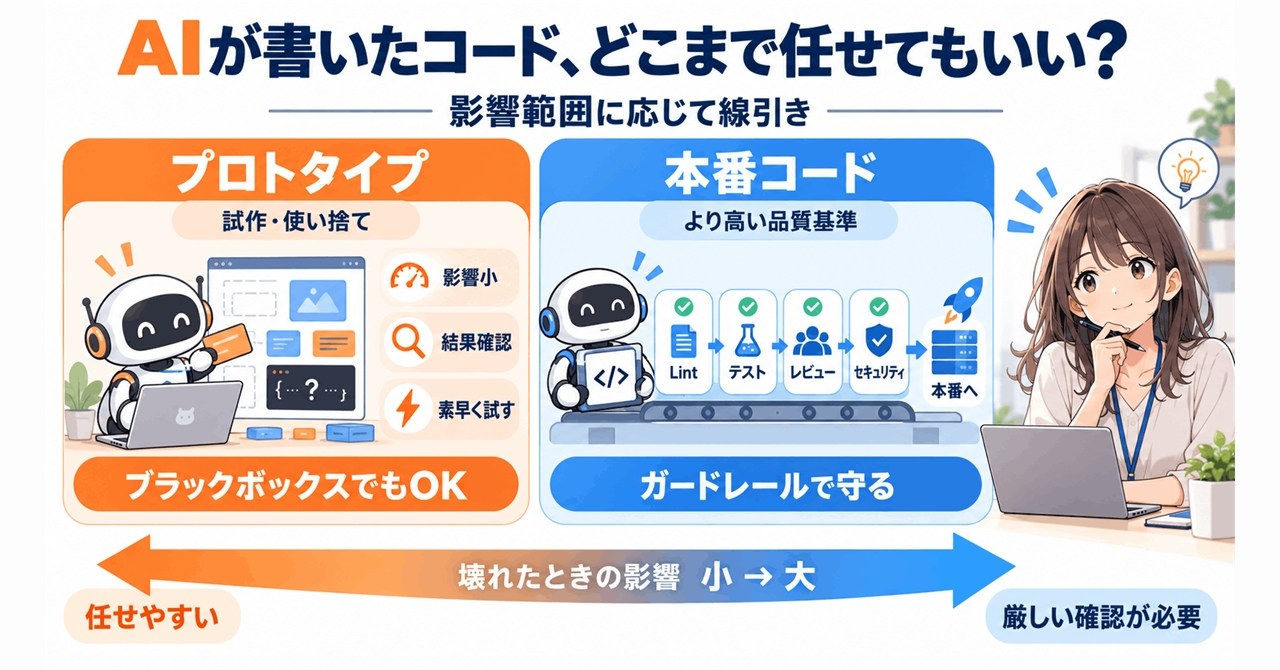
Claude Code作者のボリス・チャーニー氏が2026年9月11日、使い捨ての試作コードはブラックボックス扱いでよいが、本番コードには人間が書いたコードより高い基準を課すべきだと答えた。
なぜ重要か
試作と本番の実用的な線引きを示した点だ。Anthropic自身もLint、E2Eテスト、ファザー、コードレビューに頼っており、開発者に求められる品質基準を下げる話ではないと読める。
注目点
この考え方はテストと仕様が信頼できることが前提となる。
誰に効くか影響を受けるのはAIコーディングツールを導入する開発者とエンジニアリング責任者だ。出荷前にAI生成コードをどこまで実際に読みレビューするかを、コードの目的とリスクごとに判断する必要がある。チャーニー氏が挙げた防御策に照らすと、テスト網羅率が低い、あるいは仕様が緩いチームが最も大きなリスクにさらされる。
こういう要約が、毎朝あなたのメールに届きます。
チャーニー氏が答えた質問の主は、12年の経験を持つ開発者だった。その開発者は、AIが書いたコードは人間が全て確認すべきだという意見と、コードはブラックボックスとして出力だけで判断すべきだという相反する2つの立場を天秤にかけていた。悩みは、AIでコードを生成するのは簡単でも、AIが選んだ手法が本番に適切かどうかを判断するのに時間がかかることだった。チャーニー氏の回答は、どちらにも余地があるというものだった。
チャーニー氏の回答で両者を分けるのは、単一のルールではなく目的とリスクだ。同氏はAnthropic自身の本番環境を挙げ、Lint、E2Eテスト、ファザー、コードレビュー、セキュリティレビュー、ドキュメントの維持がガードレールとして機能しているとし、開発者の役割はコード品質の基準を守ることだと伝えている。また、Claudeのモデルが賢くなるにつれ、品質管理の仕組みは回しやすくなるとも述べている。
筆者自身の実践は小規模な事例として紹介されている。データ分析などの試作では、AIが生成したコードを全て読むことはしないが、完全なブラックボックス扱いもしない。どんなコードが書かれているかの感覚は保ち、実行結果がおかしいと感じたときはAIにやり直させる。重視しているのは、expect(true).toBe(true)のようなテストは意味がなくても通ってしまうため、テストを blind に信じないことだ。ブラックボックス化が成立するかどうかは、AIがコーディング作業の多くを担う中で、信頼できるテストと文書化された仕様という、小規模チーム向けに筆者が勧める2つの出発点をどこまで広げられるかにかかっていそうだ。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
NVIDIAが「NVIDIA Open Agent Safety Platform」を発表
NVIDIAはNVIDIA Open Agent Safety Platformを発表した
Kalkine Mediaによると、Home Depot(NYSE:HD)が小売業務向けのAIアシスタントを導入する
NvidiaがAIエージェントの暴走を防ぐセキュリティ基盤を発表した
AMDは月曜、Fei-Fei LiのWorld Labsを約82億ドルの全株式交換で買収すると発表
ServiceNowのBhakti Pitre氏はOktaのOktaneイベントで、問題を起こすAIエージェントの「キルスイッチ」は単純なオンオフではないと述べた