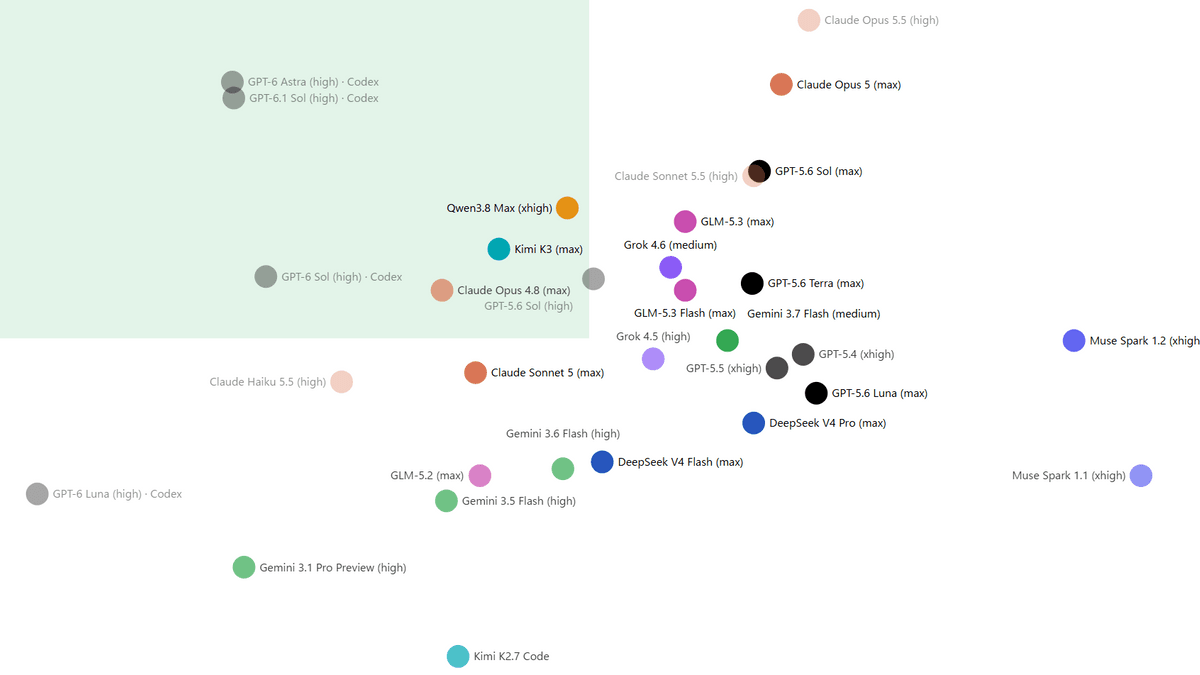
何が起きたか
Parsimonyは既存ベンチマークのAI修正を分析し、コーディング単位の追加数と削除数を比較。
なぜ重要か
高い問題解決スコアは簡潔なコードを保証しないため、AIコーディングツールを評価するチームは精度と並び保守性も考慮する必要がある。ただし開発者はコードが少ないほど高品質とは限らないと注記している。
誰に効くか同じ問題を修正する際に各モデルがどれだけコードを追加するかを比較するため、AIコーディングアシスタントを選ぶソフトウェアエンジニアやエンジニアリングマネージャーが主な対象となる。長期間維持されるコードベースの担当者にとっては、単純な解決率よりも追加コード量の指標が参考になるかもしれない。
こういう要約が、毎朝あなたのメールに届きます。
このベンチマークは、AIコーディングツールが問題を解けるかどうかとそのコストで評価されることが一般的な時期に登場した。Parsimonyはそこに第三の軸、すなわちモデルが目的達成のためにどれだけコードを書くかを加える。測定単位は不正を防ぐよう設計されており、行数ではなく条件分岐や関数呼び出し、変数名、数値を数え、改行や空白、コメントを除外することで、コードを少ない行数に圧縮しても結果が良く見えないようにしている。テストコードやドキュメント、自動生成ファイルは測定対象から外される。
公開された比較では、縦軸にAI評価サイトArtificial Analysisが算出するIntelligence Index、横軸に他モデルに対する追加コード量を取っている。この分布から、高い指数がそのまま簡潔な修正を予測するわけではないことがうかがえる。開発者はこれが両面に作用すると注意を促す。短いコードは追いにくいことがあり、量だけでは可読性や設計について断定的なことは言えない。
ソースコードと測定データがGitHubで公開されているため結果は再現可能で、開発者は追加モデルの修正データと評価手法へのフィードバックを募っている。比較対象がこれまでに示されたモデルを超えて拡大する可能性を示す動きだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
GoogleはPyTorch互換フレームワークTorchTPUを公開した
E-Commerce Benchで18のAIモデルが最大4店舗を365日運営し、18のツールで仕入れ・価格・配送・返品・資金を処理

ITmediaのAI Plusが、Gemini Notebook(旧NotebookLM)のStudio機能の活用ガイド14ページを公開
ALTK-Evolveは接客エージェントの試行から成功と失敗を短い行動規則にまとめ、モデルの重みを変えずに次の実行時の指示へ追加する

セキュリティ人材採用を専門とするコンサルタントは、求職者はChatGPT PlusかClaude Proのどちらか1つを契約して使い切り、不足したらもう一方を追加すべきだと述べた
TypeSafe AIのJevを6回調整後、著者が100件のリクエストでgrepを使うClaude(Opus)と比較したところ、Opusはノートが必要な77件中52件を正解し、Jevは24件だった

