何が起きたか
AWSはAgent Toolkit for AWSに分散KVキャッシュのスキルを追加し、KiroやClaude CodeなどがAmazon ElastiCacheのキャッシュを確認・サイジング・構築できるようにした。
なぜ重要か
このスキルにより、コーディングエージェントが数回のプロンプトで共有キャッシュ層を評価・設定でき、自社運用LLMの導入でサーバー間の冗長な処理を減らせる可能性がある。
誰に効くかvLLMやSGLangの基盤を運用するなど、GPU上でLLMを自社運用するチームは、インフラ導入前にこのスキルで共有キャッシュが費用対効果を生むか評価できる。
こういう要約が、毎朝あなたのメールに届きます。
このスキルは、自社運用LLMが大きなコンテキストを再送する際の冗長なGPU処理を避ける手段として位置づけられている。数十万トークンの判例履歴を持つ法律AIアシスタントが典型例だ。弁護士がスレッドに戻ると、リクエストを引き受けたGPUサーバーは応答前に全トークンのキーバリュー注意状態を再計算する。AWSによると、Amazon ElastiCacheによる分散KVキャッシュで自社運用LLMの推論コストを最大40%、最初のトークンまでの時間を最大80%削減できる。スキルはコーディングエージェントを4つのフローで導く。最初のトークンが遅い原因の診断、キャッシュのサイジングと価格算出、構築、転送失敗時のトラブルシューティングだ。費用をかける前に、エージェントは読み取り専用のdescribe-instances呼び出しでGPU基盤を調べ、EFAインターフェースを数える適合性チェックを行う。その後、エンジン、モデル、テンソル並列サイズ、KVデータ型、サーバー価格、プロンプトの繰り返し頻度など、目視できない情報だけを尋ねる。サイジングではKVTraceを使い、追加料金なしで顧客自身のトラフィックから節約額を見積もり、節約額がキャッシュのコストを賄えない場合は停止する。スキルはベストプラクティスも実装しており、ローカル層を空にすること、本番トラフィック前にキャッシュを読み込んだ2回の実行が同じ出力になることを確認すること、影響の大きい操作には明示的な承認を得ることが含まれる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
シティは今月、オンラインユーザー契約に新条項を追加し、第三者AIエージェントによるアクセスや取引は、認証情報漏えいや指示超過でも顧客承認とみなすと明記した
通訳者サラ・カンポスはベルリンの長年の顧客をAIに奪われた
Teslaのハッカーgreen(@greentheonly)氏が、ファームウェア2026.44.1でTeslaがAI Computer(HW4/AI4)を「Super Intelligence Computer」に改名し…
テキサス・インスツルメンツは好調な第3四半期決算を報告し、Code Composer Studioをエージェント型AIツールに拡張した
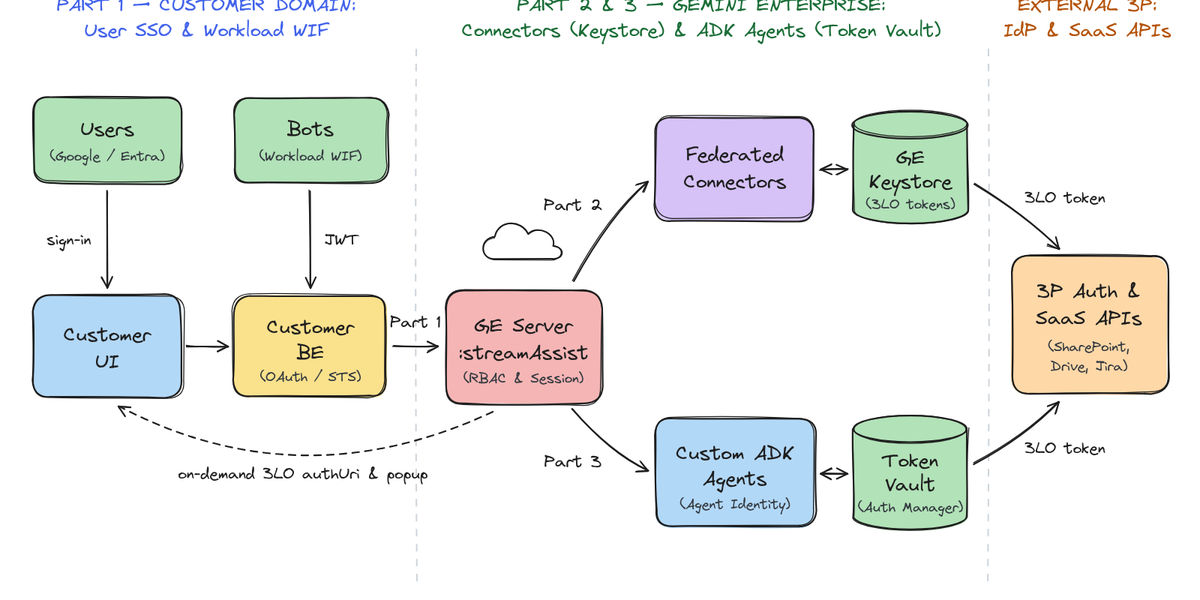
GoogleはGemini EnterpriseをCustomer UIに組み込む企業向けに、StreamAssist APIの認証を3層に分けて解説し、コードをGitHubで公開した
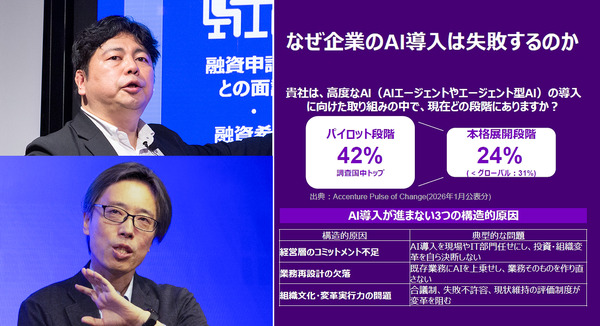
アクセンチュアは、生成AIエージェント同士が案件について協議し、その後人間が判断を下す融資業務の再設計を実演した