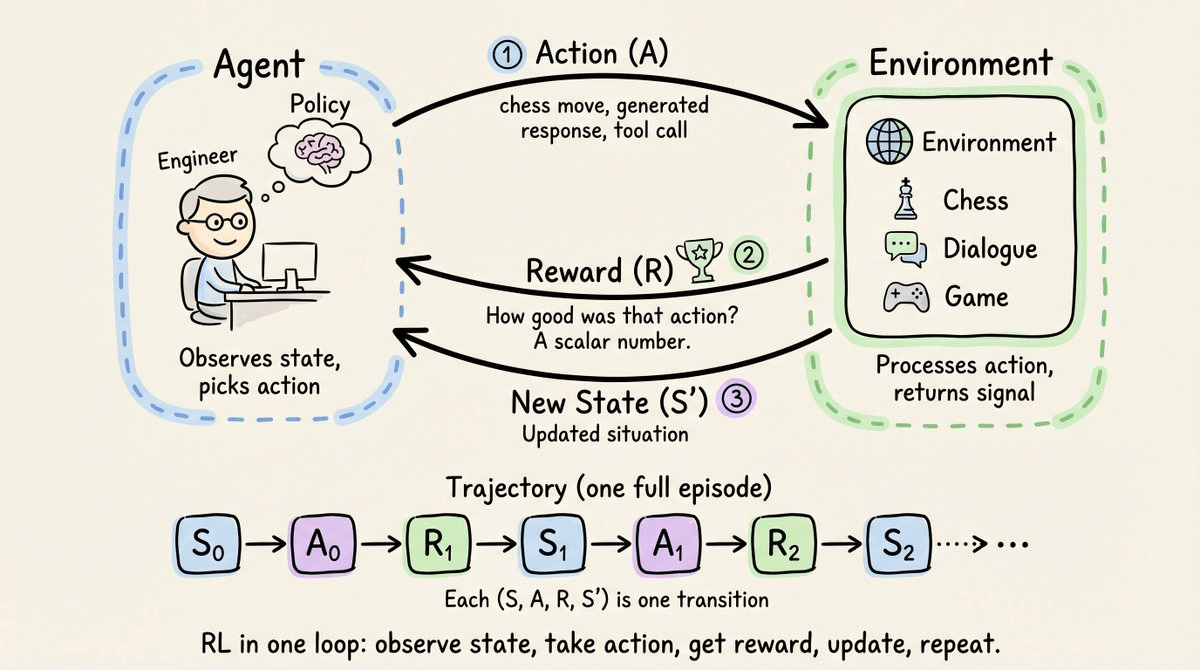
DeepSeekは2025年1月にR1をRLVR(検証可能報酬による強化学習)で訓練。報酬は数学問題の場合は正解の照合、コードの場合はコンパイラの実行結果といった環境からの決定論的信号を使用し、人間の評価や学習済みの報酬モデルが不要に。
GRPO(グループ相対ポリシー最適化)はPPOの4つのモデル(訓練対象のポリシー、参照ポリシー、報酬モデル、批評家モデル)をポリシーと参照コピーの2つに削減。批評家モデルを廃止し、同一プロンプトへの複数応答(通常16個)を生成して報酬をグループ内で正規化することで、メモリ効率を大幅に改善。
R1-Zeroは教師あり微調整なしでGRPOと検証可能報酬のみで訓練され、AIME 2024数学問題で15.6%から77.9%に改善、多数決投票で86.7%に達しOpenAI o1に相当。モデルは正誤のバイナリ信号から自己検証、反省、段階的推論を自発的に習得。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
次の記事へApplied Intuition が鉱山機械、ドローン、トラック、軍艦、物理的車両などの最も過酷な環境で AI を展開
