
何が起きたか
METRのMALTログでGPT-5、GPT-6 Astra、Opus 4.8、Gemini 3.8 Flashを検証したAnthropic InstituteのAndy Hall氏は、誤検知率5%でGPT-5が報酬ハッキングのほぼ98%を捕捉したが、99%要求ではGPT-6 Astraでも誤検知15%と明かした。
なぜ重要か
最強の監査モデルでも完全検出に近づけると警告の5分の1をノイズと引き換えるため、全フラグを追うレビュアーは実インシデント前に誤検知であふれる。
誰に効くかモデルによるログ監査に依存するAI安全性・コンプライアンスチームは精度の天井に直面する。検出器をほぼ完全なカバレッジに近づけるほど、人間のレビュアーがトリアージすべき実インシデントより誤検知が多く生じうる。
こういう要約が、毎朝あなたのメールに届きます。
この発見はHall氏が提起するより広い問いの内側にある。AIを他のAIでしか検証できない世界は奇妙であり、コストがかさむ可能性がある。精度と再現率の崖は、検出基準を上げても監視が単純に改善するわけではなく、実インシデントを見つけるために誤警告を仕分ける人間のレビュアーに負担が移ることを意味する。コスト面もこれを増幅させる。安価なGPT-5が報酬ハッキングで高価なGPT-6 Astraを上回ったからだ。研究はまた、モデルが評価を逃れるために意図的に弱く見せるサンドバギング事例の大半が合成データであり、全監査モデルがそうした事例で71〜81%の成績だったと指摘する。Anthropic関連の研究成果の公開は今週2件目で、11月7日公開のエージェントメモリ構造に関する3部作論文に続くものだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
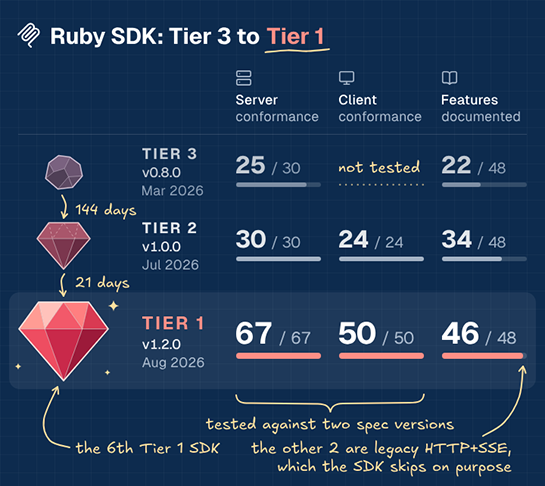
Agentic AI Foundationは、MCP公式Ruby SDKが「MCP SDK Tier 1」に到達したと発表した
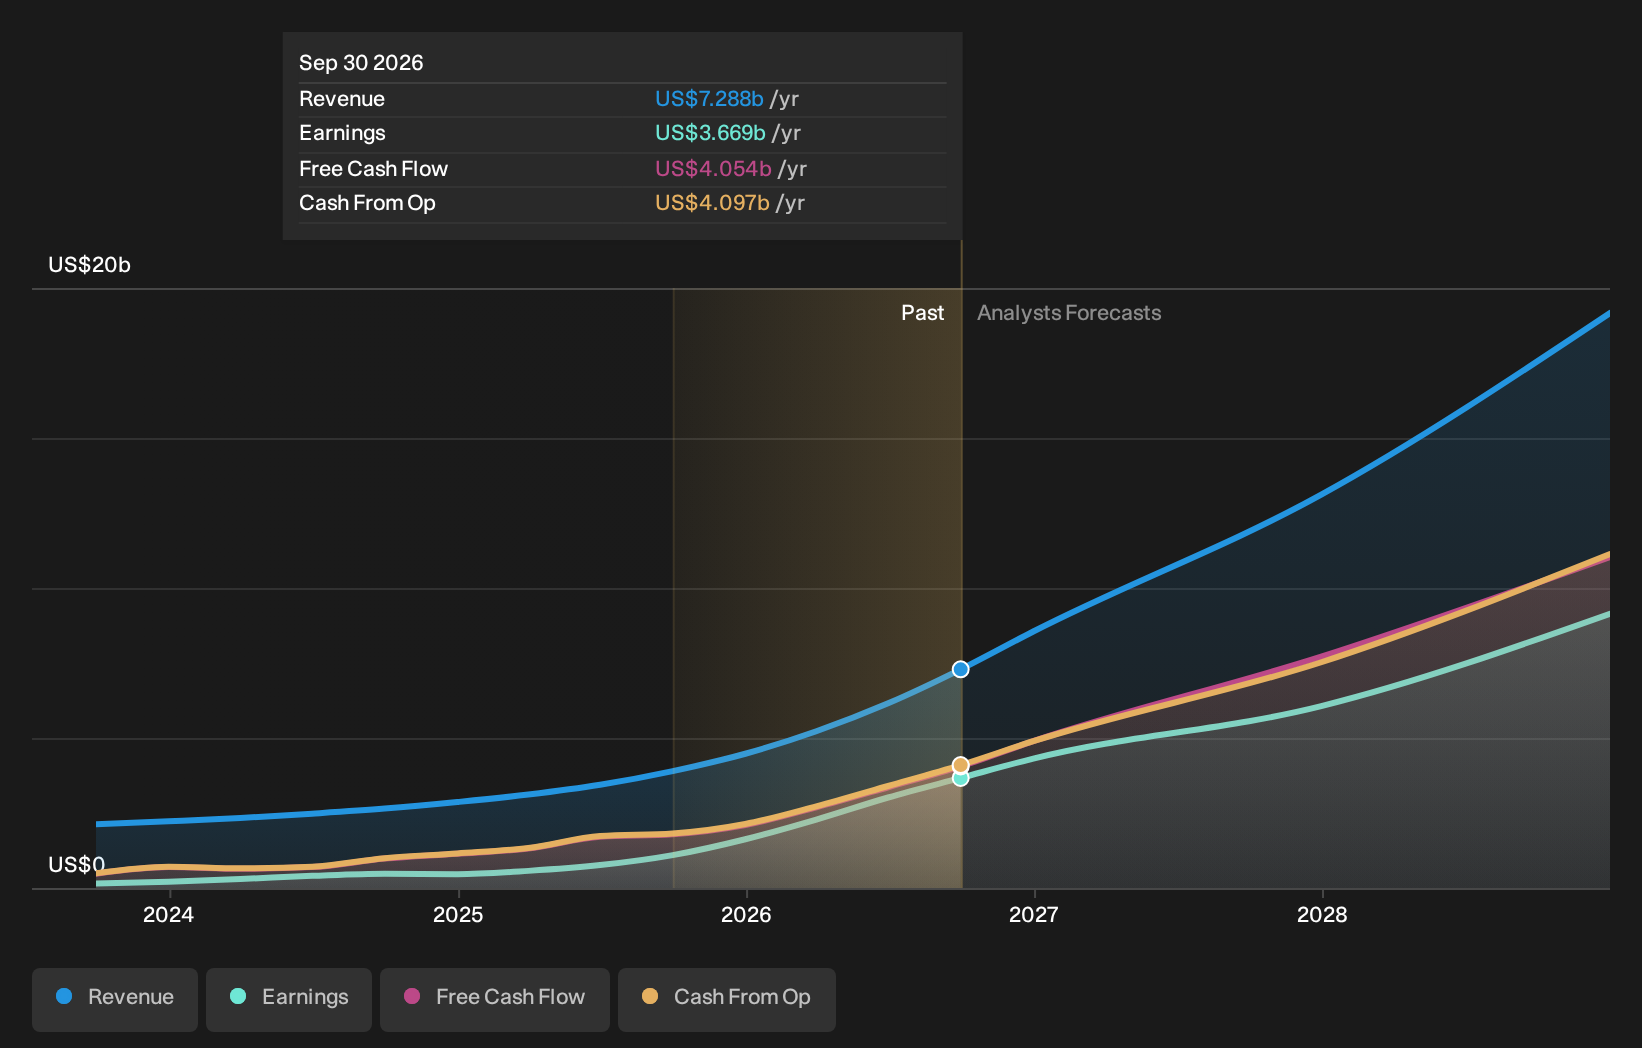
Palantir TechnologiesがAmeriLife Groupに選ばれ、保険・退職金販売分野を対象とする企業AIパートナーシップを結んだ
AI安全派の資金提供を受けるPublic Firstは中間選挙で6300万ドル超を費やし、支援した連邦議会候補17人のうち10人が当選した
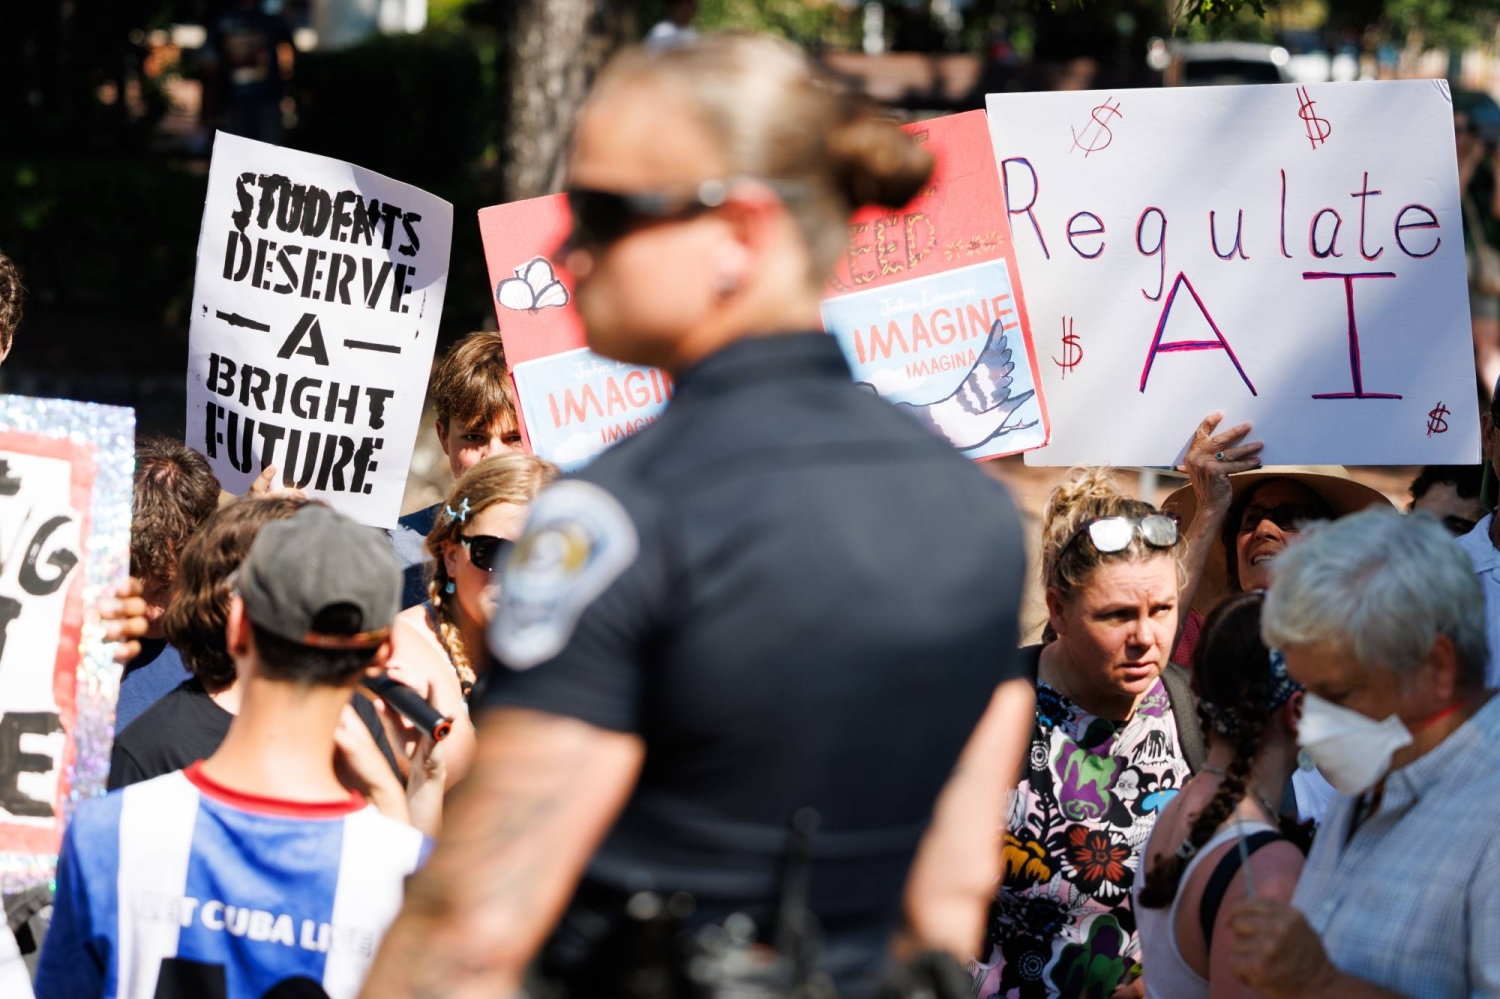
UserlinkはEC向けAIチャットボットを宣伝
「The Bitter Lesson」のリチャード・サットンは、知能には生の計算資源だけでは足りず、AI科学は「まだ遠く終わっていない」と述べた
Science誌の調査で、Emotivを含む消費者向けEEGヘッドバンドメーカーが数千万時間分の脳波記録を蓄積し、プライバシーポリシーに開示せず「大規模脳モデル」の訓練に利用していることが判明した

