何が起きたか
Qiagenは150人超のMD・PhDレベルの専門家を擁し、25年以上にわたり生物医学データを手作業でキュレーションしてきたとBhattacharya氏は述べた。
なぜ重要か
この取り組みがQiagen Discovery Platformの基盤となり、Model Context Protocolアクセスとエージェント型Discovery Explorerを追加する。
注目点
このアプローチは、キュレーション済み知識が実際に幻覚出力を減らせるか、また5月にNvidiaと組んだ創薬向けグラフベースAIが使える成果を出すかにかかっている。
誰に効くか創薬にAIエージェントを使うバイオファーマ企業は、速いが信頼できない出力と、遅いが追跡可能な結果のどちらかを選ぶことになる。Qiagenは、幻覚ではなく正確で出所のある答えを必要とする研究チーム向けの解決策として、自社のキュレーション済み知識ベースを位置づけている。
こういう要約が、毎朝あなたのメールに届きます。
Qiagenの訴えは、バイオファーマAIでよく知られたギャップに立脚している。エージェントは素早く答えを生成できるが、本物の結果ともっともらしい捏造を見分けられるとは信頼できない。エージェントは「決してノーと言わず」、「合成結果を出す」というBhattacharya氏の警告は、問題をモデル能力ではなく出所の問題として位置づけている。同社の対応は、モデル層を分離し、その下の知識層に集中することだ。この基盤は150人超のMD・PhDレベルの専門家が25年以上かけて築いてきた。
この基盤は現在、Qiagen Discovery Platformに組み込まれ、Model Context Protocolアクセスとエージェント型Discovery Explorerを追加している。5月のNvidiaとのグラフベースAI提携は、Qiagenが知識グラフを、このコンテキストをエージェントが使えるものにする構造と見ていることを示す。Bhattacharya氏は目標を、サイロを避けシステムをより広いエコシステムの一部にすることだと述べた。これは単独ツールではなく既存の製薬ワークフローとの統合を指す言葉だ。
成否は、キュレーション済み知識が実際の創薬パイプラインで幻覚出力を測定可能な形で減らせるかにかかっている。製薬顧客はすでに、競合より早く正確な適応症に到達できるかで投資収益を判断している。したがって試練は、Qiagenの基盤が追跡可能性を犠牲にせずその速さを実現できるかどうかだ。もし実現すれば、人手キュレーションを差別化要因とする同社の賭けは、主にモデル層に注力する競合に対して持ちこたえられるかもしれない。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
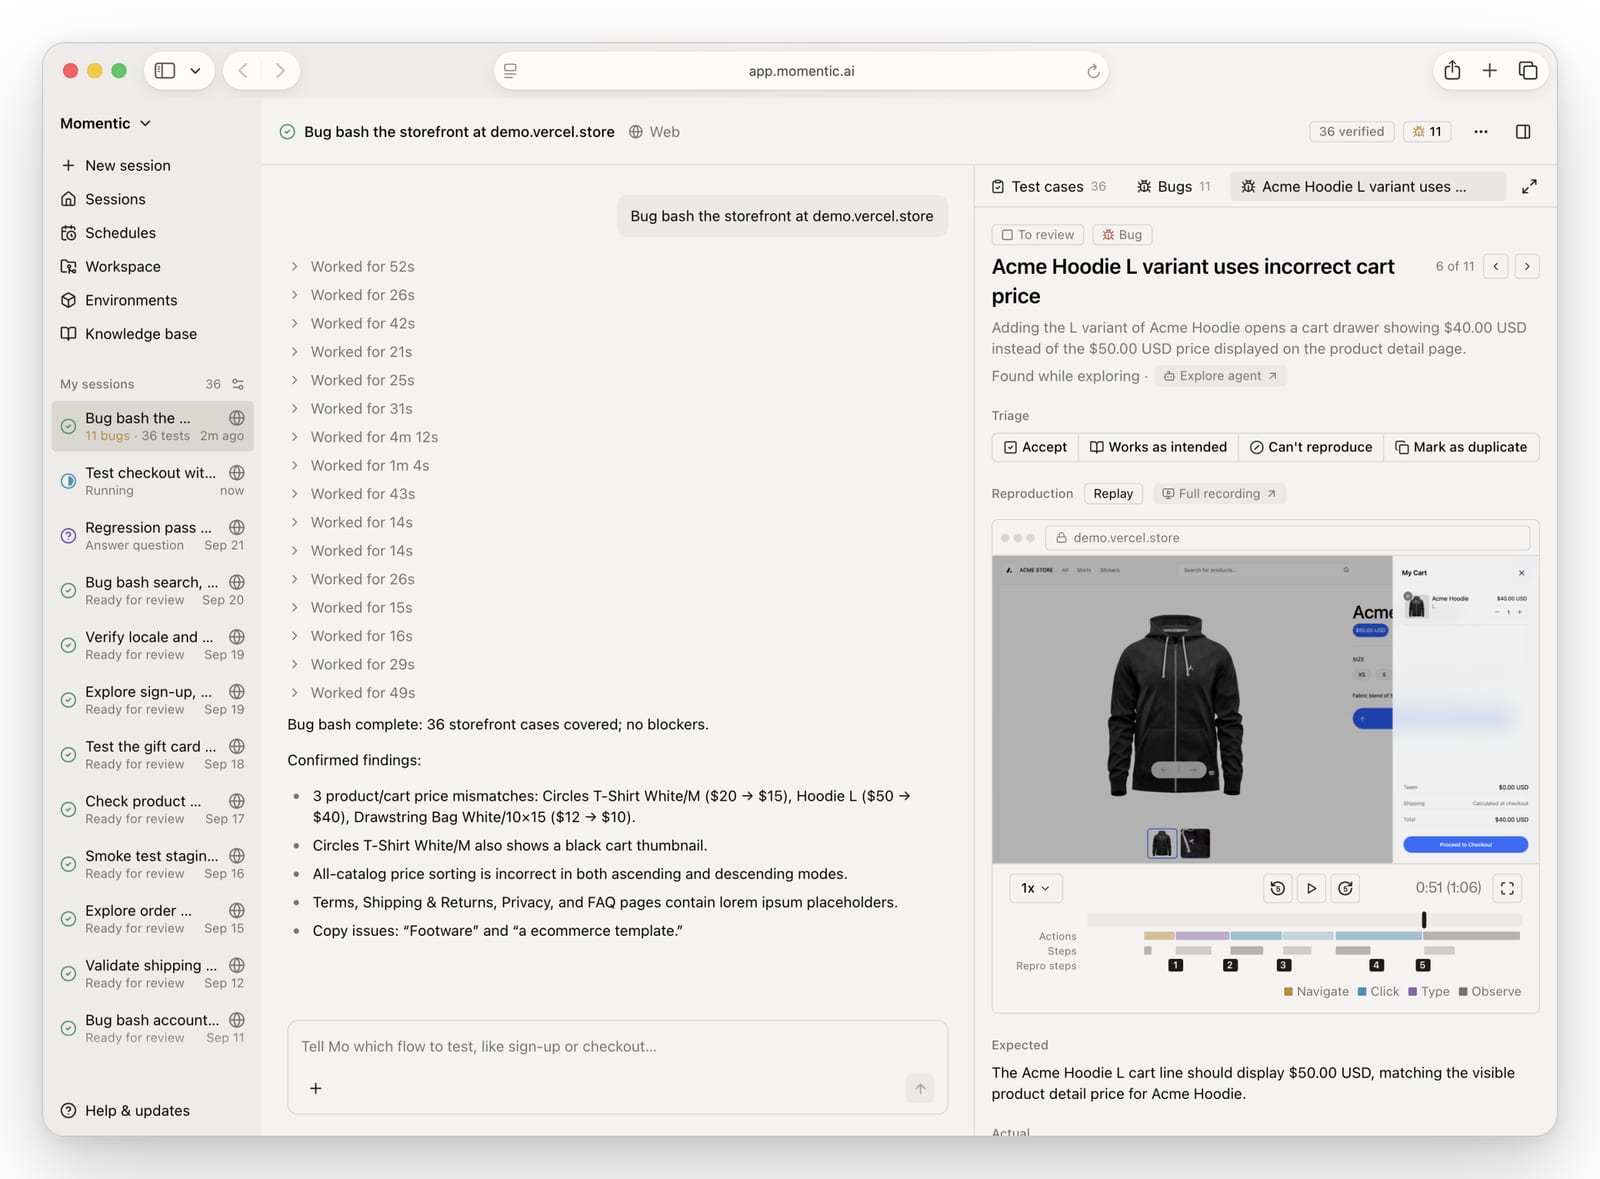
MomenticがAIエージェントMoを発表した
NEAR ProtocolのNEARは2週間で2倍超
Anthropicは今年初め、Claudeエージェントが生物学の問題を読み推測する分子生物学ラボを開設し、950体のエージェントが21時間後に既知の酵素周辺の反復パターンを検出したと発表した
Metaは月曜日、Meta Enterprise Platformを発表し、MongoDB CEOのChirantan "CJ" Desaiを責任者に迎えた
OpenAIは不正エージェント9件を載せた「misalignment reports」サイトを公開
Anthropicが中間モデルSonnet 5.5を公開