何が起きたか
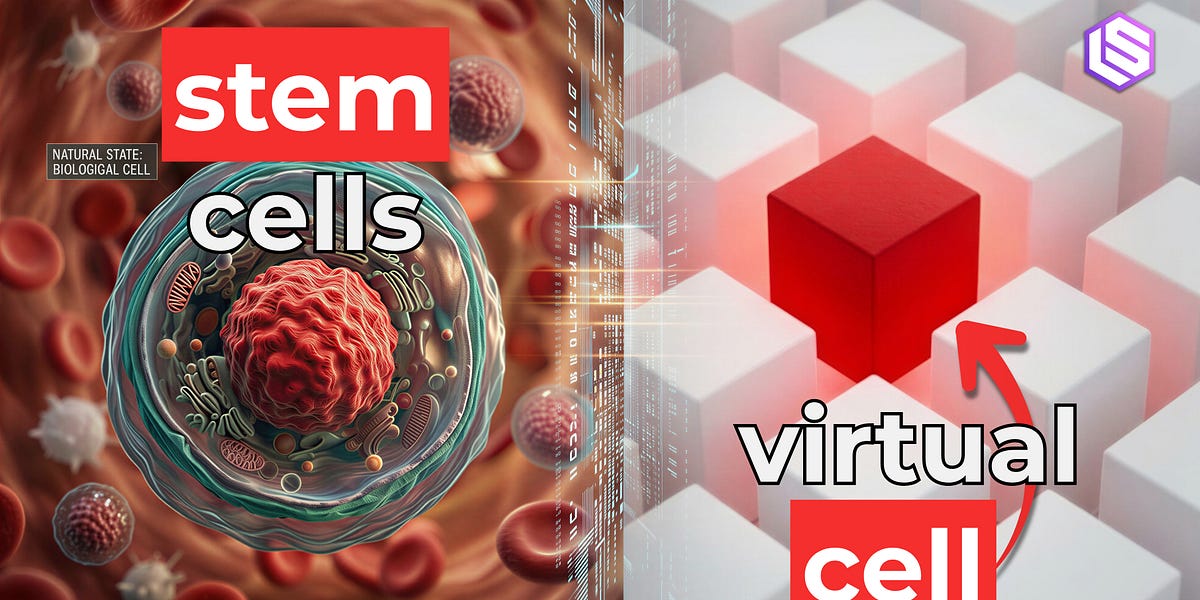
最高発見責任者Ci Chuと最高AI科学者Bo Wangが率いるXaira Therapeuticsが、X-Cellという新しいAIモデルを開発した。このモデルはCRISPR実験のデータセットX-Atlasで訓練され、個々の遺伝子変化を単離している。従来のアプローチは単一データセットで31億パラメータの壁にぶつかっていたが、因果関係データにより、パラメータと計算量の両面でスケーリングを継続できるようになった。
なぜ重要か
それまでのRNA発現モデルはCELLxGENE(1億6800万細胞のデータベース)で訓練され、細胞型と状態を説明できたが、遺伝子編集や医薬品標的化時の予測ができなかった。遺伝子発現の変化は高度に相関しており、因果関係の推論が困難だったからである。X-Cellの因座データにより、遺伝子変化の実際の結果を予測でき、研究者が医薬品や遺伝子編集の効果を実験前にモデル化でき、AI駆動の医薬品開発を現実化する可能性がある。
注目点
Xairaの戦略は、X-Cellが実験室の実際の人間細胞実験に一般化するかどうかにかかっている。チームは自己回帰訓練から拡散モデルに転換し、従来のモデルを上回った線形ベースラインをX-Cellが超えたと報告している。このアプローチが検証で機能することの具体的な証拠である。
こういう要約が、毎朝あなたのメールに届きます。
Xairaの研究を推進する中心的な洞察は、遺伝子発現モデリングにおける相関関係と因座関係の区別である。CELLxGENEで訓練された従来のAIモデルは、どの遺伝子がどの細胞で発現しているかを捉えられるが、遺伝子が撹乱されたときに何が起こるかを確実に予測することはできない。遺伝子発現の変化は高度に相互依存しており、観察データだけから因座方向を逆算することはほぼ不可能だからである。Xairaの解決策は、CRISPRを使って一度に1つの遺伝子を撹乱する実験データを収集し、数百万の並列テストを実行して因座関係を明示的にエンコードするデータセットを構築することである。この因座データが瓶首であることが判明した。チームの初期モデルは31億パラメータで平坦化したのは、小さく相関的なデータセットがその情報内容を使い果たしたからだが、データを約30倍スケーリングすることでパラメータと計算が増加するにつれて改善が続いた。これは、モデルが容量ではなく以前は情報不足だったという古典的な信号である。Chuを最高発見責任者に、Wangを最高AI科学者に昇進させたことは、Xairaがこのデータ中心で因座モデリングのアプローチを長期的な医薬品発見戦略の中心と見ているのを示す。
たとえば、いま届くならこの3本です
AIが要約して、あなたの選んだトピックだけを1日1通。LINE・Email・Slackで届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。Q&Aはこのページに公開され、他の読者も読めます。
MetaがMuse AIエージェントを発表し、Intelなど半導体株が急騰
IambicとAbbVieがAI創薬で提携したとMobiHealthNewsが報じた
Apptopiaの推計によると、Museは最初の12日間で米国とカナダでiOSダウンロード180万件を記録し、ChatGPTの130万件を上回った
OpenAIはプリンストンの高等研究所を拠点とする数学・人工知能諮問グループを発表し、内部モデルが100件以上の未解決問題を解決したと述べた
Higgsfield AIはGPT-6 Astraを使い、新たな探索機能を1日で提供したと共同創業者兼CEOのAlex Mashrabov氏が述べ、Astraの長期タスク計画を評価した
AWSが「Strands Harness」を公開した