何が起きたか
Together AIはノード自動修復機能の一般提供を開始した。失敗したヘルスチェックが裏付けとなる場合に限りノードを修復する。
なぜ重要か
壊れたノードと一時的に到達不能なノードが同じに見えるNotReadyシグナルを避け、ドライバやストレージ障害で大量交換が起きない安全策を備える。
誰に効くかトレーニングや推論のために大規模なGPUフリートを運用するチームと、そのクラスタを運用するプラットフォームエンジニアは、独自の検知器を受け入れ、各障害の承認者を定義する修復パイプラインを手に入れる。
こういう要約が、毎朝あなたのメールに届きます。
Together AIは今年初め、完全自動のノード修復機能を初めて発表した。GPUクラスタの顧客と社内推論プラットフォームの双方がこの機能をワークロードの回復力向上とダウンタイム最小化に活用してきたとし、今回その仕組みを説明している。
設計は、多くのノード自動修復が単一のシグナル、すなわちノードがNotReadyになったことに依存している点への明確な批判から始まる。このシグナルはノードが壊れていても一時的に到達不能なだけでも同じに見え、ストレージやネットワークのイベントが多数のノードに同時に及ぶと、影響を受けた全ノードがNotReadyに落ちる。Togetherのルールは、失敗したヘルスチェックの裏付けなしにノード修復は行わないというもので、すべての修復には根拠が伴う。
パイプラインはハイパーバイザーの両側で検知を行う。GPUは顧客のVMに直接パススルーされる一方、ホストとファブリックの障害はホストから見えるためだ。最初の3段階(検知、判断、修復)は顧客のクラスタ上で実行され、第4段階の再検証はノードが先ほど退いた物理ホスト上のTogetherインフラで実行される。修復の判断はGPUベンダーではなくアラート、ノード、マシンに基づくため、新しいアクセラレータを導入する際は検知と診断の部品を追加するだけで、下流はすべてそのまま引き継がれる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
FlashLabsがOrcaRouterゲートウェイのTrace Exportを強化し、SDKやコード変更なしでAIリクエストのトレースをGrafana、Datadog、Langfuse、LangSmithへリアルタイム…

KivaのSamurai Appに、ヤマト運輸「ビジネスメンバーズ」の顧客コードへログインし運賃と請求金額を取得、複数コード・複数月の運賃CSVを一括ダウンロードできるAPI連携を追加
kickflowはシリーズAで約10.6億円を調達
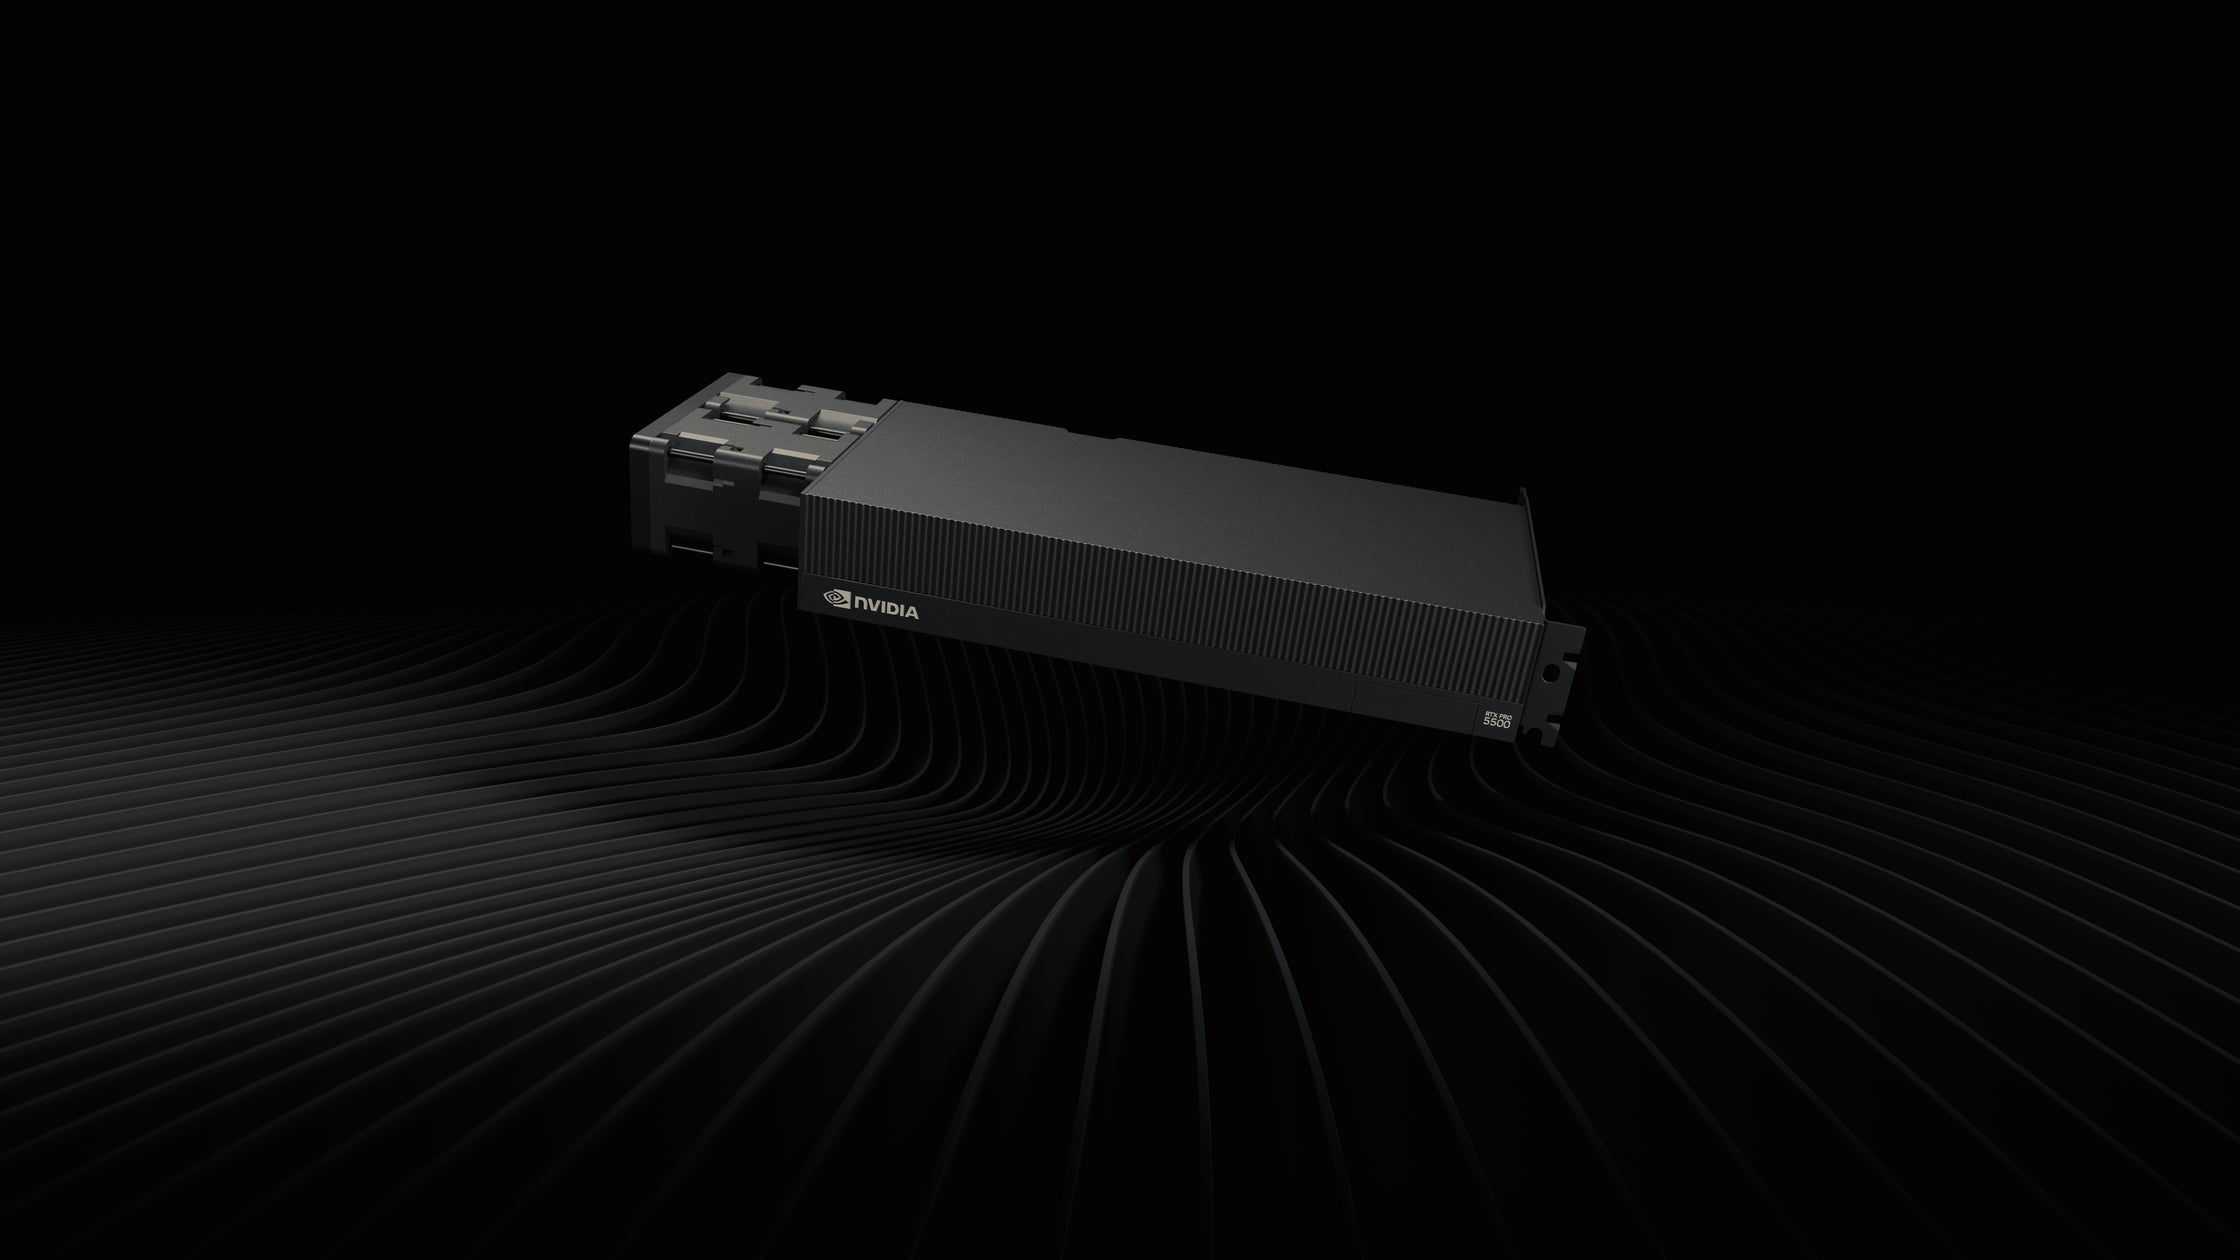
リョーサン菱洋が84 GBのGDDR7メモリを搭載し大規模AIモデルをローカル実行できるNVIDIA RTX PRO 5500 Blackwell Workstation Editionの取り扱いを開始した
JAPAN AIが「JAPAN AI HR」で「AI面接」の提供を開始
Anthropicは11月19日に上場する見通しで、筆者は2026年上半期の売上高が前年同期比1,305%増の163億ドルだったことを挙げ、SpaceXより好意的に見ている