何が起きたか
DeepSeekがキャッシュヒット時に最初のトークンを最大26倍速く返す推論スタック「DeepInfer」をオープンソース化した。
なぜ重要か
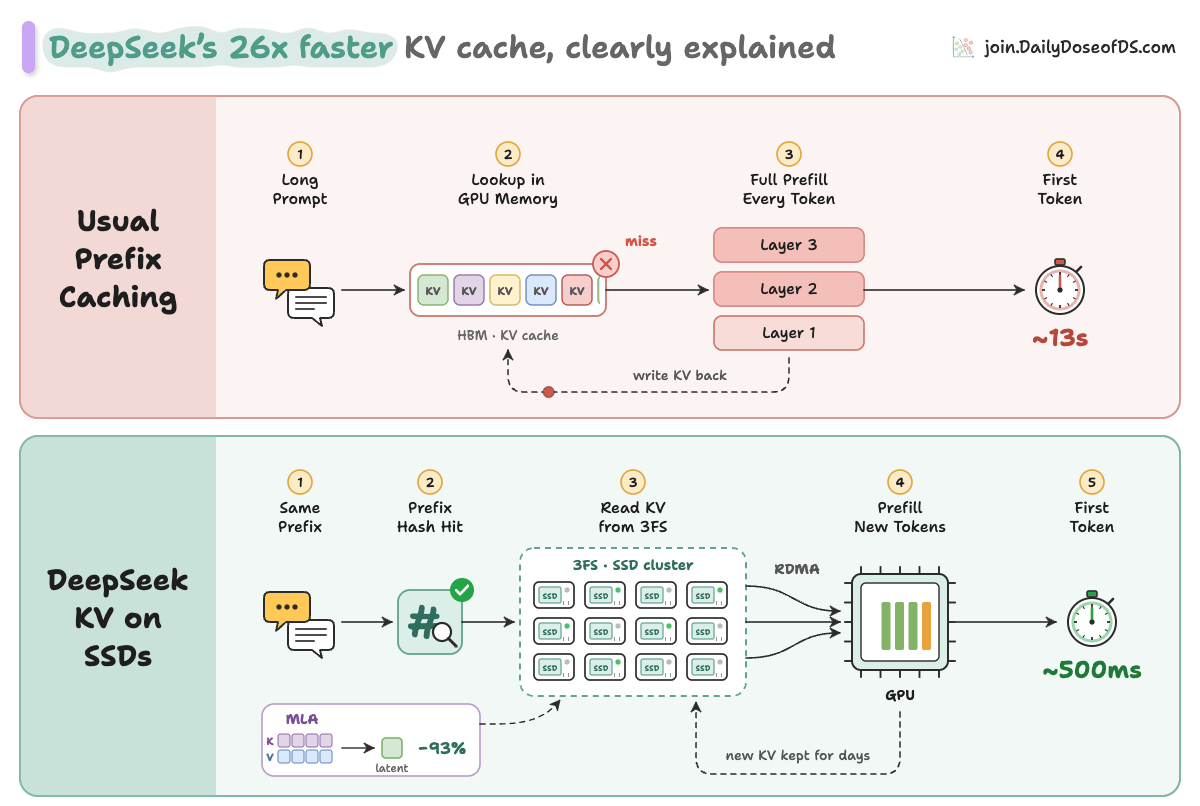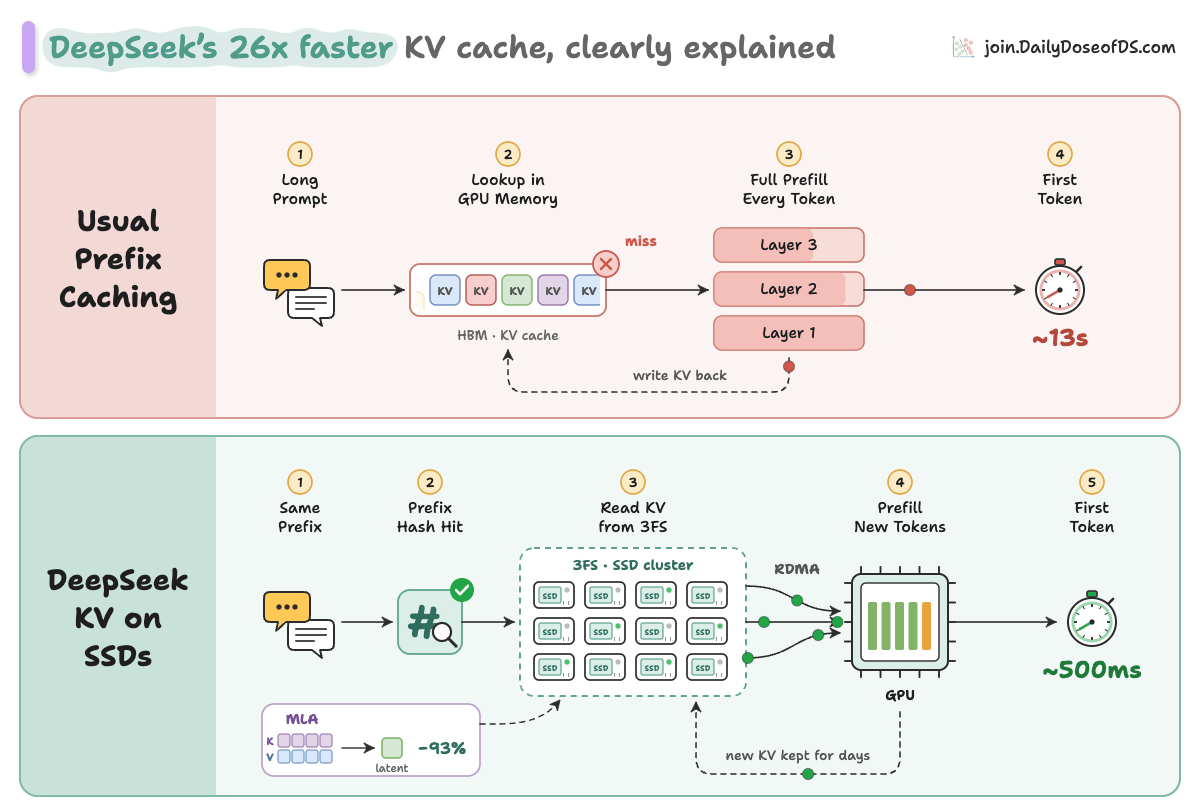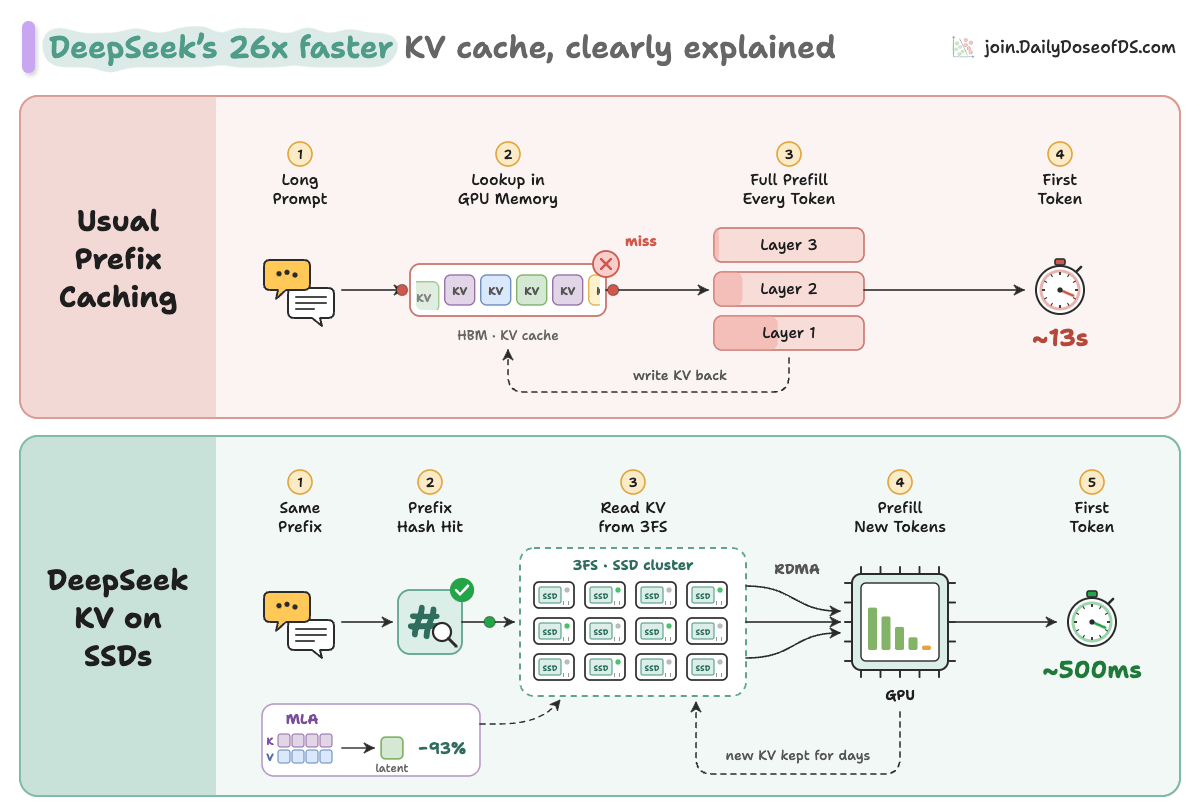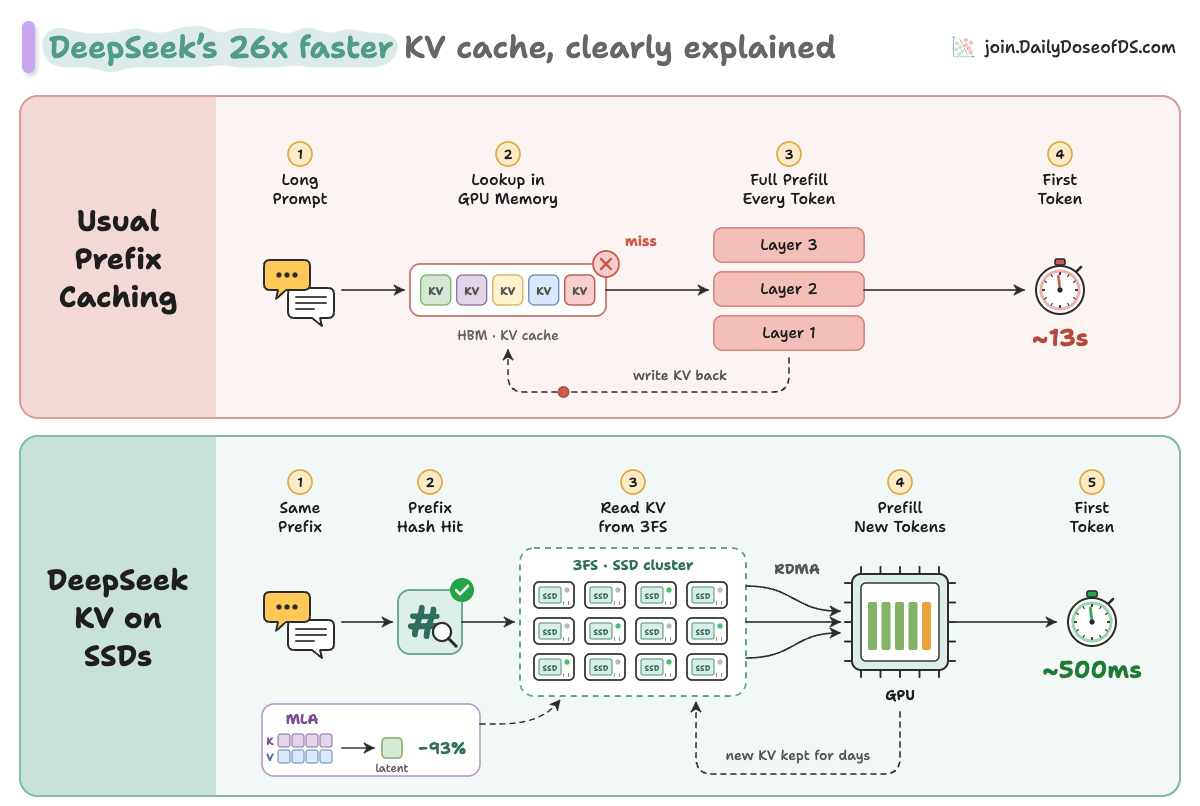
キャッシュが小さくなり、キャッシュ済みプレフィックスを低コストなディスクに保存できるようになった。128Kトークンのプロンプトでキャッシュが効けば最初のトークンを500msで返せる。
こういう要約が、毎朝あなたのメールに届きます。
DeepSeekがDeepInferをオープンソース化したことは、同社がアーキテクチャ上の選択を配信上の優位に変えた道筋を示している。V2論文のMulti-head Latent AttentionはKVキャッシュを従来の67Bモデル比で93.3%削減し、キャッシュヒットのたびに動かすデータを小さくした。この削減があったからこそディスク保存が現実的になった。ヘッドごとのKVキャッシュ全体をディスクから読むと、GPUで再計算するより時間がかかり得るためだ。
もう一つの要素は独自の分散ファイルシステム3FSだ。ファイルを数千台のSSDに分割して置くため、読み出しは多数のドライブから並列に行える。リクエストが届くと、プレフィックスをキャッシュ済みブロックと照合してホストメモリに取り込み、モデルを動かしながらレイヤーごとにGPUへコピーする。プリフィル用の全マシンがキャッシュ済みプレフィックスに到達できるため、リクエストは前回処理したマシンに戻る必要がない。ディスクは安価でもあり、キャッシュ済みプレフィックスを数日間保持できる。DeepInferのドキュメントではエージェントのトラフィックで3日、チャットで7日としている。
価格への効果はdeepseek-flashに見て取れ、現在キャッシュヒットのコストはミスの50分の1だ。API利用者にとっては、システムプロンプトやツール、ドキュメントなど安定した部分を先頭に置くようプロンプトを並べる実利的な動機になる。最初のトークンから完全一致した場合だけがヒットと数えられるからだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
アクセンチュアの従業員が個人のClaude Codeアカウントに国防総省のNIPRNet環境への管理者アクセス権を与えたと情報筋が証言
Google Geminiが本日より全ユーザーのチャットでPDF、Google Docs、Google Sheets、スライド、Markdown、TXT、コードの生成・プレビュー・編集を可能にした
元Palantir幹部のAndy Elder氏とArjun Mathur氏が創業したDreamが、Andreessen Horowitz主導のシード資金1700万ドルを調達しステルスから登場
Mistralは1兆パラメータのMistral Large 4(「Le Chonk」)の重みをHugging Faceと自社APIで公開した
Epsilonのエンジニア50人のAgentic Platformチームが、既存のPlaywrightスイートの上に平易な英語で書けるUIテストを重ね、ui-test-agentとして公開した
Metaは1918年設立のCNIBと提携し、声の収集、ピアトレーニング、製品フィードバック、学習教材の4分野に資金提供