何が起きたか
Zennの解説記事が、拡散モデルがTステップでガウスノイズを加え、U-NetやTransformerを訓練して逆方向に1ステップ分のノイズを予測・除去する仕組みを説明している。
なぜ重要か
訓練は個々の画像ではなく実画像全体の分布をモデルに学ばせるため、生成はランダムシードから始まり尤もらしい画像へ収束する。多様性はここから生まれる。
こういう要約が、毎朝あなたのメールに届きます。
この解説は、拡散モデルをシリーズ既存の作例と同じ系譜に位置づける。超解像と顔復元は1パスで生成するGANを使ったがモード崩壊を起こしうる。物体消去は専用の穴埋めモデルLaMaを使った。拡散はGANと逆のアプローチをとり、ノイズを段階的に除去することで速度を安定性・品質・多様性と引き換えにする。著者はこれが画像生成で拡散が支配的になった理由だと指摘する。
著者が引く重要な区別は、復元と生成が同じ繰り返しのノイズ除去を行いつつ出発点と条件が異なる点だ。復元は元画像へ向かうため、劣化入力に条件付けられた生成の一種となる。一方テキストto画像はランダムノイズから始まりプロンプトに従う。この共通の枠組みにより、同じ仕組みで超解像・インペインティング・text2imgを扱える。著者はControlNetを次の題材になりそうだと述べている。
実用面では、Latent Diffusionが画像を潜在空間に圧縮して計算量を減らし、コンシューマーGPUで動く程度にした。Classifier-Free Guidanceはプロンプトへの追従性を高めるが、強めすぎると不自然な結果になる。著者はエンジンと製品も区別し、Stable Diffusion 3とFluxはFlow Matchingを用いたDiTを使うこと、DALL·E 1は拡散ではなく自己回帰だったこと、MidjourneyとFireflyは拡散ベースと推測されるが非公開であることを挙げている。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
開発者がDesign Compassを公開した

開発者はopenclip-gemmaをPyPIで公開した
kaazu氏がMITライセンスのブラウザツールvrm-charsheetを公開
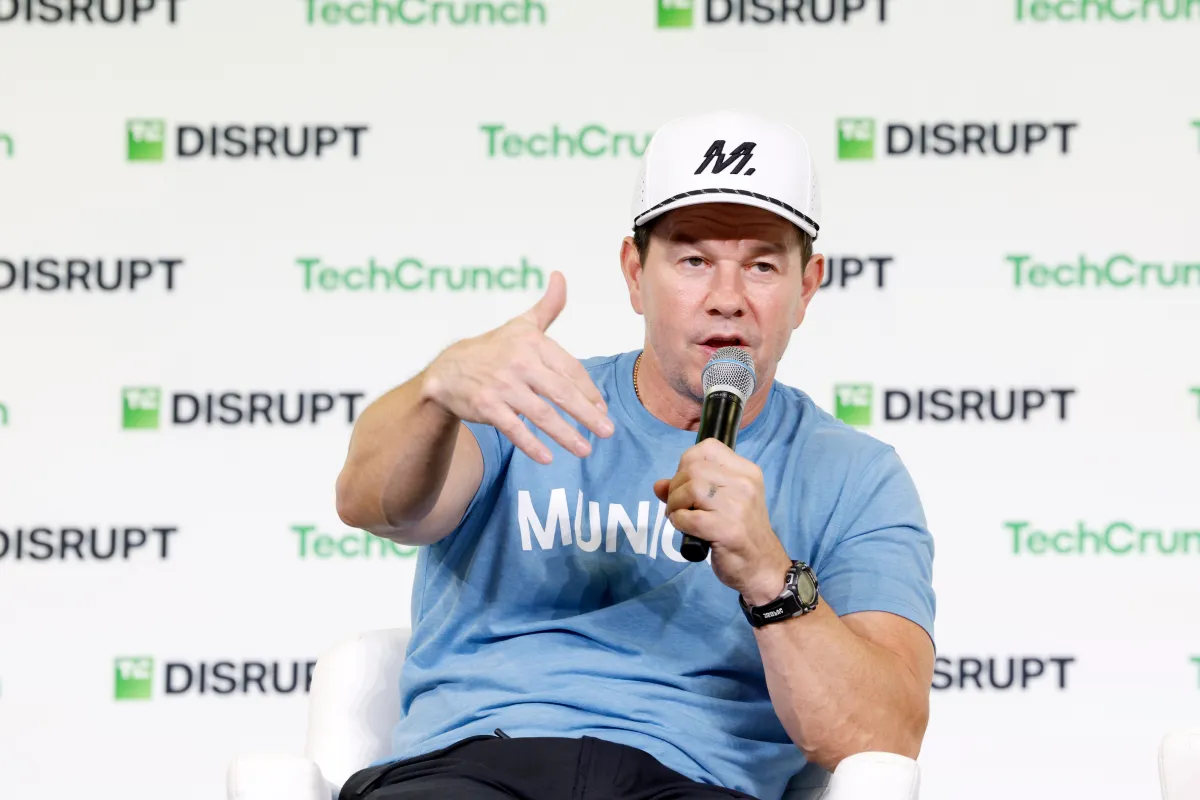
TechCrunch Disruptでマーク・ウォールバーグは、製作中のピート・ローズ伝記映画の球場の設定をAIで強化する可能性があると述べ、自身の遺産を継ぐAIの似姿にも前向きな姿勢を示した
政府が2026年8月25日に公表した「プリンシプル・コード」は、AI開発者と提供者にモデルと学習データの開示、利用者からの照会対応を求める
AI生成モデルのネットワークがコメディアンのネタを使い、OnlyFansやFanvueのアカウントへ閲覧者を誘導している