何が起きたか
AWS DevOpsタスク45件の新オープンソースベンチマークCloudOpsBenchで、Claude Fable 5.1が60%、GPT-6 Astraが53%を解決したとミシガン大学のチームが発表した。
なぜ重要か
チームによれば主な問題は知識の不足ではなく推論であり、このスコアはエージェントがタスクの範囲をどう判断しサービスを確認するかを反映しており、知識量を測るものではない。
誰に効くかクラウド運用向けAIエージェントを評価する企業のDevOpsおよびプラットフォームチームは、エージェントがサービスの修正、リソースの削除、アクセス制限、アップデートの展開、プロジェクトの廃止を安全に実行できるかを試せる、公開された再現可能なベンチマークを手に入れた。
こういう要約が、毎朝あなたのメールに届きます。
CloudOpsBenchは、企業がクラウドインフラの日常運用をAIエージェントに任せられるかを検討する時期に登場した。経験豊富なDevOpsエンジニアが構築し、バージョン1.0にはAWS上の45タスクを収録。すべてのタスクが実際のAWSクラウドとエミュレータで同一に実行される。この設計は再現性の面で重要で、テストのたびに実インフラを用意しなくてもエージェントの挙動を比較できる。
結果は最高モデルと全タスク完了との間に明確な差を示す。Claude Fable 5.1はタスクの60%を解決し、GPT-6 Astraは53%だった。ミシガン大学のAng Chen率いるチームによれば、主な問題は知識の不足ではなく推論だ。失敗の約80%はエージェントがタスクの範囲を誤認したり、関連するサービスをすべて確認しなかったり、早すぎる段階で停止したりすることで起きる。誤りの約20%は誤った操作で、インフラに取り返しのつかない影響を及ぼすものもある。この内訳は、難しいのが何をすべきかの retrieval ではなく、どこまで進め、害を及ぼす前にいつ止めるかの判断であることを示唆する。
プロジェクトはGitHub上でApache 2.0ライセンスの下に公開され、詳細な失敗分析も利用できる。GCP、Azure、OCI向けの拡張も計画されており、ベンチマークはAWSの枠を超えて広がる見通しだ。現時点では、公開された失敗の内訳により、DevOpsチームはエージェントが本番クラウド運用に適するかを評価する際、スコアを具体的に解釈できる。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
AI Shiftとアシストが2026年11月18日12時~13時、Claudeをテーマにガバナンスと業務活用事例を扱う無料オンラインウェビナーを共催する
Tencent Holdings Ltd.がcomputer-use機能と100万トークンのコンテキストを備えた大規模言語モデルHy4を発表
グーグルは、K-12向けソフトを使う学校に対し、GeminiなどのAIツールへのオプトインを求め、応じなければ生徒は検索にアクセスできず、利用不可という学校からのメッセージだけが表示されると述べた
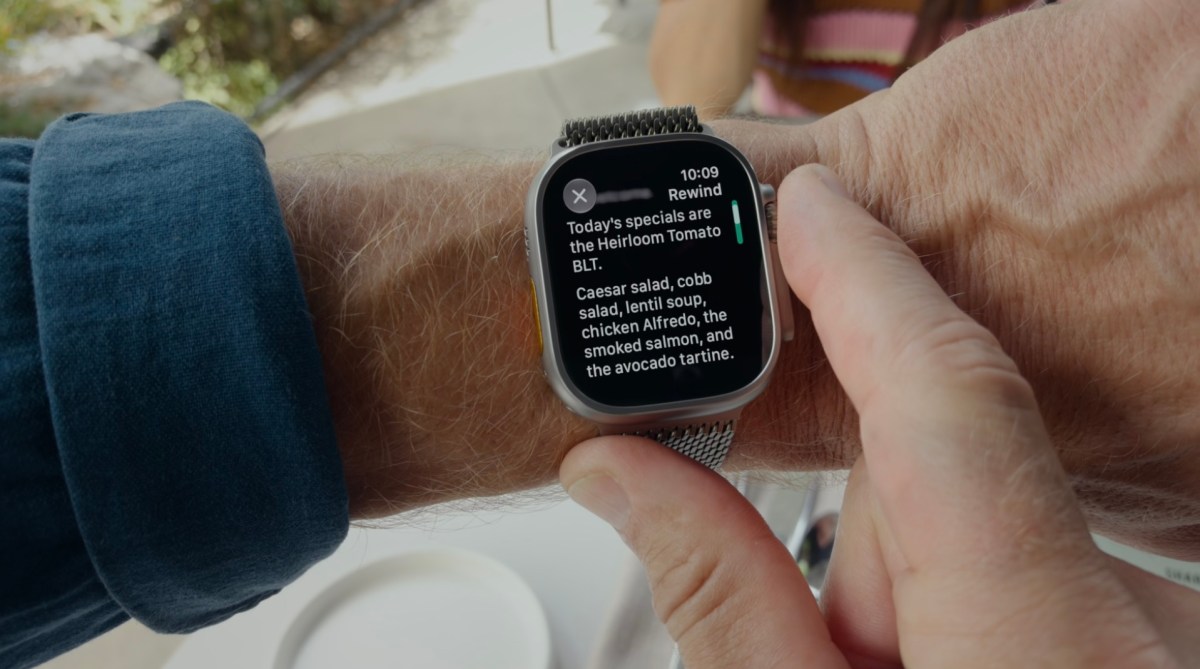
AppleはApple Watch周辺の会話を録音・要約するSiri RecapsとLive Rewind、さらに音・楽曲検出をiOS 27.3とwatchOS 27.3の開発者向けベータで展開した
TechCrunchのEquityでHugging FaceのIrene Solaiman氏が、オープンなフロンティアモデル構築にはNvidiaのような資金力のある企業が米国に必要かもしれないと語った
AWSはAmazon QuickにSmart Approvalsを導入した