何が起きたか
Anthropic の新モデル Claude Fable 5 が FrontierMath ベンチマークで高い精度を記録しました。最難関のティア4で88%の正答率に達し、同じティアで約75%の GPT-5.5 を大きく上回っています。このモデルは Epoch AI の標準テストで最大推論努力設定で評価されました。
なぜ重要か
Anthropic のモデルが数学問題を解く能力で急速に向上しています。前モデルの Opus 4.5 は2026年初頭にティア4で10%未満だったのに対し、わずかな期間で大きく改善されました。FrontierMath はAI の数学推論能力を測る最難関ベンチマークとして広く認識されており、Fable 5 の成績はこのベンチマークでの実力が本物であることを示唆しています。
注目点
これらの数学能力の向上は単なるベンチマーク上の改善ではなく、実例としても表れています。最近、OpenAI のモデルが長年未解決だった Erdős 問題を解き、Claude Mythos も同じく解いています。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
kickflowはシリーズAで約10.6億円を調達
Anthropicは11月19日に上場する見通しで、筆者は2026年上半期の売上高が前年同期比1,305%増の163億ドルだったことを挙げ、SpaceXより好意的に見ている
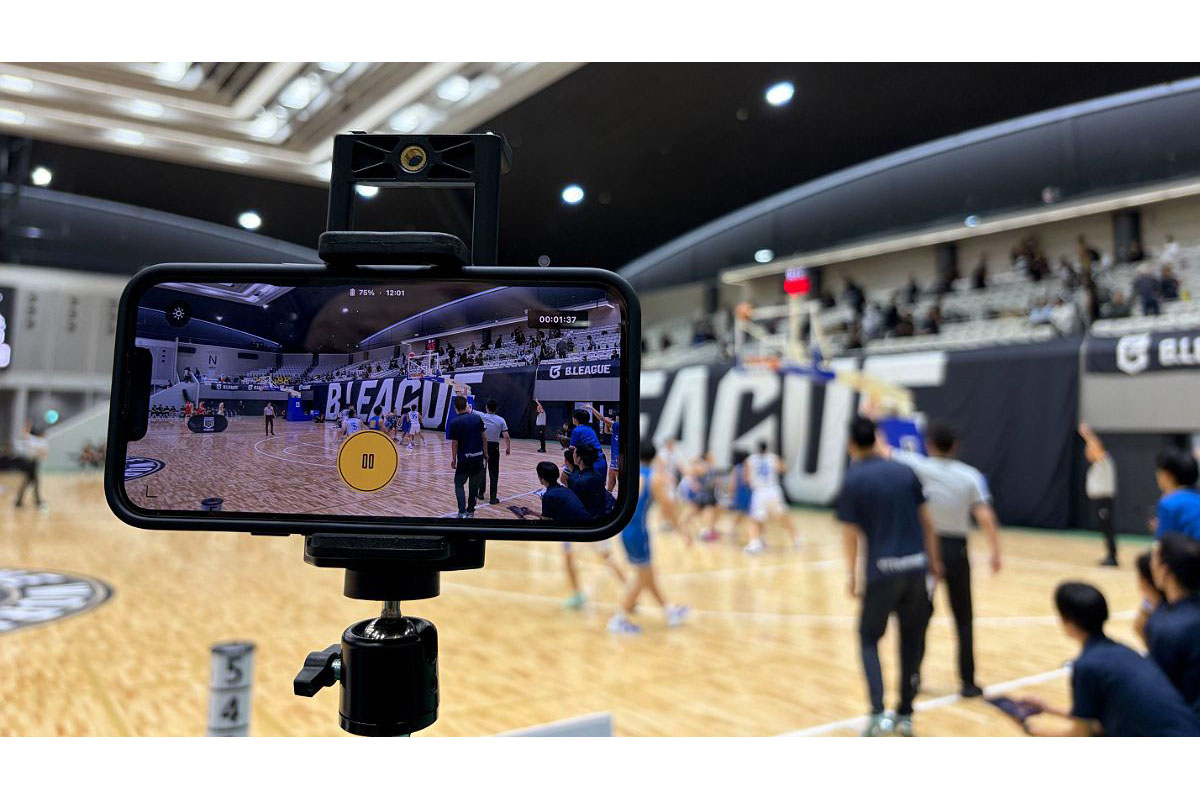
ソフトバンクは日本バスケットボール協会と連携し、米Built Different AIのHOOPERアプリを国内大会で実証
Microsoft Ignite 2026でCEOのSatya Nadella氏はCopilotを「仕事の新しいOS」と呼び、AIチャットやエージェントへの委任、アプリ開発、自律的なタスク実行を統合すると述べた
Docker Composeの閉鎖ラボでLlama 3.1 8Bエージェントは約5.7秒でOpenCanaryハニーポットに到達したが、ダミー認証情報12個のファイルサーバーには触れず発見数は12個中0個だった
ForceHarnessはロボットハードウェアとモデルAPIの間に位置し、生の力覚トレースを不確実性推定付きの物理量に変換してツール呼び出し結果として凍結モデルに返す


