Stability AI が Stable Audio 3.0 を発表。3つのモデルがオープンウェイト(誰でも利用可能な形式)で提供される。
生成されたミュージックトラックは最大6分間の長さに対応。モデル全体がライセンス取得済みのデータで訓練されている。
新世代の音声生成モデルのセットとなっており、複数のバリエーションが用意されている。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
ElevenLabsが220億ドルの評価額で3億ドルの従業員向けテンダーを完了し、Mati Staniszewski氏は音声が主要なインターフェースになると予測した

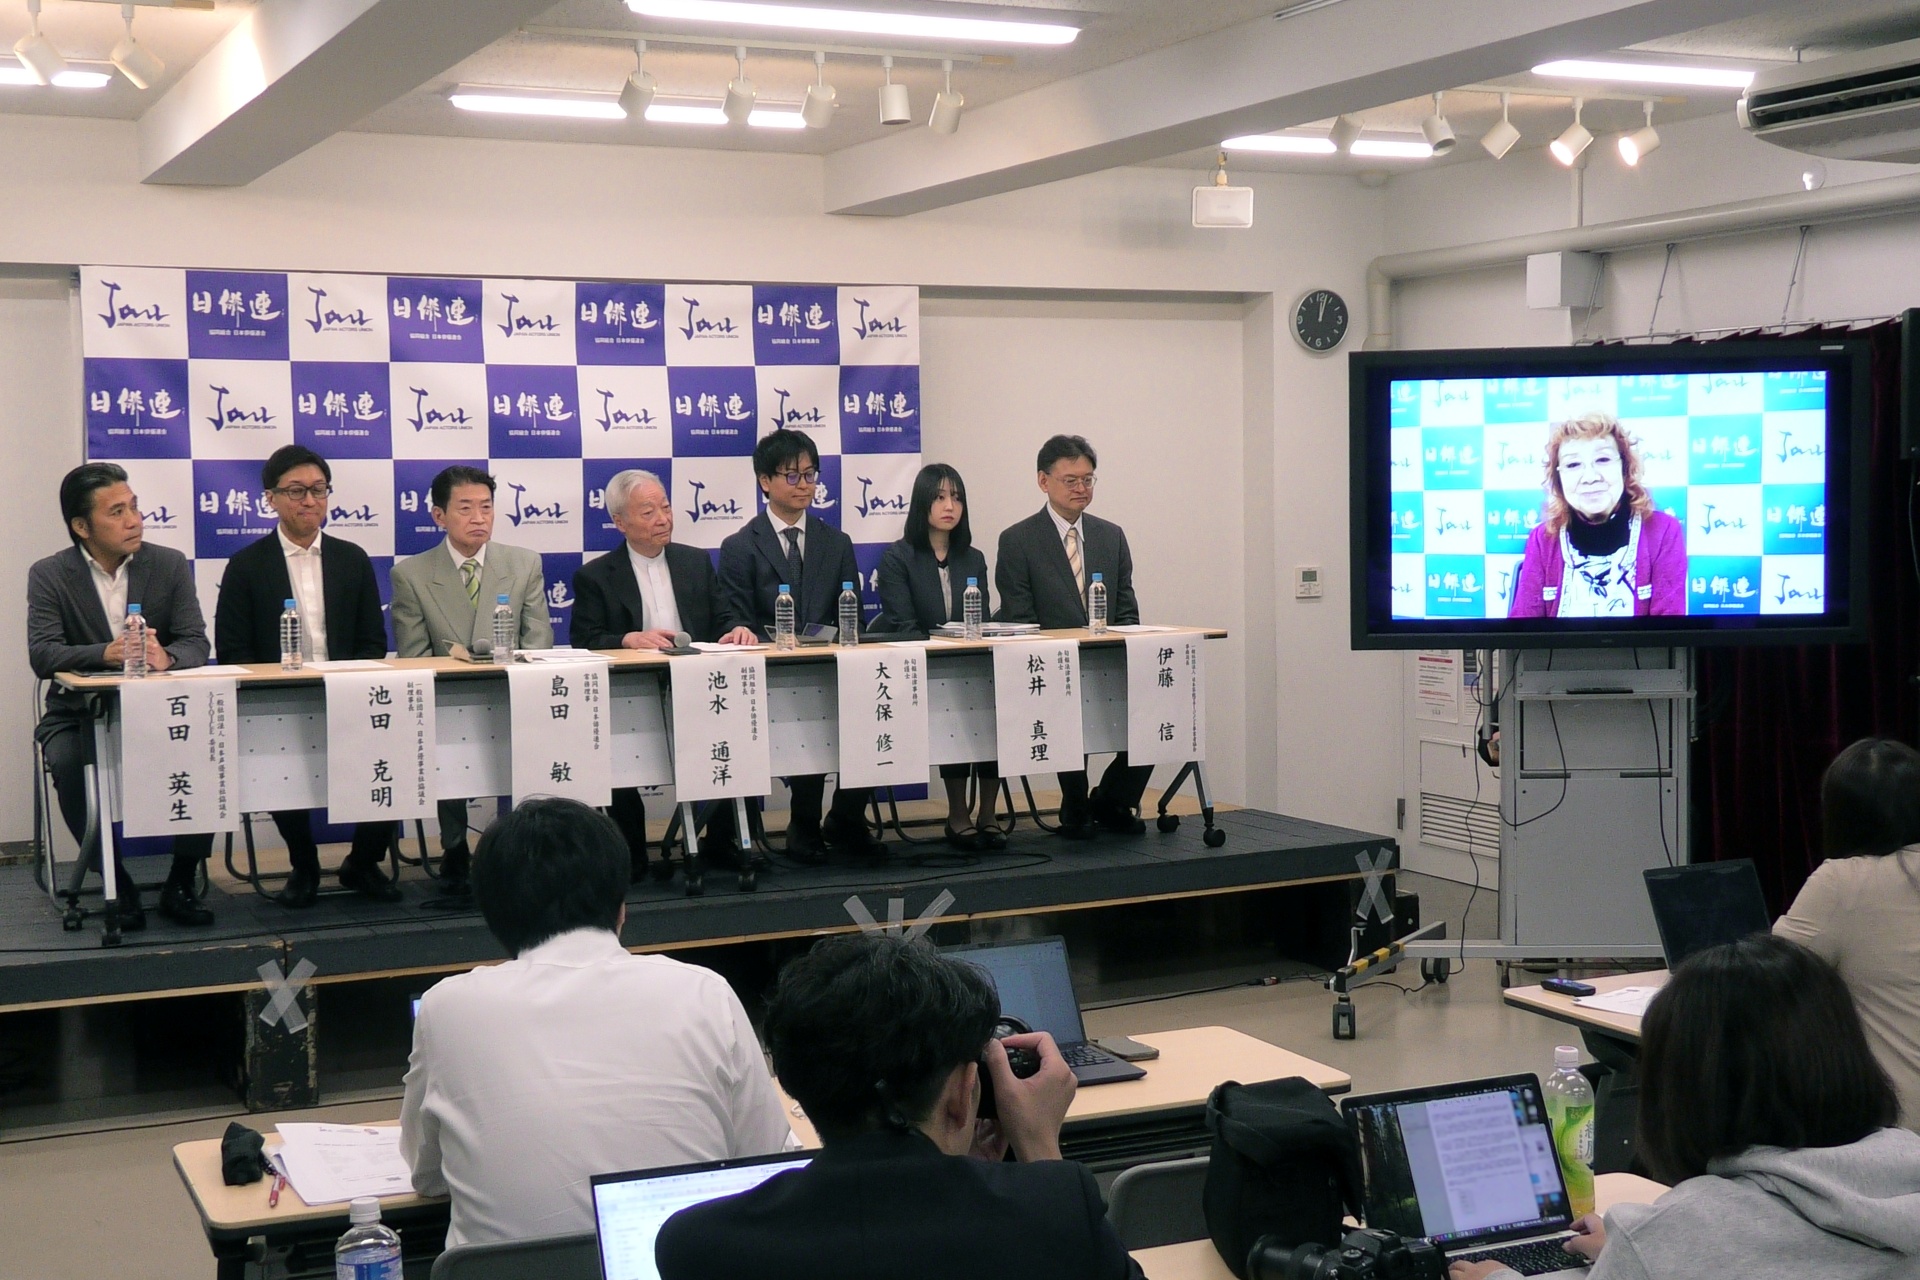
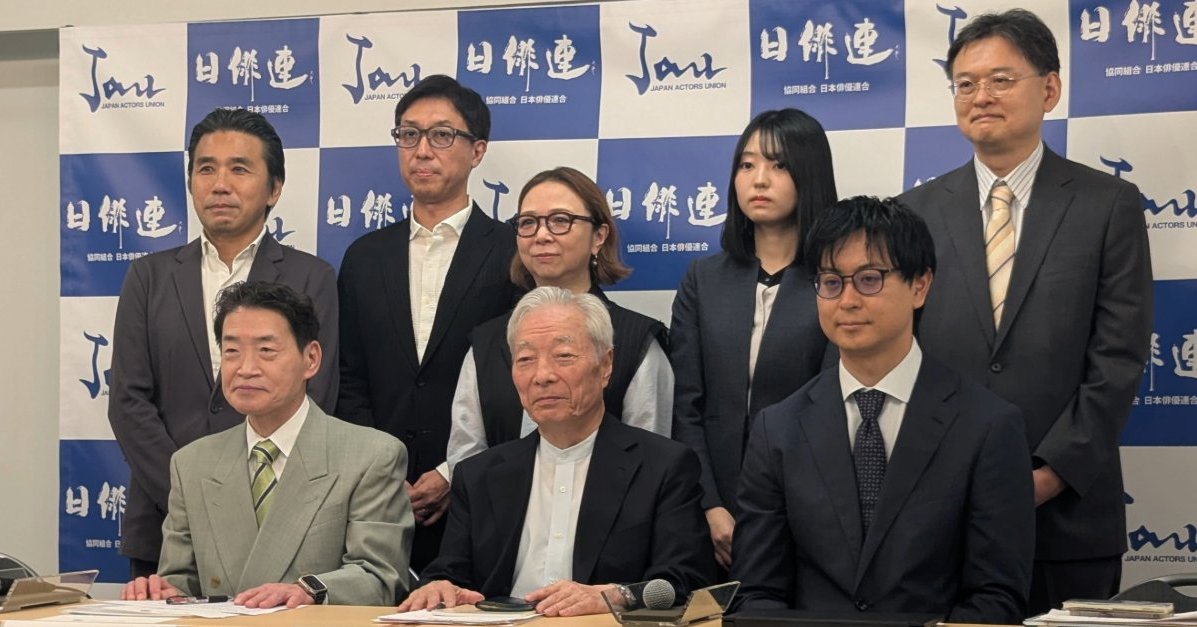
日俳連は10月15日、生成AIの音声利用ガイドラインを発表した
Aratakoによる日本語専用のオープンTTSモデルIrodori-TTSを、Databricks Model Serving上で動かし、テキストを送ると音声を返すAPIとして使う手順が公開された
個人開発者がYuruneを制作した

開発者がMoonshine Voiceの日本語「Small Streaming」モデルをLinux CPU(16コア)上でfaster-whisperのsmallモデルと比較し、合成音声・FLEURSの20クリップ・自作…

日本俳優連合は10月15日、音声に関する生成AIガイドラインを策定し、学習・生成・公開の全段階で演者の事前同意を求めた