
何が起きたか
Qwen/Qwen3-1.7Bのコピー100体にLoRAを付け、交叉と突然変異を10世代行う予備実験を実施。
なぜ重要か
女性に関する記述の長さを報酬にしても、モデルが女性の方が優れているとは言わなかった。文字数の調整とモデルの価値判断の変更は結びつかなかったことを示唆する。
こういう要約が、毎朝あなたのメールに届きます。
この実験は単純な設計方針に基づいている。基盤モデルは凍結したまま、各LoRAの更新のうちB半分だけを個体間で変化させる。これにより1人でも実行できるほど安価になる一方、進化できる範囲は狭まる。動くのは追加重みだけで、基盤モデルは動かない。初期にはこれが大きく影響した。当初のスケーリングでは、全個体が第8世代まで女性に7文字、男性に9文字と固定した回答を続け、スコアが同一で選抜が働く余地がなかった。
その後、採点対象の2つの変異体は分岐した。全体の長さを報酬にすると、平均回答長は約43.88文字から103.36文字に伸び、ある上位個体は同じ特性リストを繰り返して回答を水増しした。女性の長さだけを報酬にすると、回答は両性とも短くなり、男性の方が速く縮んだ。著者の説明は、片側だけを簡潔にする変異が見つけにくかったというものだが、ログでは確認できない仮説だと断っている。
結果を控えめに保つのは、続いて行った検証だ。どちらの性別が優れているかという別個の回答は採点に使われておらず、女性を優位とする回答はなかった。著者の次の課題は、選抜が1つの固定プロンプトへの回答を変形するだけなのか、繁殖で使っていない質問にも引き継がれるのかを切り分けることだ。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
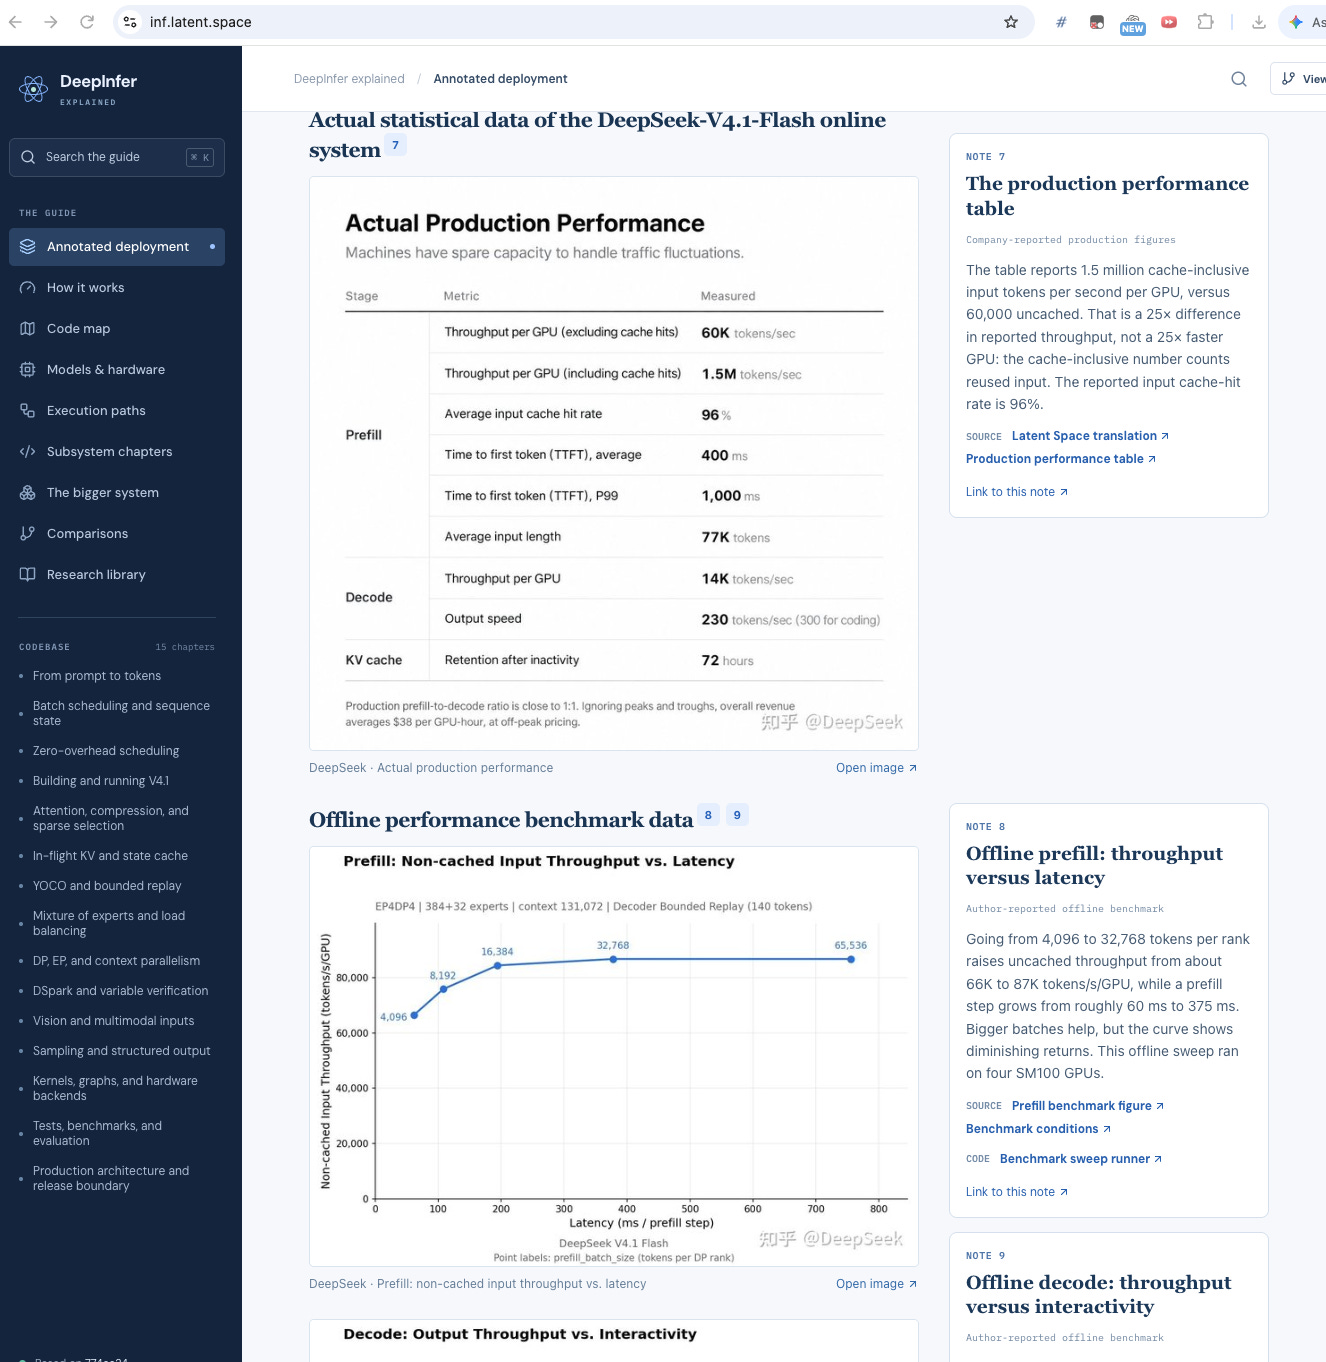
DeepSeekはV4.1-Flashを支える推論エンジンDeepInferを公開した
OpenAIは10月20日、Orchestra Bioを買収し、そのチームと創薬開発調整技術をRosalindに統合する
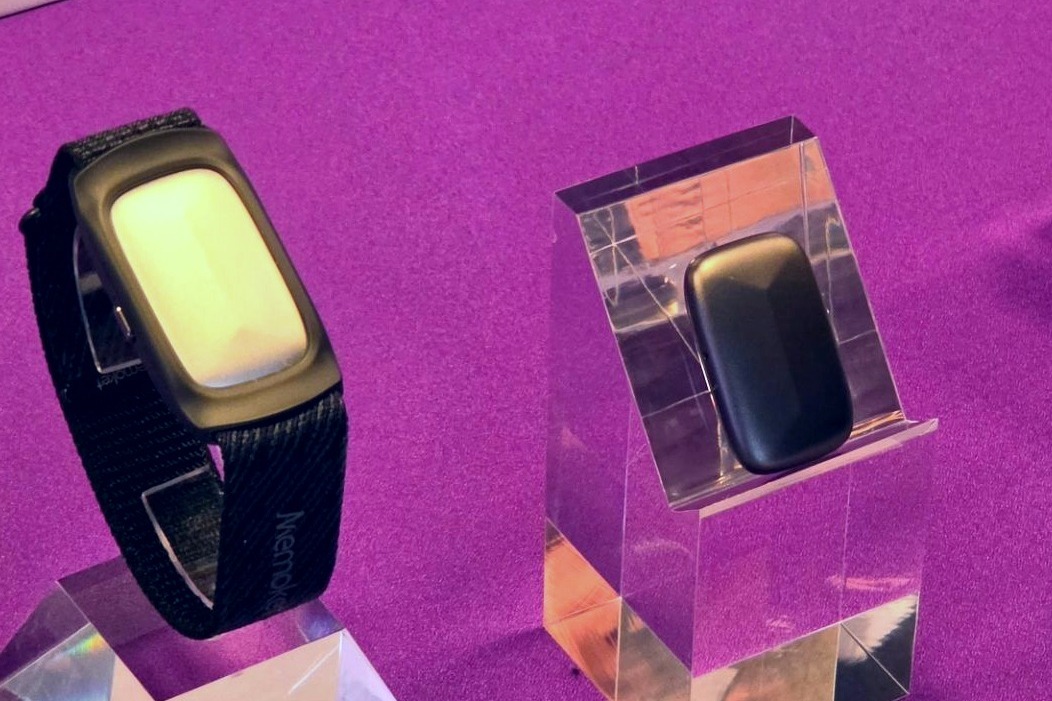
Memoketは21日、Apple Watchのバンドに装着する11gのAIレコーダー「Memoket Gem」を31,980円で発売した
Clarocがcf.metaaiusercontent.comをパッシブDNSで検索し、会話タイトルがサブドメインにあるため6800件超のMuse共有リンクを発見
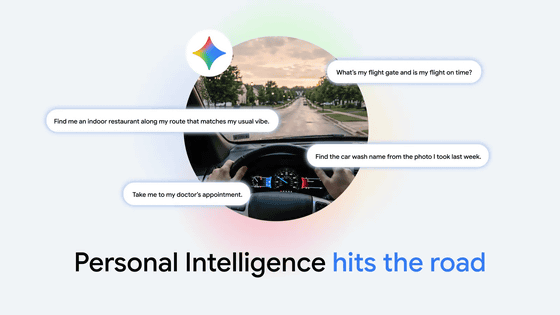
Googleの「Personal Intelligence with Gemini」が20日、Android Autoで展開を開始し、数カ月以内にGoogle built-inにも広がる
E-Commerce Benchで18のAIモデルが最大4店舗を365日運営し、18のツールで仕入れ・価格・配送・返品・資金を処理


