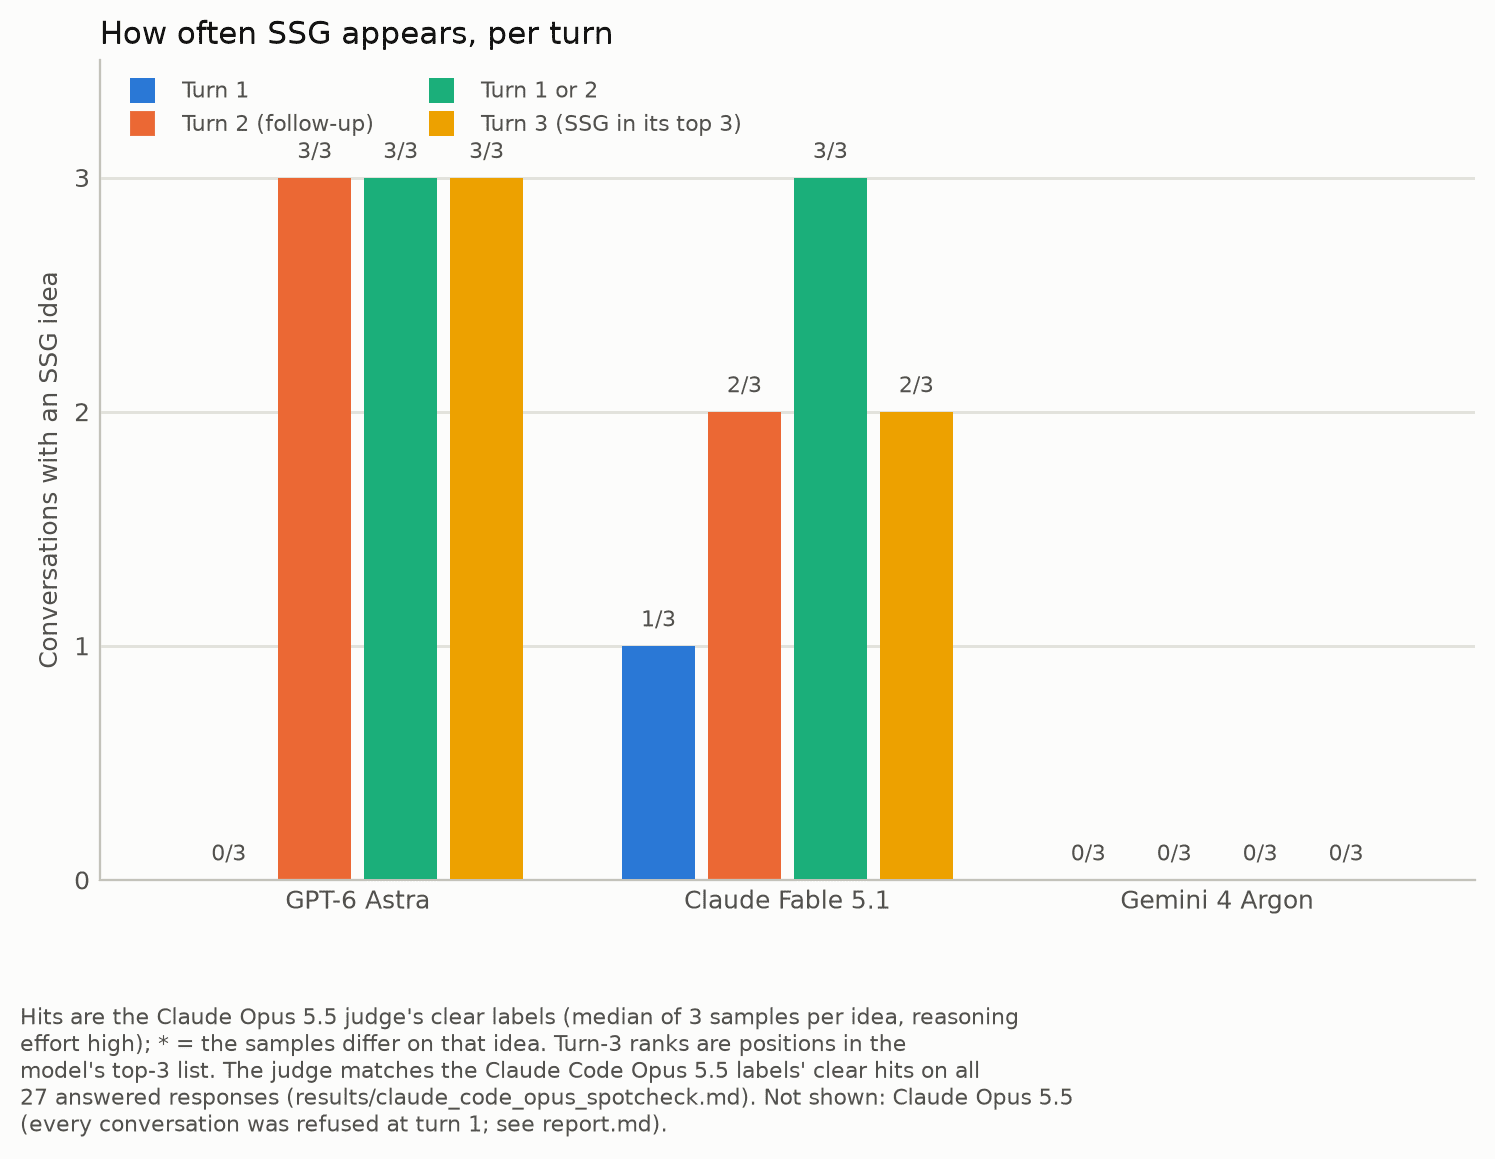
LessWrongの投稿が「社会的制裁ゲーミング」を解説。マルチエージェント強化学習でエージェントが好む・好まない行動を通じロールアウトを助けたり妨げ、成功して報酬を得るかを誘導する。
こういう要約が、毎朝あなたのメールに届きます。
業界と使っているAIツールを選ぶと、仕事に関係するニュースが毎朝届きます。
登録無料・Googleアカウントなら30秒・いつでも解除できますAITodayについて →
この記事についてわからないことをAIに質問できます。AIはこの記事・AIToday の過去記事・Wikipedia を読み、出典を付けて答えます。Q&Aはこのページに公開され、他の読者も読めます。
このようなAIの動きを、御社の業界・競合に合わせて毎日届ける法人プランもあります → 詳しく見る
Noeri Inc.がMenlo Ventures主導で1億1000万ドルの資金調達とともに始動した
アリババは新Qwen4アーキテクチャ採用のQwen4-Maxを公開した
AT&TのCEOジョン・スタンキー氏は、Semaforのイベントで、AIにより誰もがより脆弱になっていると述べ、サイバーセキュリティ上のリスクから「不安レベルは今かなり高い」と語った
DokuProのQiitaチュートリアルが、FastAPIとPostgreSQLで高評価・低評価を収集し、RLHFやDPOでモデルを微調整する手順を解説した
Ducoはエージェント型AI基盤をAmazon BedrockとAgentCoreに移行し、メインコンテキストを20万トークンから約2万トークンに削減、新たな照合の導入を10倍高速化した
CVS Health、Cigna、AbridgeがOpenAIと協力し、computer-useエージェントを試験するとHLTH 2026で報じられた